
 Помощник сценариста▸
 AI Приложения
 AI Новости
OpenManus-RL: проект с открытым кодом для улучшения рассуждений и принятия решений агентами LLM
小编 ·

OpenManus-RL: проект с открытым кодом для улучшения рассуждений и принятия решений агентами LLM
Что такое OpenManus-RL?
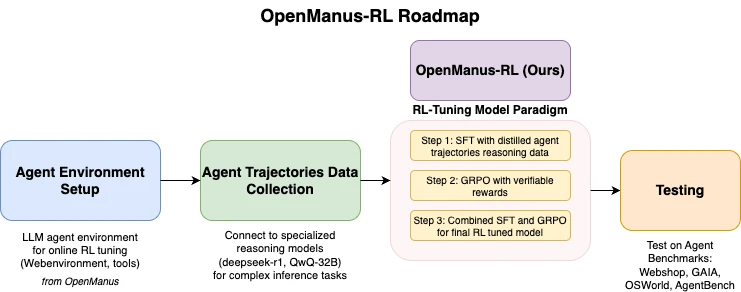
OpenManus-RL — это проект с открытым исходным кодом, совместно разработанный UIUC-Ulab и командой OpenManus из сообщества MetaGPT. Он позволяет улучшать способности к рассуждению и принятию решений у агентов на основе больших языковых моделей (LLM) с помощью технологии обучения с подкреплением RL. Проект основан на опыте таких передовых моделей, как Deepseek-R1 и QwQ-32B, и исследует новые методы тонкой настройки для повышения производительности агентов в сложных задачах. Основные функции OpenManus-RL включают создание среды для агентов, сбор данных о траекториях, поддержку тонкой настройки с помощью обучения с подкреплением, а также интеграцию бенчмарков. Он также объединяет множество стратегий обучения с подкреплением, таких как Tree-of-Thoughts и Monte Carlo Tree Search (поиск по дереву Монте-Карло), для улучшения способностей агентов к рассуждению.
Функциональные особенности OpenManus-RL
Создание среды для агентов: предоставляет инструменты для настройки среды агентов с онлайн-тонкой настройкой на основе обучения с подкреплением (RL), что позволяет пользователям адаптировать среду агентов под конкретные задачи.
Сбор данных о траекториях: возможность подключения моделей Deepseek-R1, QwQ-32B и других для сбора данных о поведении в сложных задачах, обеспечивая поддержку данными для последующей тонкой настройки.
Поддержка тонкой настройки RL: поддерживает методы обучения с подкреплением для настройки поведения агентов; пользователи могут оптимизировать поведение агентов, например, задавая функции вознаграждения.
Интеграция бенчмарков: встроенные тестовые среды WebShop, GaiA, OSWorld, AgentBench и другие, что позволяет пользователям проводить количественную оценку производительности агентов.
Разнообразные стратегии: интегрированы стратегии обучения с подкреплением, такие как Tree-of-Thoughts и Monte Carlo Tree Search, что повышает способность агентов к рассуждению в задачах долгосрочного планирования.
Совместная работа сообщества: пользователи могут вносить код, наборы данных и другое; активные участники могут стать соавторами публикаций, что способствует совместной разработке сообщества.
Публикация результатов в реальном времени: динамическое обновление для отображения процесса и результатов тонкой настройки RL, что позволяет пользователям быть в курсе последних достижений проекта.
Сценарии применения OpenManus-RL
Принятие решений о покупках: оптимизация работы агентов в задачах принятия решений о покупках с помощью настраиваемой среды агентов, например, повышение успешности покупок в WebShop.
Анализ сложных задач: анализ производительности агентов в сложных задачах, таких как показатели успешности и времени отклика в бенчмарках GAIA, OSWorld и других, помогающий разработчикам сравнивать производительность моделей.
Оптимизация мультимодальных задач: оптимизация поведения агентов в мультимодальных средах задач, таких как OSWorld, для повышения их производительности в мультимодальных задачах.
Задачи долгосрочного планирования: использование интегрированных разнообразных стратегий для улучшения способности агентов к рассуждению в задачах долгосрочного планирования, например, оптимизация поведения агентов с помощью стратегии Tree-of-Thoughts.
Установка OpenManus-RL
1. Создание среды Conda: во избежание конфликтов зависимостей рекомендуется создать среду с помощью Conda. Команды следующие:
conda create -n openmanus-rl python=3.10
conda activate openmanus-rl
2. Клонирование проекта: убедитесь, что Git установлен, затем клонируйте проект и перейдите в его каталог. Команды следующие:
git clone https://github.com/OpenManus/OpenManus-RL.git
cd OpenManus-RL
3. Установка зависимостей: выполните следующую команду в корневом каталоге проекта для установки зависимостей. Если загрузка идёт медленно, можно использовать китайское зеркало:
pip install -r requirements.txt
или
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
Для инструментов визуализации необходимо установить дополнительно:
pip install matplotlib numpy
4. Настройка модели и набора данных:
Контролируемая тонкая настройка (SFT): укажите модель и набор данных. Команда следующая:
python -m openmanus_rl.sft --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL
Тонкая настройка с обучением с подкреплением (GRPO): настройте функцию вознаграждения. Команда следующая:
python -m openmanus_rl.grpo --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL-GRPO --reward_funcs accuracy format tag_count
Набор данных можно получить на Huggingface.
5. Запуск проекта:
Запуск SFT на одном GPU:
python -m openmanus_rl.sft --output_dir data/sft-output
Запуск GRPO на нескольких GPU (требуется настройка zero3.yaml):
accelerate launch --config_file=configs/accelerate_configs/zero3.yaml openmanus_rl/grpo.py --output_dir data/grpo-output
Использование OpenManus-RL
1. Создание среды для агента:
Выполните python -m openmanus_rl.sft для генерации базовой среды.
Измените файл конфигурации (например, цель задачи или функцию вознаграждения).
Выполните python -m openmanus_rl.grpo для начала тонкой настройки.
2. Сбор данных и тестирование:
Настройка модели (например, Deepseek-R1): python -m openmanus_rl.grpo --model_name_or_path Deepseek-R1
Запуск тестирования: --benchmark GAIA, результаты сохраняются в каталог data/.
3. Операции тонкой настройки RL:
Запуск режима GRPO: python -m openmanus_rl.grpo --reward_funcs accuracy
Просмотрите журналы обучения, модель сохраняется в data/grpo-output.
Адрес репозитория на GitHub: https://github.com/OpenManus/OpenManus-RL









