
 Помощник сценариста▸
 AI Приложения
 AI Новости
SpeakerKit: быстрое и точное распознавание разных говорящих в аудио
小编 ·

SpeakerKit: быстрое и точное распознавание разных говорящих в аудио
Что такое SpeakerKit?
SpeakerKit — это инструмент диаризации (распознавания говорящих) на устройстве, разработанный компанией Argmax, который позволяет быстро и эффективно распознавать разных говорящих в аудио. Он работает в связке с WhisperKit (инструментом транскрибирования аудио) и способен создавать транскрипты с метками говорящих. Подходит для приложений, которым требуется быстрое и точное распознавание говорящих в аудио.
Основные особенности SpeakerKit
Скорость:
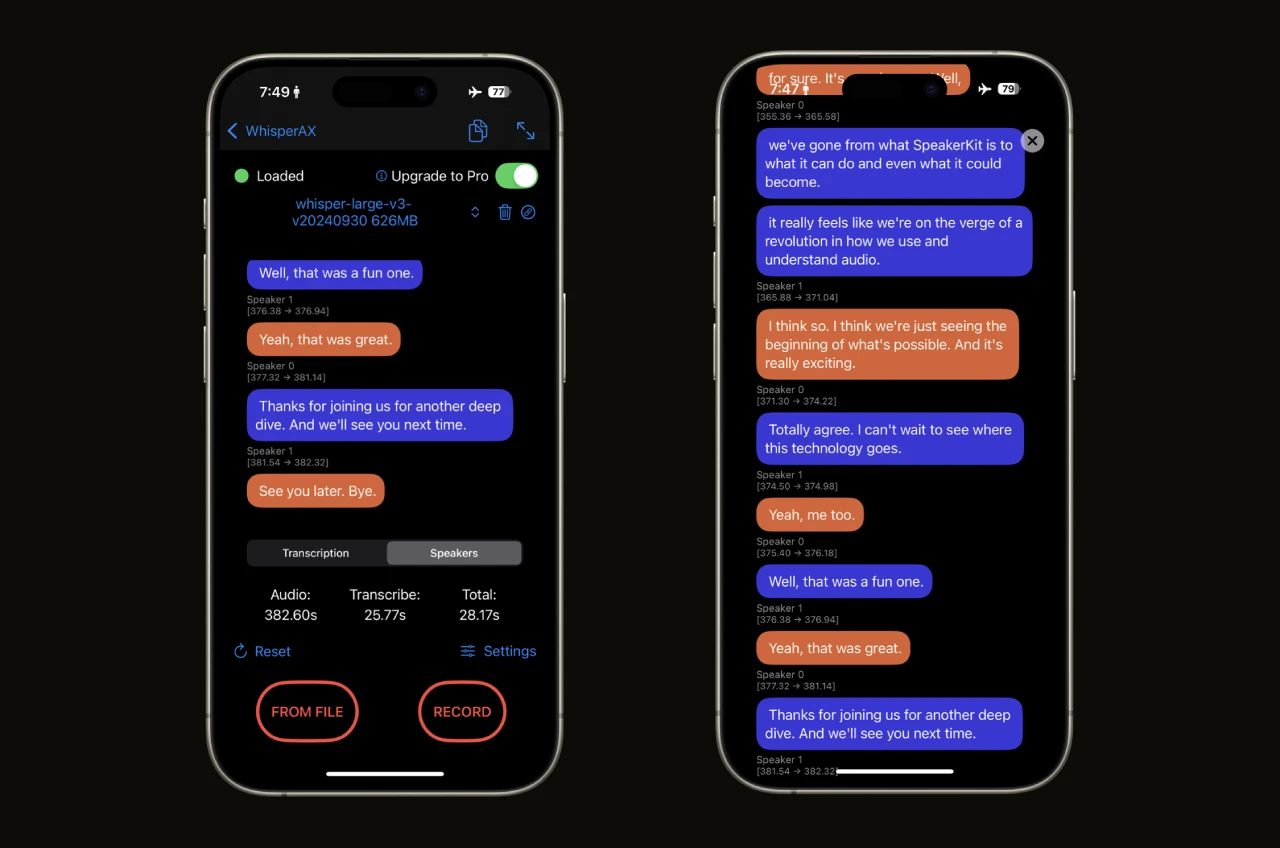
При обработке 4-минутного аудио на iPhone SpeakerKit выполняет распознавание говорящих всего примерно за 1 секунду, значительно превосходя по скорости другие аналогичные системы.
При совместном использовании с WhisperKit общее время транскрибирования и распознавания составляет всего 25 секунд.
Качество:
Уровень ошибок SpeakerKit сопоставим с ведущими отраслевыми системами (такими как Pyannote), несмотря на многократное увеличение скорости.
Размер:
Общий размер составляет около 10 МБ, что упрощает интеграцию в приложения и обеспечивает быструю загрузку.
Совместимость:
Поддерживает устройства с iOS 16 и macOS 13 и более новыми версиями.
Поддержка Android находится в разработке.
Модульность:
SpeakerKit может работать совместно с WhisperKit для создания транскриптов с метками говорящих, а также интегрироваться с другими движками транскрибирования, обеспечивая большую гибкость по сравнению с серверными API.
Тестирование
Argmax разработал Python-пакет под названием SDBench для стандартизированного тестирования производительности систем распознавания говорящих на 13 широко используемых наборах данных. Код SDBench будет открытым, а соответствующая научная статья будет опубликована в апреле 2025 года.
Планы на будущее
Оптимизация качества транскрибирования:В настоящее время качество автономного распознавания говорящих в SpeakerKit уже достигло ведущего отраслевого уровня (измеряется по DER). Следующим шагом команда оптимизирует совместную работу с WhisperKit, чтобы повысить качество транскриптов с метками говорящих (измеряется по WDER).
Функция распознавания говорящих:SpeakerKit получит новую функцию, позволяющую извлекать голосовые отпечатки говорящих и распознавать их в новых контекстах.
Подробнее:https://www.argmaxinc.com/blog/speakerkit
HuggingFace:https://huggingface.co/argmaxinc/speakerkit-pro









