
 Помощник сценариста▸
 AI Приложения
 AI Новости
HunyuanVideo-I2V: фреймворк генерации видео из изображений с открытым кодом от Tencent Hunyuan
小编 ·

HunyuanVideo-I2V: фреймворк генерации видео из изображений с открытым кодом от Tencent Hunyuan
Что такое HunyuanVideo-I2V?
HunyuanVideo-I2V — это новый фреймворк для генерации видео из изображений, открытый командой Tencent Hunyuan 6 марта 2025 года. Фреймворк основан на ранее открытом HunyuanVideo и расширяет возможности генерации видео из изображений, позволяя создателям видео генерировать высококачественные короткие видеоролики из одного изображения, а также поддерживает обучение с настраиваемыми спецэффектами.
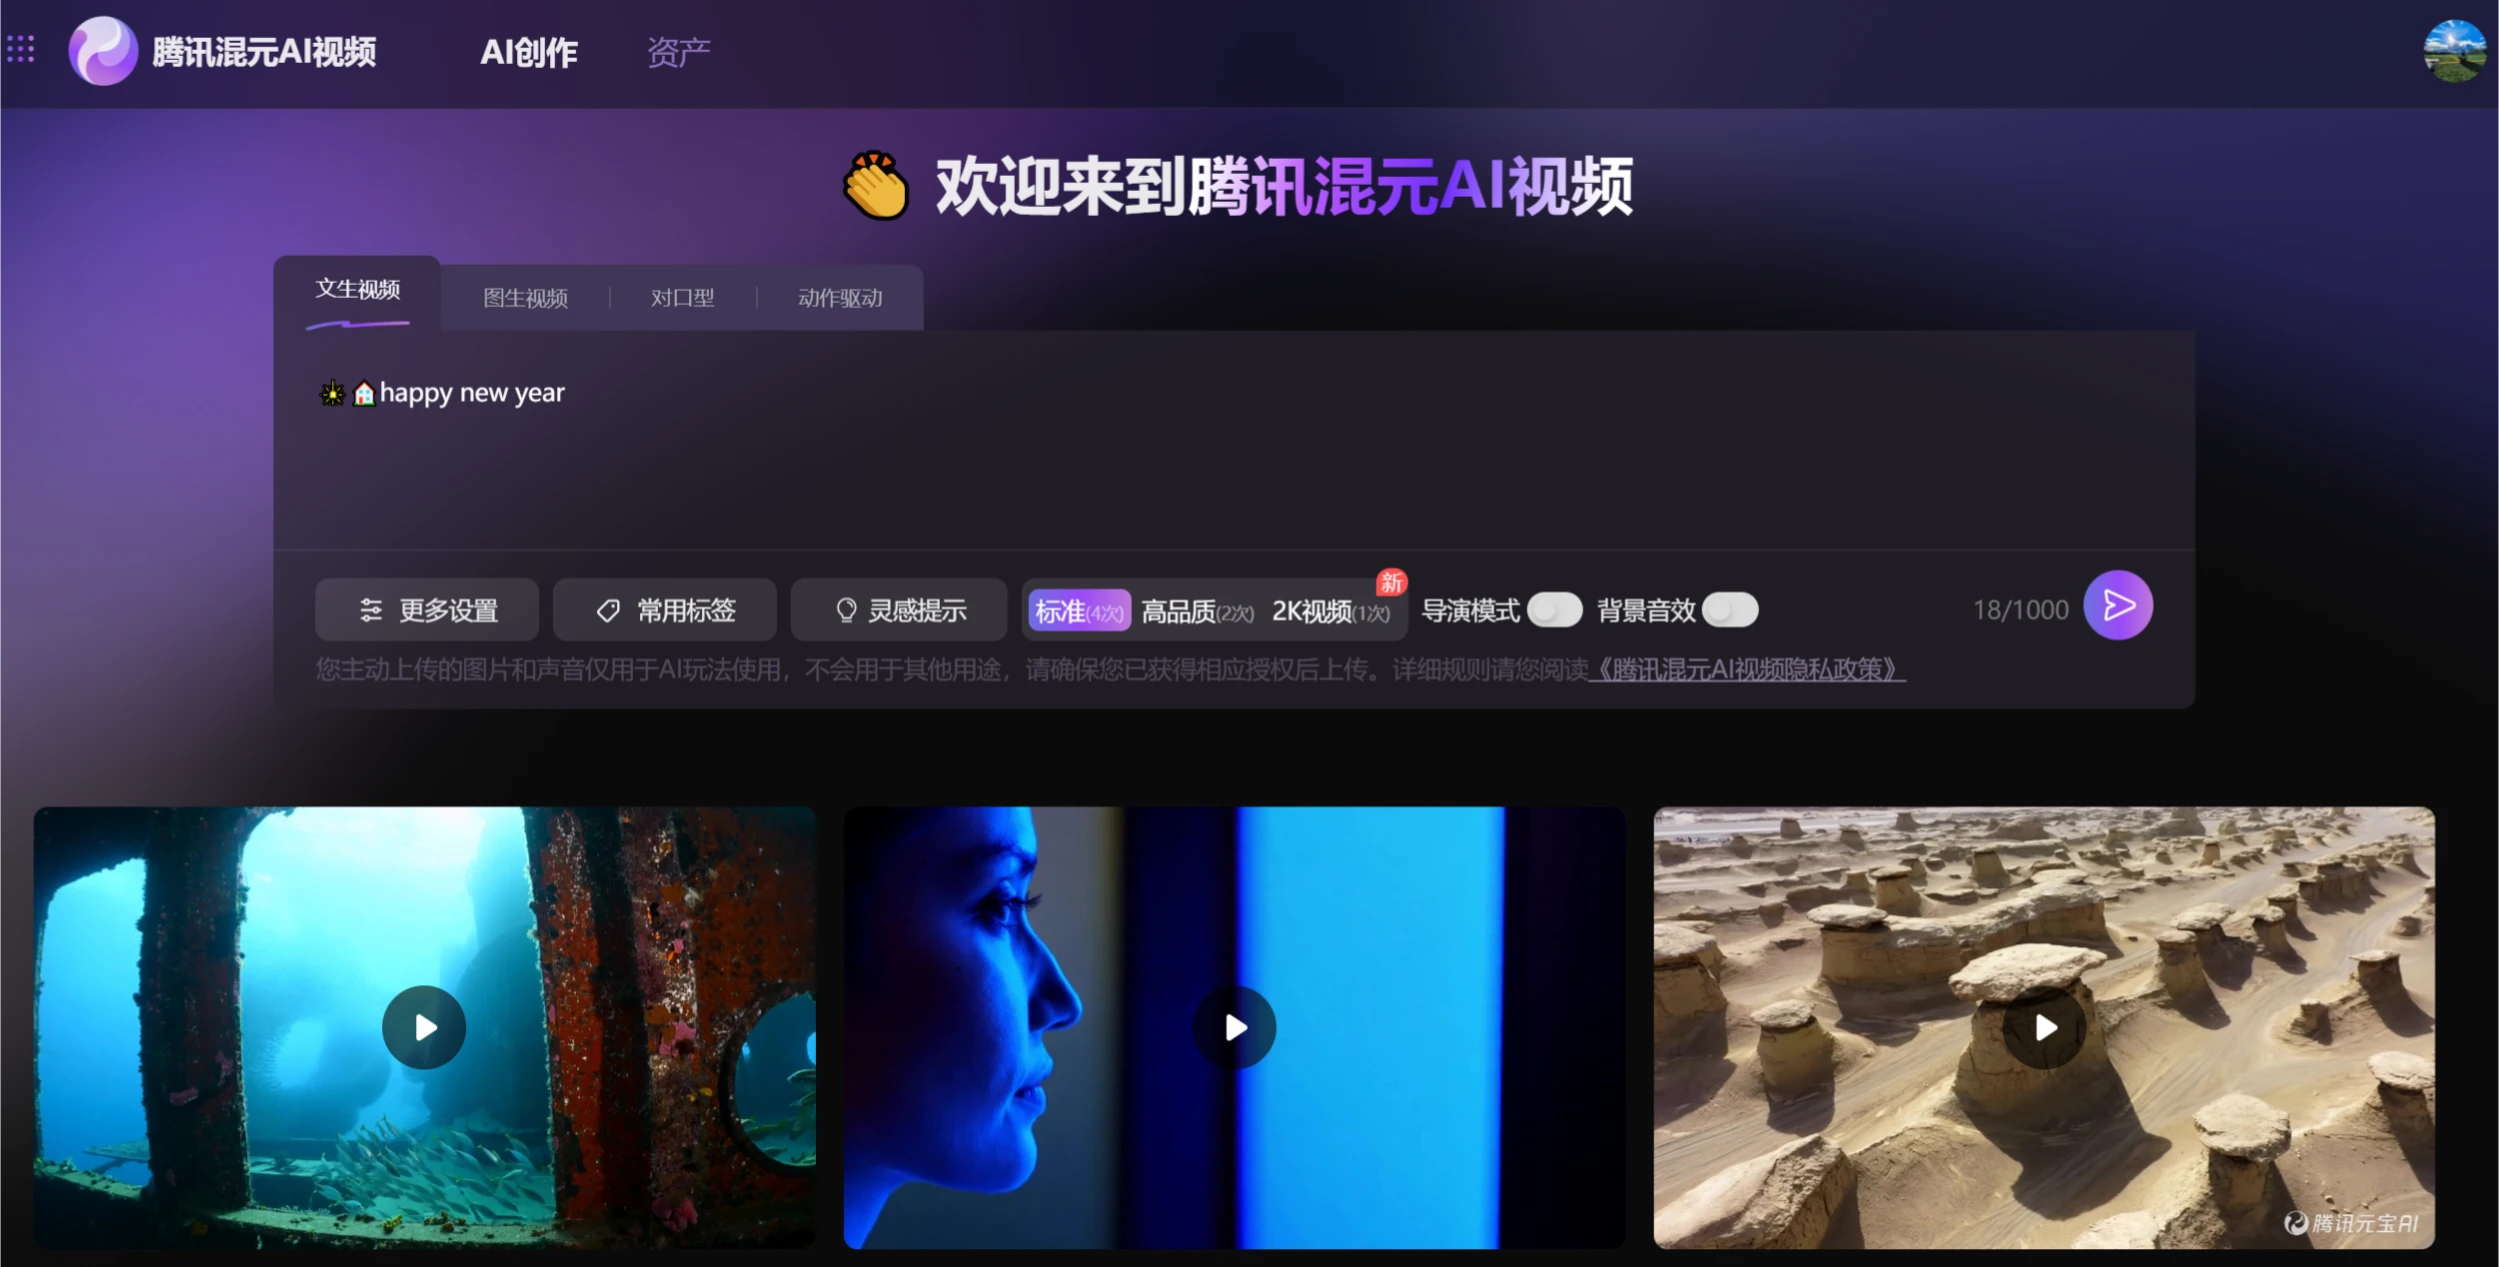
Функциональные особенности HunyuanVideo-I2V
Генерация видео из изображений: HunyuanVideo-I2V может использовать статическое изображение в качестве первого кадра видео и генерировать соответствующее видеосодержимое на основе введённых пользователем субтитров или описаний.
Мультимодальная большая языковая модель (MLLM): модель использует предварительно обученную мультимодальную большую языковую модель в качестве текстового кодировщика, что значительно улучшает понимание семантического содержания входного изображения.
3D-вариационный автокодировщик (3D VAE): 3D VAE, обученный с использованием технологии CausalConv3D, сжимает видео и изображения из пиксельного пространства в компактное латентное пространство, сокращая количество токенов в последующих моделях.
Гибридная архитектура с двухпоточной и однопоточной стадиями: на двухпоточной стадии видео- и текстовые токены обрабатываются независимо через несколько блоков Transformer; на однопоточной стадии видео- и текстовые токены объединяются для мультимодального слияния информации.
Стратегия прогрессивного обучения: постепенный переход от низкого разрешения и коротких видео к высокому разрешению и длинным видео, что повышает скорость сходимости модели.
Модель переписывания промптов: решает проблему разнообразия языкового стиля и длины пользовательских промптов, преобразуя введённые пользователем промпты в формат, более понятный модели.
Настраиваемое обучение LoRA: поддержка обучения моделей генерации видео с конкретными эффектами на небольшом объёме данных, например, такими как «рост волос» или «движения персонажей».
Эффективный инференс: поддерживается инференс на одном GPU и последовательный параллельный инференс на нескольких GPU, что обеспечивает более высокую скорость обработки.
Техническая архитектура HunyuanVideo-I2V
HunyuanVideo-I2V в целом продолжает архитектурный подход HunyuanVideo и оптимизирован для задачи генерации видео из изображений. Его ядро заключается в использовании технологии склеивания латентного пространства изображений для внедрения ключевой информации эталонного изображения в процесс генерации видео, а также в обеспечении глубокого кроссмодального слияния текстовой и визуальной информации с помощью MLLM.
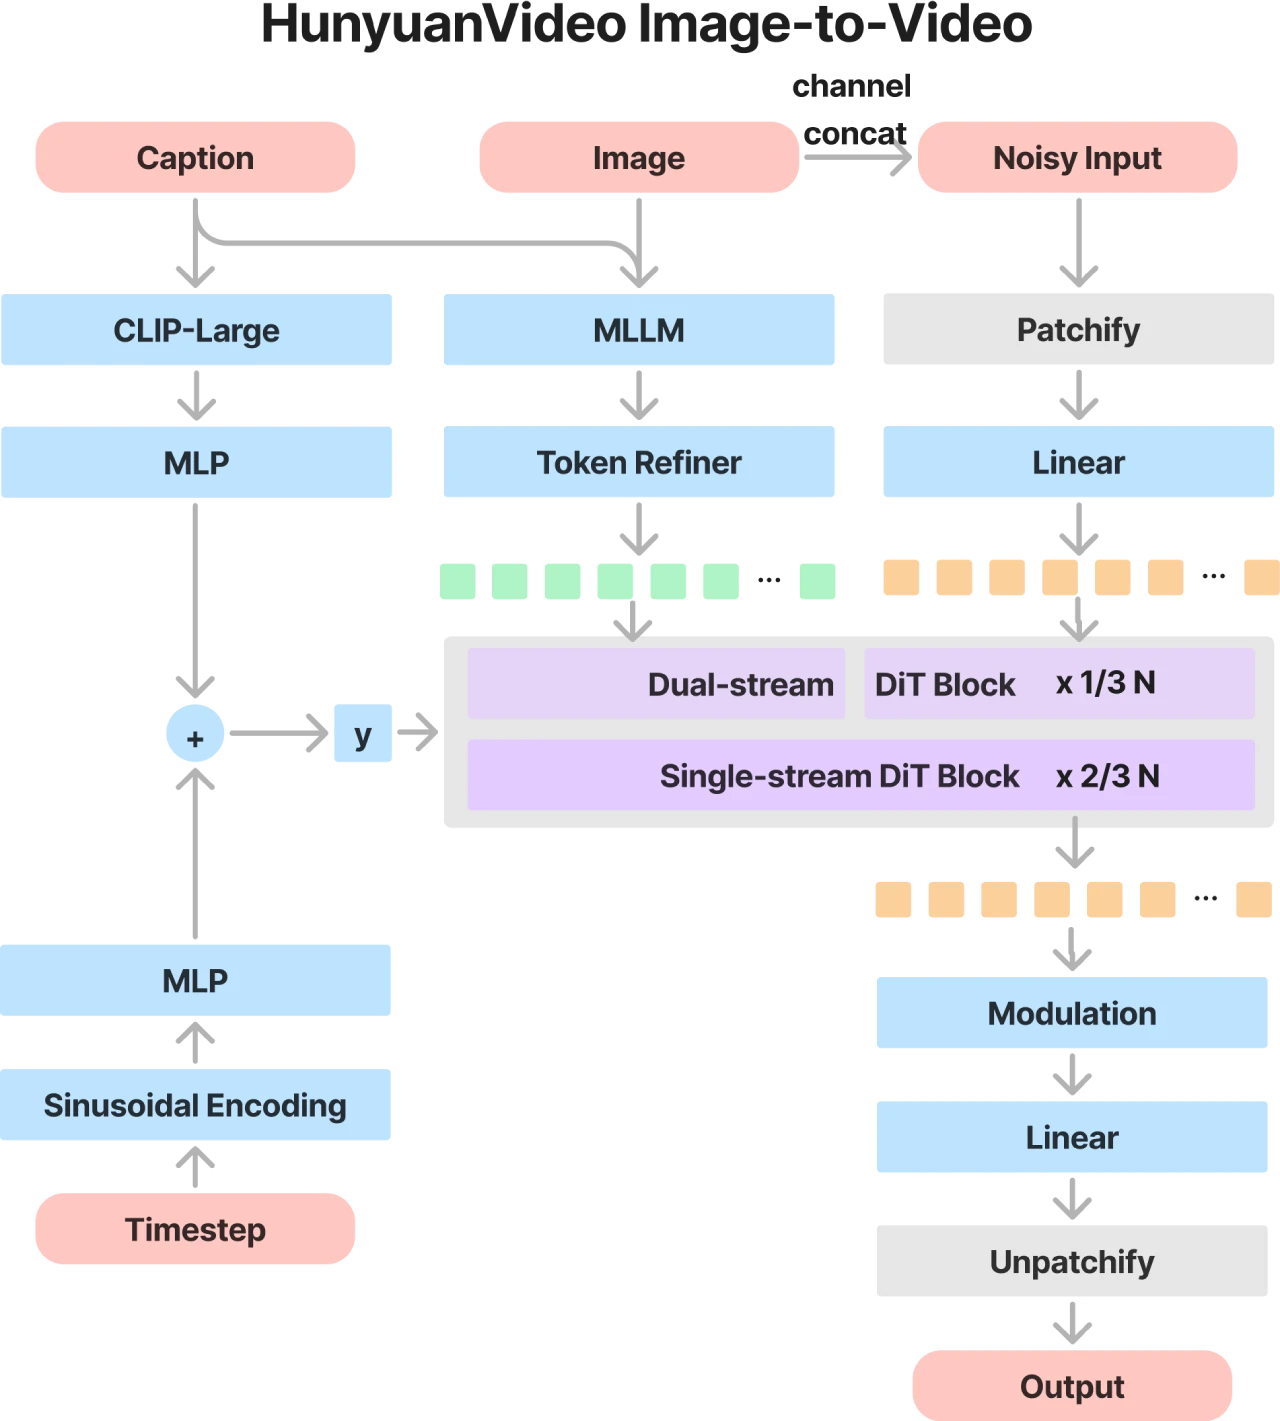
Как использовать HunyuanVideo-I2V
1. Установка и зависимости
Установите PyTorch и другие зависимости; подробные инструкции по установке можно найти на странице GitHub.
Рекомендуется использовать графический процессор NVIDIA с объёмом видеопамяти не менее 80 ГБ.
2. Загрузка предобученных моделей
Веса предобученных моделей можно загрузить со страницы GitHub или Hugging Face.
3. Код для инференса
Используйте предоставленный код инференса (например, sample_video.py) для генерации видео.
4. Обучение LoRA
Предоставляется код для обучения LoRA, с помощью которого пользователи могут обучить модели генерации видео с конкретными эффектами на небольшом объёме данных.
Сценарии применения HunyuanVideo-I2V
Создание видеоконтента: предоставление эффективных и высококачественных инструментов генерации видео для создателей видео.
Кинопроизводство: генерация видеоконтента кинематографического уровня.
Персонализированное видео: создание персонализированных видео на основе загруженных пользователем изображений и описаний.
Официальный сайт: https://video.hunyuan.tencent.com/
GitHub: https://github.com/Tencent/HunyuanVideo-I2V
Hugging Face: https://huggingface.co/tencent/HunyuanVideo-I2V









