
 Помощник сценариста▸
 AI Приложения
 AI Новости
CSM: модель синтеза речи от Sesame — как разговор с живым человеком
小编 ·

CSM: модель синтеза речи от Sesame — как разговор с живым человеком
Что такое CSM?
CSM (Conversational Speech Model) — это модель синтеза диалоговой речи, разработанная компанией Sesame. Она основана на архитектуре Transformer и использует сквозной метод мультимодального обучения, позволяющий учитывать контекст и эмоциональный фон для генерации исключительно реалистичной человеческой речи, что выделяет её в области синтеза речи.
Функциональные особенности CSM
Естественное звучание речи: имитирует интонацию, ритм и тембр реального человеческого голоса, решая проблему однообразия интонаций в традиционных системах синтеза речи и делая синтезированную речь похожей на живую.
Тонкая передача эмоций: способна включать такие естественные элементы, как эмоции, паузы и ударения, передавая гнев, грусть, волнение и другие чувства, что делает диалог более выразительным.
Низкая задержка отклика: благодаря оптимизированным методам вычислений обеспечивается плавность диалога, а время отклика ai крайне мало и приближается к мгновенной реакции человека.
Мультимодальное взаимодействие: одновременно принимает текст и историю голосовых сообщений, обладает способностью понимать контекст, учитывает фон и эмоции диалога, что делает речь более естественной и интерактивной.
Стабильность голоса: сохраняет стабильные голосовые характеристики, избегая несоответствий в разных ситуациях и устраняя роботизированную интонацию традиционных систем TTS.
Динамическое моделирование диалога: имитирует естественные паузы, скорость речи, ударения и другие факторы человеческого диалога, усиливая реалистичность и интерактивность голосового взаимодействия.
Технические преимущества CSM
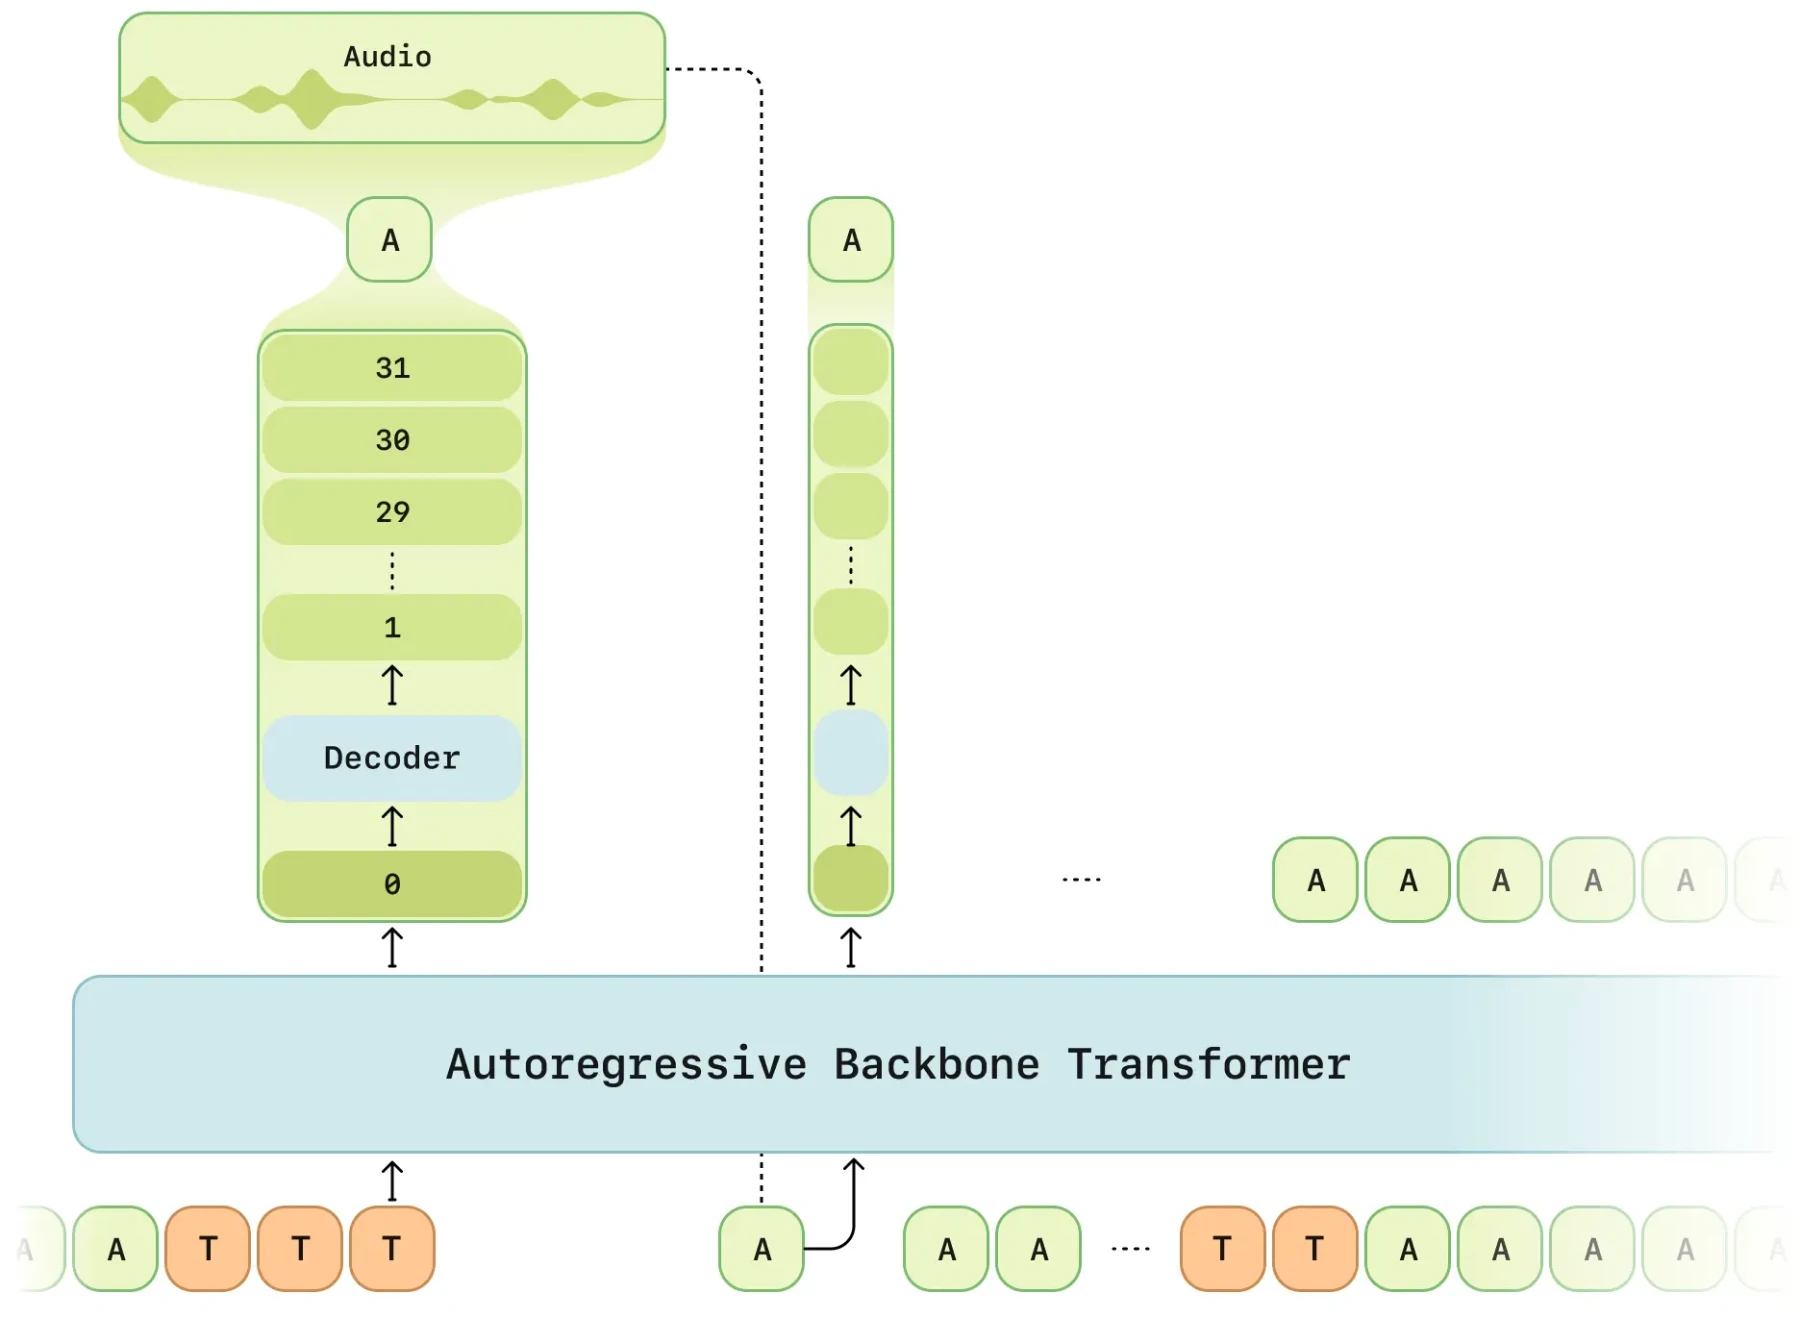
Сквозная мультимодальная архитектура Transformer: генерирует высококачественную речь непосредственно из текста без промежуточных этапов обработки. В основе лежит Transformer, благодаря чему голос AI обладает способностью учитывать контекст. Текст обрабатывается с помощью LLaMA Tokenizer, речь кодируется Mimi Tokenizer с применением технологии квантования RVQ.
Кодирование аудио на основе Residual Vector Quantization (RVQ): используются два типа аудио-токенов — семантические и акустические. Семантические токены отражают семантику речи и артикуляционные характеристики, а акустические — высоту тона, тембр, просодию и другие детали. Благодаря иерархическому обучению RVQ разные уровни предсказывают ключевые и детализированные признаки, что предотвращает потерю информации и повышает естественность речи.
Оптимизация вычислений и низкая задержка инференса
Оптимизация режима задержки: сначала вычисляются нижние уровни RVQ, а затем последовательно — верхние детализированные признаки, что ускоряет инференс.
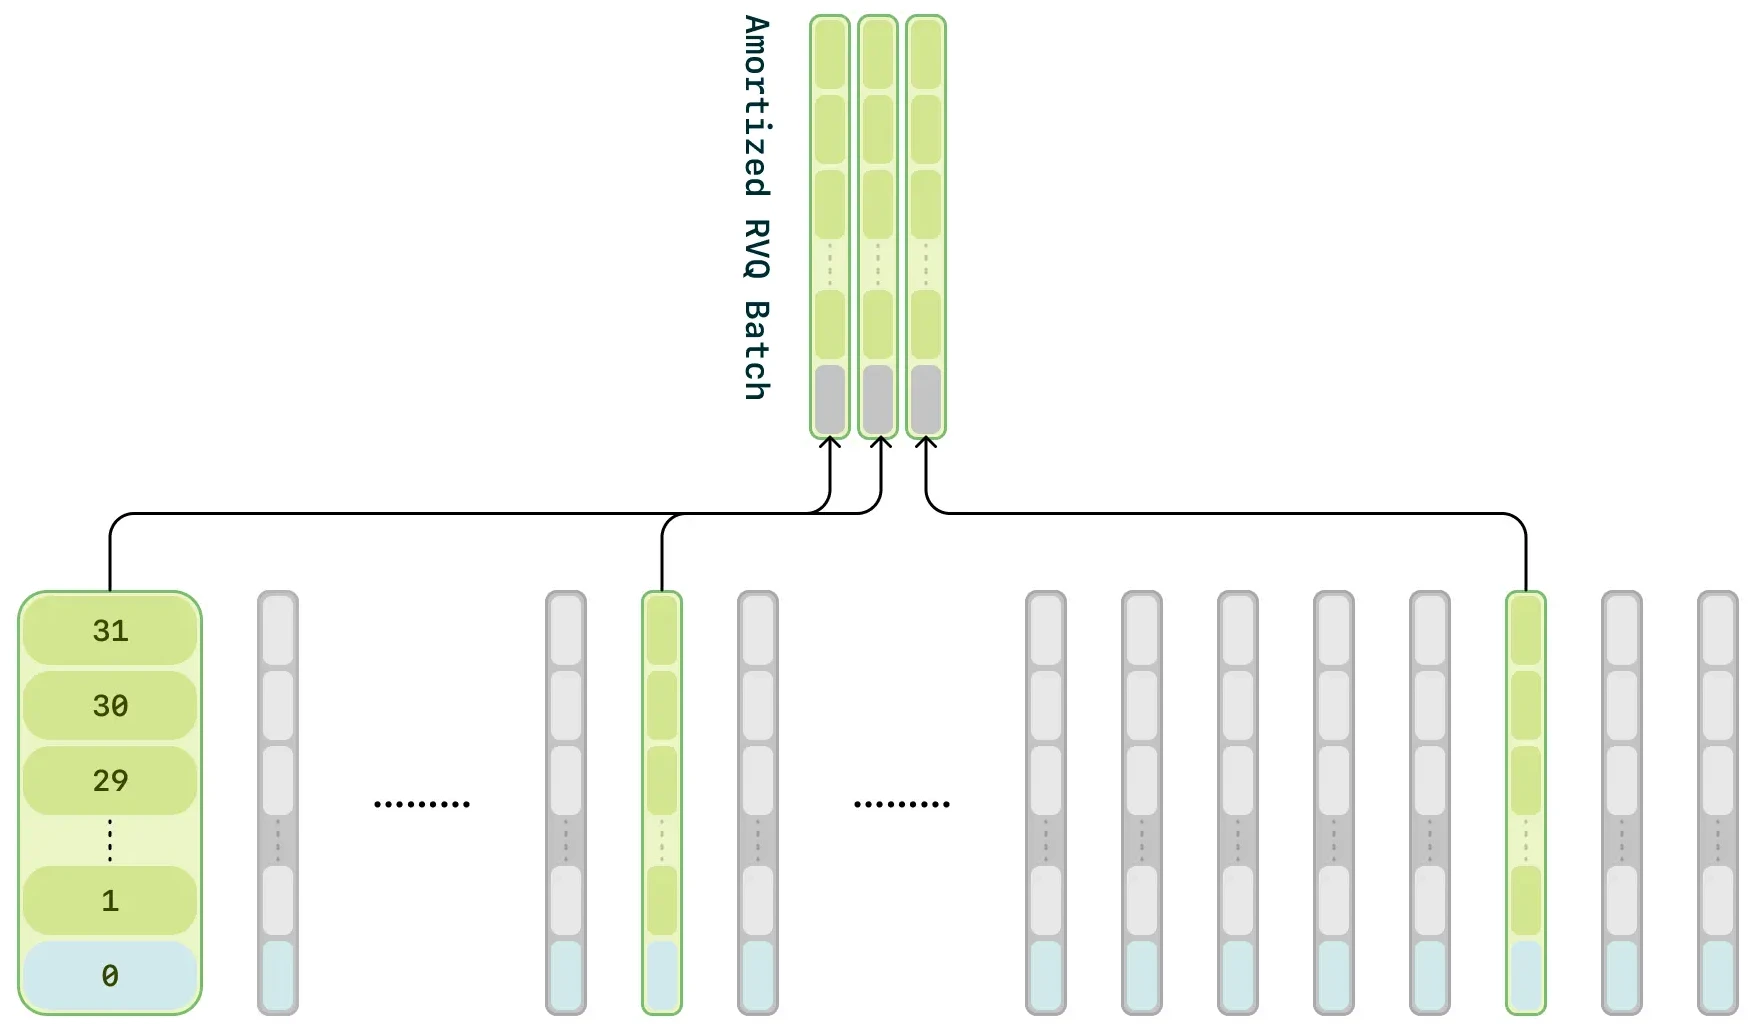
Распределение вычислений: на этапе обучения случайным образом выбирается 1/16 аудиокадров для оптимизации, что снижает вычислительные затраты без ущерба качеству звука.
Двухэтапная структура Transformer: основной Transformer обрабатывает текстовую и аудиоинформацию, прогнозируя базовую структуру; легковесный декодер уточняет аудио, снижая объём вычислений и повышая скорость инференса.
Широкое применение CSM
Интеллектуальные ассистенты: делает голосовое взаимодействие умных колонок и виртуальных помощников более естественным и дружелюбным, как при общении с реальным человеком.
Клиентское обслуживание: применение в системах поддержки клиентов обеспечивает более плавное взаимодействие и повышает удовлетворённость пользователей.
Образование и обучение: создание в приложениях для изучения языков среды, приближённой к реальному диалогу, помогает учащимся понимать и отрабатывать языковые знания.
Индустрия развлечений: наделяет персонажей игр, анимации и других направлений живой и реалистичной речью, делая истории более увлекательными.
Создание виртуальных ассистентов: формирование виртуальных помощников с более естественным голосом для оказания внимательного сервиса.
Оптимизация переводческих инструментов: генерация естественных и плавных диалогов при синхронном голосовом переводе, улучшая качество перевода.
Интерактивность образовательных платформ: применение в интерактивных голосовых диалогах на образовательных платформах повышает интерес к обучению и его эффективность.
Способы использования CSM
Онлайн-демонстрация
Можно посетить официальный сайт Sesame (sesame.com/voicedemo), чтобы ознакомиться с возможностями технологии синтеза речи.
Интеграция в продукты
Разработчики могут интегрировать речевую модель Sesame в голосовые ассистенты, системы интеллектуальной поддержки клиентов и другие продукты или сервисы для расширения возможностей голосового взаимодействия.
Исследования и разработка
Компания Sesame планирует увеличить масштаб модели и объём наборов данных. Исследователи могут следить за официальными материалами и демонстрациями (https://www.sesame.com/research/crossing_the_uncanny_valley_of_voice ), чтобы быть в курсе последних результатов и технических достижений.
Если вы хотите попробовать онлайн, посетите:https://www.sesame.com/research/crossing_the_uncanny_valley_of_voice#demo









