
 Помощник сценариста▸
 AI Приложения
 AI Новости
VLM-R1: визуально-языковая модель в стиле R1 с повышенной стабильностью и обобщаемостью
小编 ·

VLM-R1: визуально-языковая модель в стиле R1 с повышенной стабильностью и обобщаемостью
Что такое VLM-R1?
VLM-R1 (Visual Language Model - R1) — это совершенно новая модель визуального языка с открытым исходным кодом, разработанная командой Om ai Lab. Её суть заключается в успешном переносе метода DeepSeek R1 в область визуально-языковых моделей, что обеспечивает более высокую стабильность и способность к обобщению.
VLM-R1 построена на базе Qwen2.5-VL и улучшает возможности визуального понимания с помощью обучения с подкреплением. В задачах компьютерного зрения, особенно в понимании междисциплинарных данных, она превосходит традиционные модели SFT, демонстрируя мощные способности к пониманию визуального контента и являясь одним из важных прорывов в развитии мультимодального ИИ.
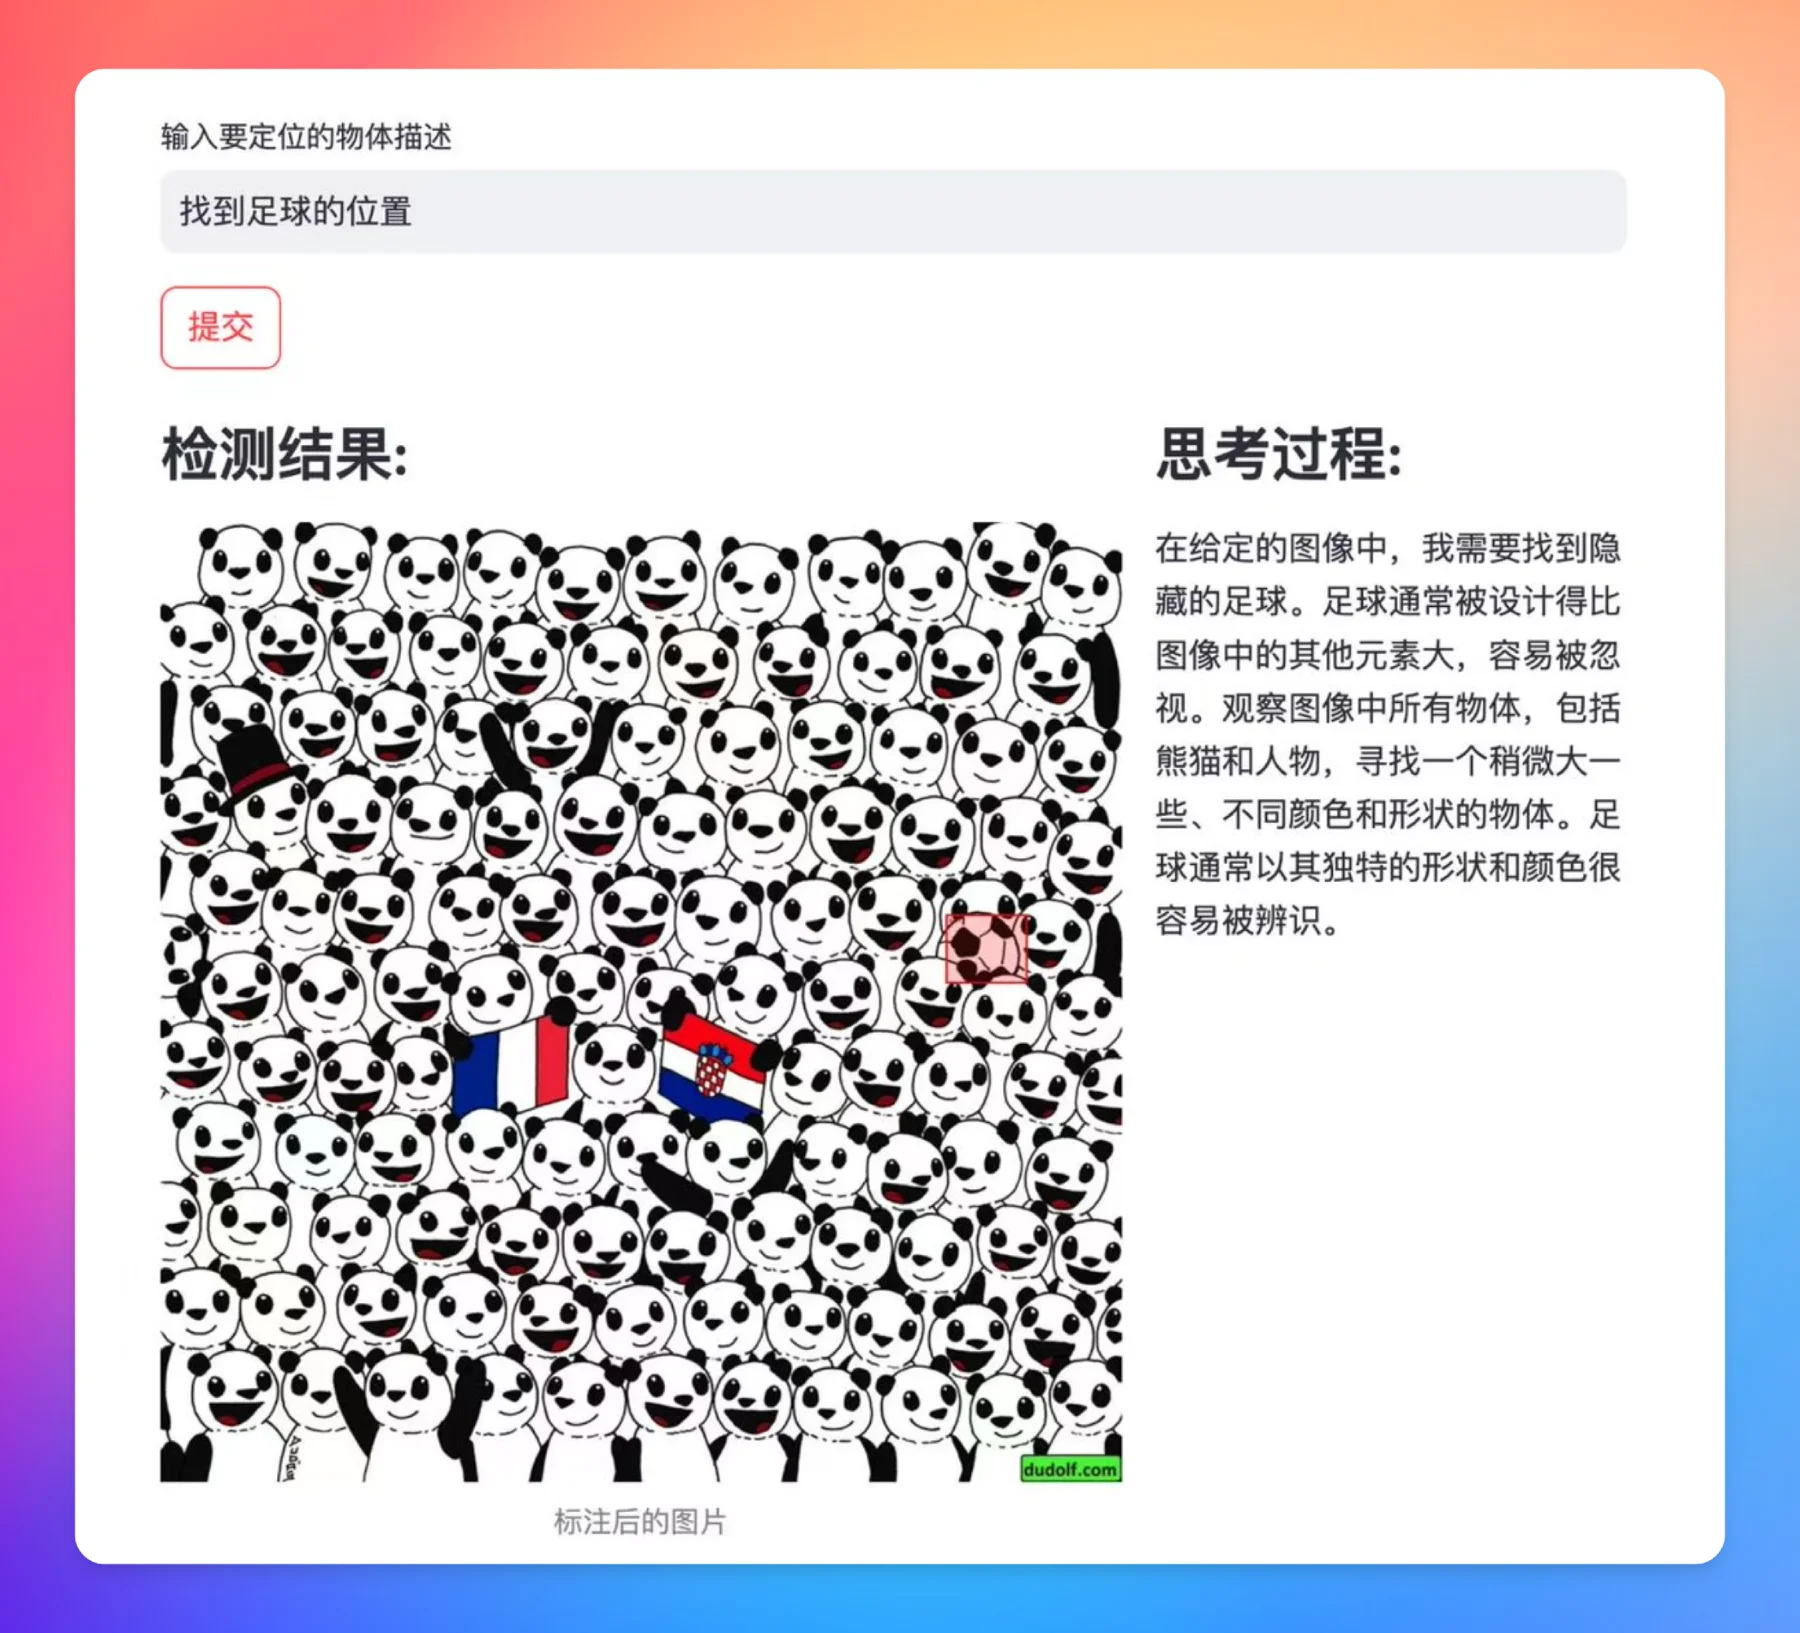
Технический контекст VLM-R1:
VLM-R1 была вдохновлена методом R1, открытым командой DeepSeek в прошлом году. Этот метод использует технологию обучения с подкреплением GRPO (Group Relative Policy Optimization) и достиг значительных результатов на чисто текстовых больших моделях. Команда VLM-R1 применила этот метод к визуально-языковым моделям, успешно открыв новые возможности в мультимодальной области.
Основные особенности VLM-R1:
Междисциплинарная устойчивость: даже в сложных и непредсказуемых условиях применения VLM-R1 способна поддерживать высокий уровень производительности.
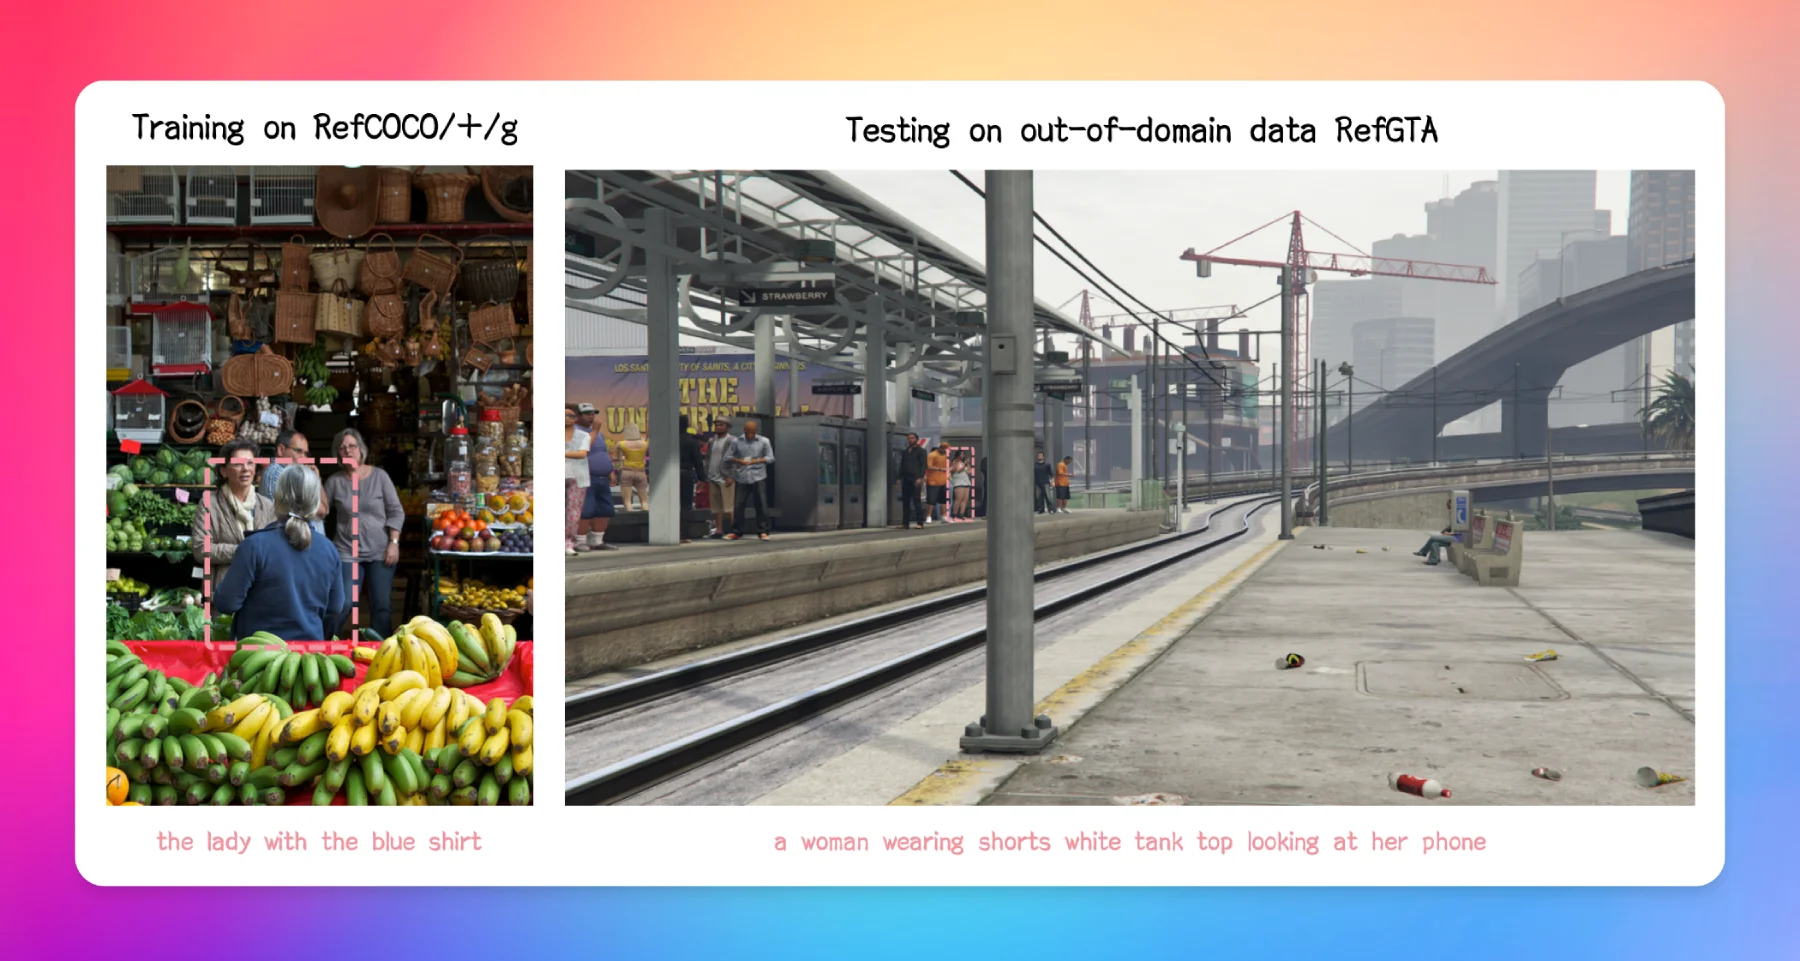
Отличная способность к обобщению: в отличие от традиционного контролируемого дообучения (SFT), производительность VLM-R1 на ранее не виданных задачах или распределениях данных продолжает улучшаться с течением времени, демонстрируя высокую адаптивность и гибкость.
Простота использования: полный процесс обучения и оценки позволяет пользователям быстро приступить к работе и начать эксперименты в несколько шагов, что чрезвычайно удобно для исследователей и инженеров, желающих использовать передовые технологии ИИ.
Эффективное использование ресурсов: технология динамической оптимизации позволяет обучать модели с большим количеством параметров (до десятков миллиардов) на одном графическом процессоре, снижая требования к оборудованию и одновременно повышая эффективность.
Техническая реализация VLM-R1:
VLM-R1 построена на базе Qwen2.5-VL и сравнивает методы R1 и традиционного SFT. Результаты показывают, что модель R1 превосходит традиционные модели SFT по стабильности, способности к обобщению и глубине понимания. Кроме того, VLM-R1 демонстрирует свои профессиональные возможности в визуальном распознавании, логическом мышлении и текстовом выражении на практическом примере.
Сценарии применения VLM-R1:
VLM-R1 демонстрирует выдающуюся производительность во множестве практических применений. Например, в интеллектуальных ассистентах, системах автономного вождения и виртуальной реальности её мощные возможности обработки и гибкость обеспечивают широкий потенциал применения в мультимодальном взаимодействии. В частности, в одном демонстрационном примере, получив фотографию с разнообразными ингредиентами, VLM-R1 точно определила продукт с высоким содержанием белка — яичный блин, и дополнительно объяснила причину. Кроме того, она способна точно определять положение отмеченных объектов на изображении, что в полной мере демонстрирует её выдающиеся комплексные возможности в генерации текста, логическом мышлении и визуальном восприятии.
Ссылки по теме VLM-R1:
Репозиторий на GitHub:https://github.com/om-ai-lab/VLM-R1
Демонстрация:https://huggingface.co/spaces/omlab/VLM-R1-Referral-Expression









