
 Помощник сценариста▸
 AI Приложения
 AI Новости
OSUM: open-source модель обработки речи от Северо-Западного политехнического университета
小编 ·

OSUM: open-source модель обработки речи от Северо-Западного политехнического университета
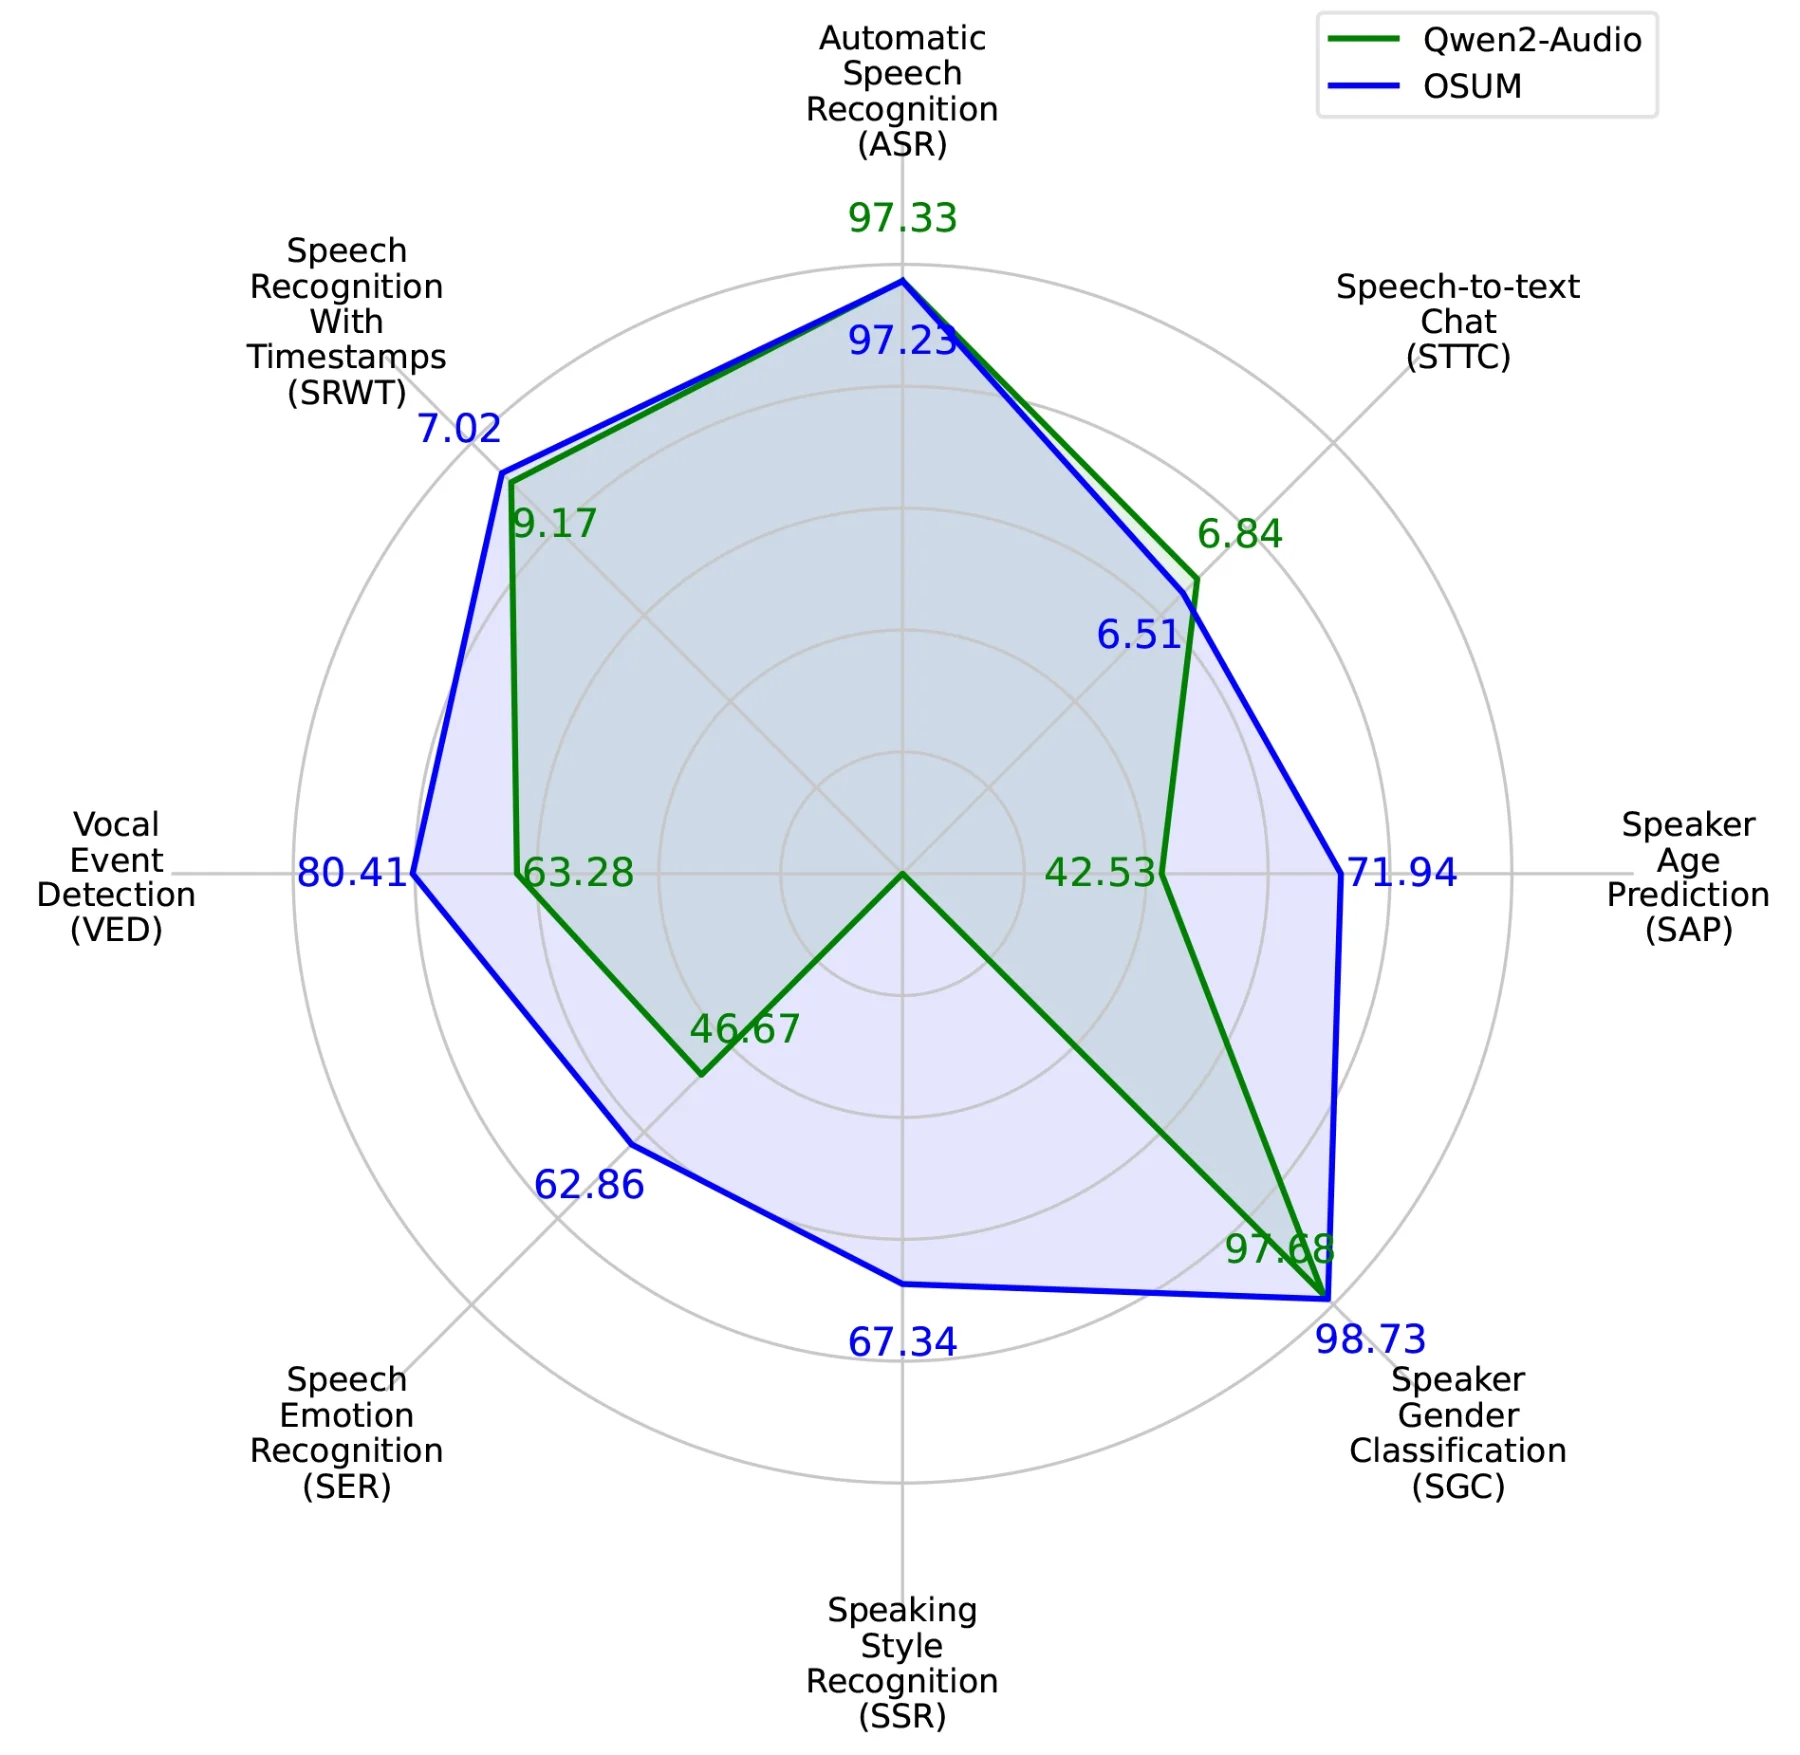
OSUM (Open Speech Understanding Model) — это модель распознавания речи, предложенная и опубликованную с открытым исходным кодом группой обработки аудио, речи и языка (ASLP@NPU) Школы компьютерных наук и технологий Северо-Западного политехнического университета. Модель предназначена для поддержки широкого спектра задач обработки речи.
Функциональные особенности OSUM:
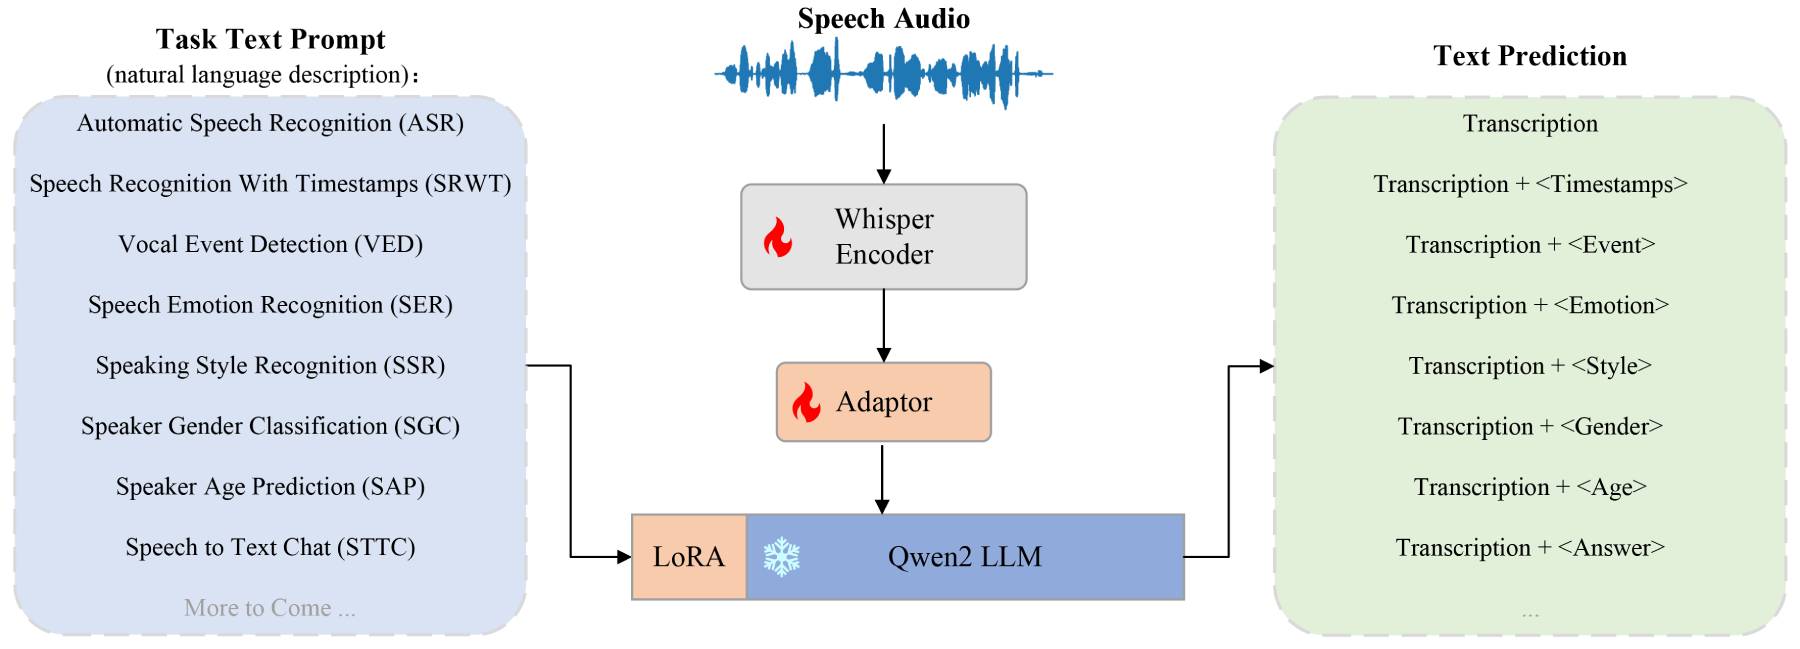
Поддержка множества задач:
Распознавание речи (ASR): преобразование речи в текст.
Распознавание речи с временными метками (SRWT): распознавание речевого содержания с аннотированием временной информации.
Обнаружение речевых событий (VED): распознавание определённых событий или действий в речи.
Распознавание эмоций в речи (SER): анализ эмоционального состояния в речи.
Распознавание стиля речи (SSR): определение манеры речи или тона говорящего.
Классификация пола говорящего (SGC): определение пола говорящего на основе его речи.
Прогнозирование возраста говорящего (SAP): оценка возраста говорящего.
Преобразование речи в текстовый чат (STTC): преобразование голосовых диалогов в читаемый текст.
Архитектура модели: OSUM объединяет кодировщик Whisper и большую языковую модель Qwen2 (LLM), а для тонкой настройки LLM используется технология LoRA, что обеспечивает эффективное многозадачное обучение.
Стратегия обучения: применяется стратегия обучения ASR+X, при которой путём одновременной оптимизации автоматического распознавания речи (ASR) и вспомогательной задачи (X) достигается эффективное и стабильное многозадачное обучение при снижении потребления ресурсов.
Функция глубокого понимания: модель OSUM способна преобразовывать речевую информацию в текст, а также поддерживает распознавание эмоций в речи, обеспечивая пользователям более интеллектуальный интерактивный опыт.
Поддержка временных меток: при распознавании речи OSUM выдаёт результаты с временными метками, что удобно для последующей обработки и анализа.
Совместимость с различными платформами: поддерживается работа на различных вычислительных платформах, включая Huawei Ascend 910B и платформы NVIDIA, что повышает гибкость применения модели.
Применение OSUM:
Интеллектуальные ассистенты: в системах умного дома и виртуальных помощниках для понимания и реагирования на голосовые команды пользователей.
Многоязычные сервисы: как и плагин YouTube Dubbing, может использоваться для перевода в реальном времени и дублирования в реальном времени, преодолевая языковые барьеры.
Анализ эмоций: в клиентском сервисе и приложениях для психологического здоровья для анализа настроения пользователей и предоставления персонализированного обслуживания.
Образовательная сфера: автоматическая оценка устных заданий студентов и предоставление обратной связи.
Технологии доступности: помощь людям с нарушениями слуха в понимании голосовой информации.
Маркетинговые исследования: анализ эмоций и мнений в отзывах потребителей.
Транскрибирование речи: в таких сценариях, как ведение протоколов совещаний и преобразование устной речи в текст, OSUM обеспечивает эффективное транскрибирование.
Инструкция по использованию OSUM:
Установка и импорт: пользователи могут загрузить исходный код и веса модели OSUM со страницы на Hugging Face или со страницы проекта на GitHub и выполнить установку в соответствии с предоставленным руководством. Пример кода для импорта модели OSUM в среду Python:
from osum import OSUM
model = OSUM.from_pretrained("ASLP-lab/OSUM")
Выполнение задач: пользователи могут использовать модель OSUM для выполнения различных речевых задач, например распознавания речи. Ниже приведён пример кода для задачи распознавания речи:
result = model.transcribe("audio.wav")
print(f"识别结果:{result}")
Что касается использования, пользователи также могут выполнять тонкую настройку с помощью предварительно обученных контрольных точек модели, чтобы дополнительно повысить производительность модели в конкретных задачах.
GitHub: https://github.com/ASLP-lab/OSUM
Проект: https://aslp-lab.github.io/OSUM.github.io/









