
 Помощник сценариста▸
 AI Приложения
 AI Новости
SWE-Lancer: открытый бенчмарк OpenAI для оценки возможностей в разработке ПО
小编 ·

SWE-Lancer: открытый бенчмарк OpenAI для оценки возможностей в разработке ПО
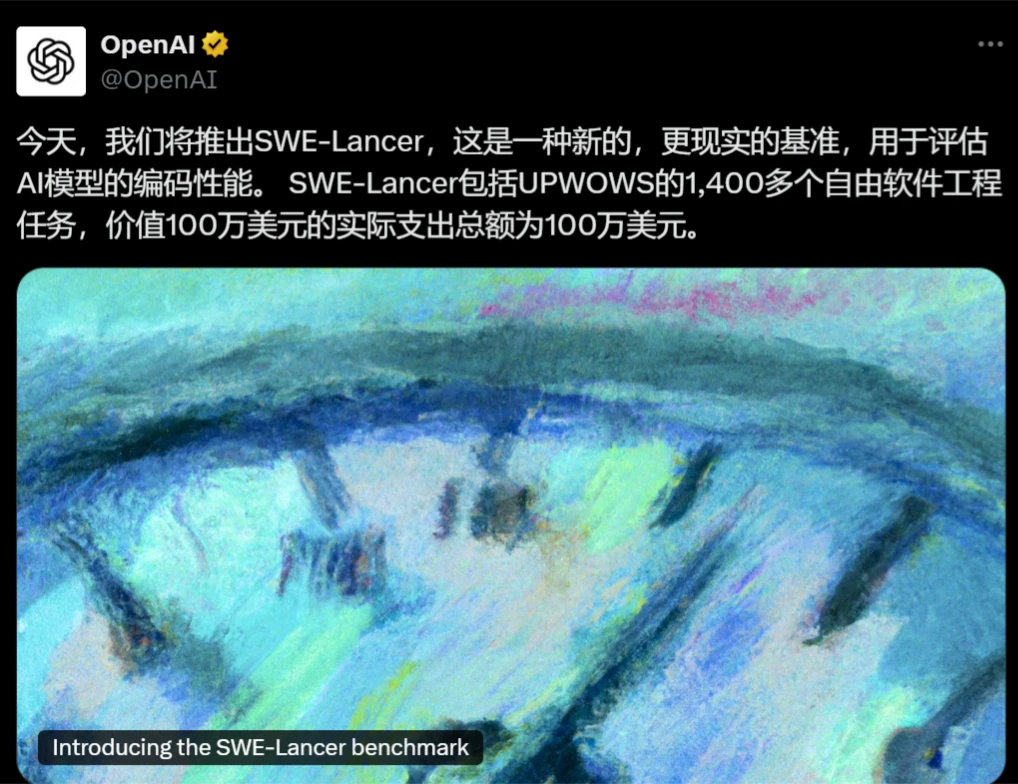
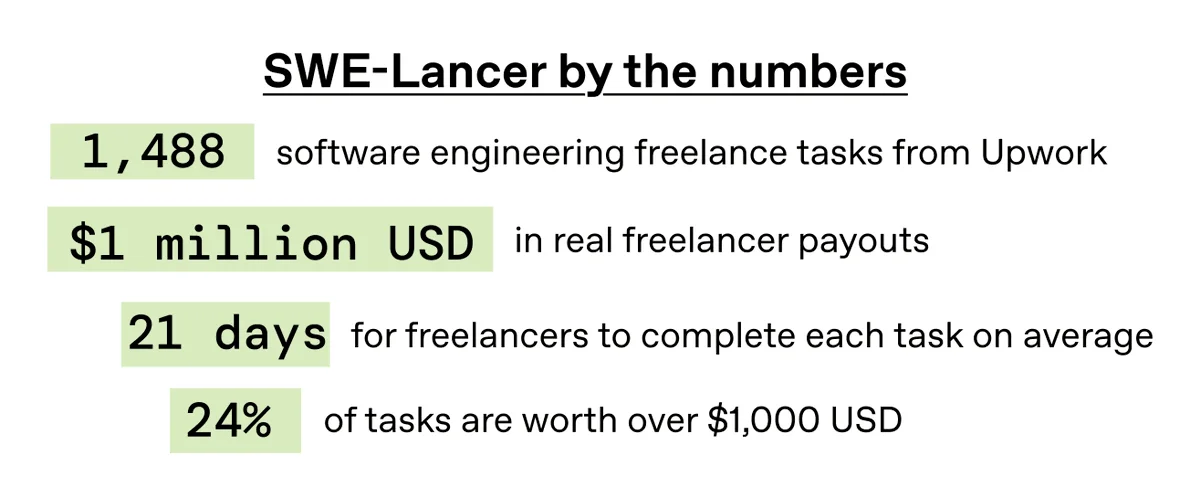
SWE-Lancer — это бенчмарк, представленный Openai, предназначенный для оценки эффективности моделей в решении задач, связанных с разработкой программного обеспечения с открытым исходным кодом. Бенчмарк включает более 1400 заданий, собранных с платформы Upwork, общей стоимостью около 1 миллиона долларов. SWE-Lancer ориентирован на оценку патчей кода и управленческих решений, позволяя моделям выбирать лучшие предложения из нескольких вариантов, что максимально точно воспроизводит рабочие процессы инженерных команд.
Основные аспекты оценки:
Разнообразие оцениваемых задач
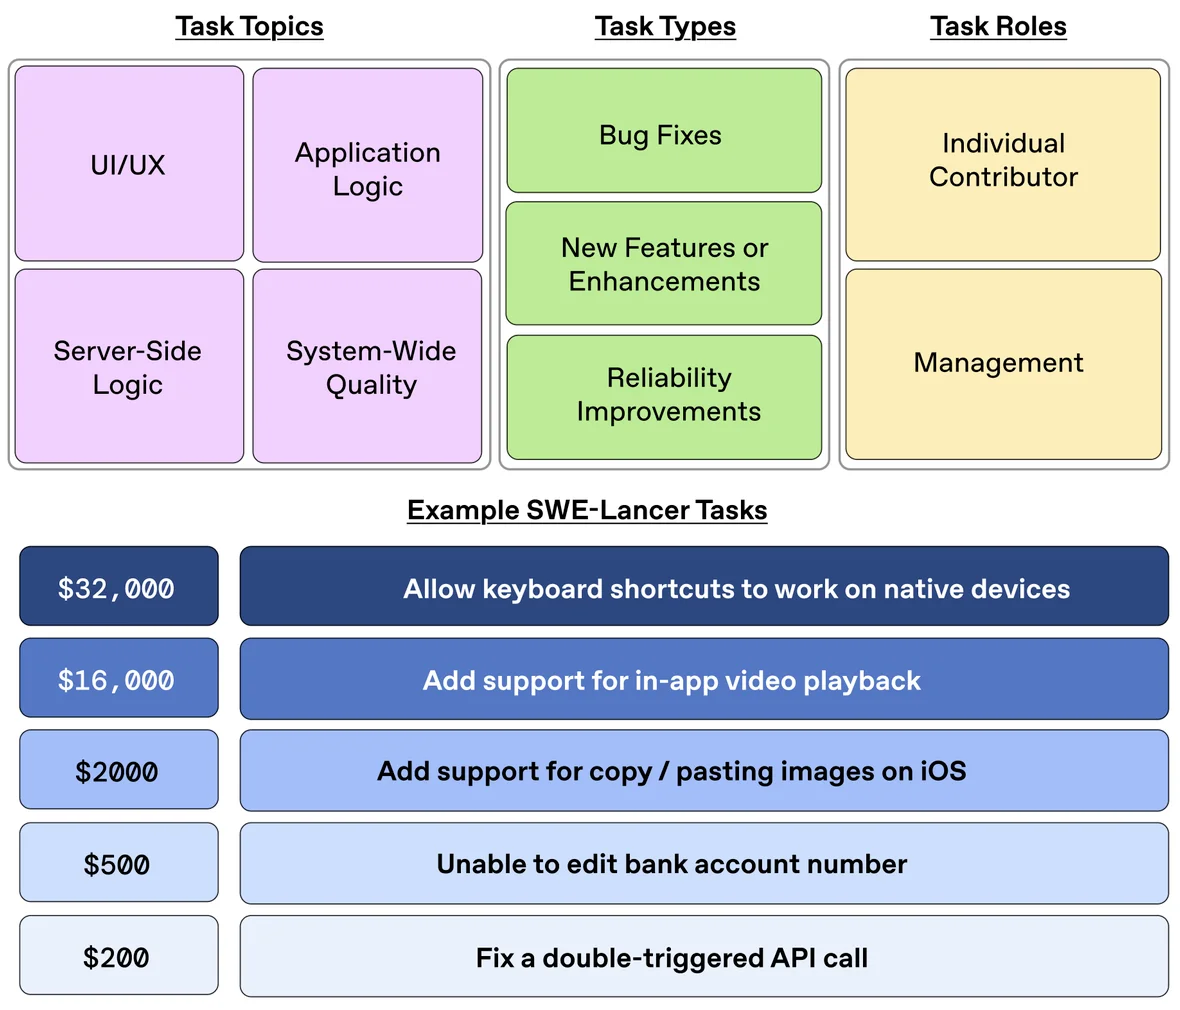
SWE-Lancer охватывает широкий спектр типов задач по разработке программного обеспечения, что делает его очень эффективным инструментом для анализа возможностей моделей. Он требует от модели выбора наилучшего решения из нескольких предложенных вариантов — такой подход позволяет бенчмарку более точно отражать реальные рабочие процессы инженерных команд.
Оценка экономической ценности
Этот бенчмарк оценивает не только технические возможности, но и экономическую ценность задач. Такой подход к оценке открывает новую перспективу для измерения эффективности моделей в реальных условиях применения и позволяет разработчикам лучше понять потенциальный экономический эффект от использования моделей ИИ.
Функциональные особенности SWE-Lancer:
Реальные задачи: SWE-Lancer включает набор реальных задач по разработке программного обеспечения — от мелких исправлений ошибок до реализации крупных функциональных возможностей, что обеспечивает эффективную оценку моделей в реальных сценариях разработки.
Сквозное тестирование: в отличие от традиционного модульного тестирования, SWE-Lancer использует метод сквозного тестирования, что требует от модели умения решать задачу целиком и приближает процесс к принятию решений, с которым сталкивается разработчик в реальной работе.
Оценка с выбором из вариантов: модель должна выбрать лучшее решение из нескольких возможных, что моделирует процесс принятия решений инженерной командой при столкновении с проблемой.
Привязка к экономической ценности: общая стоимость задач составляет 1 миллион долларов, что отражает их сложность и значимость, а также демонстрирует потенциальное экономическое влияние результатов работы модели.
Применение SWE-Lancer:
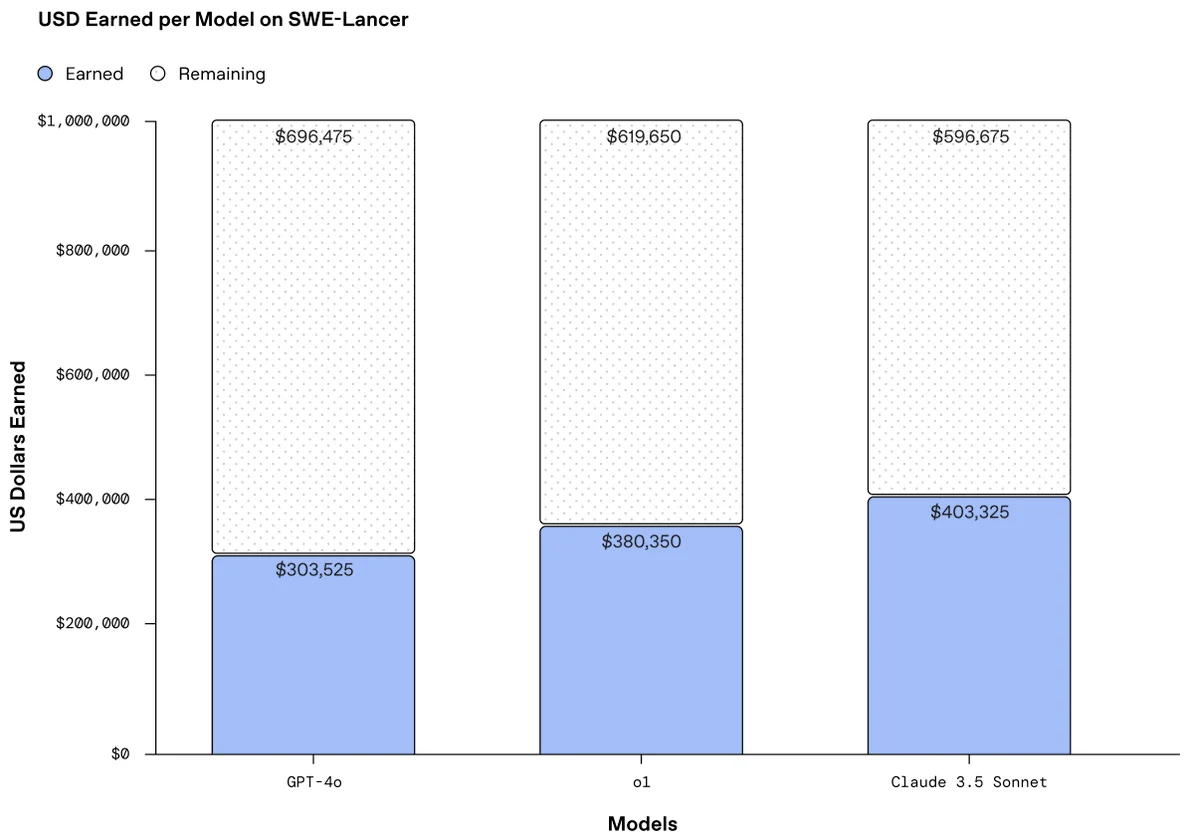
Оценка производительности моделей: предоставляет исследователям и разработчикам платформу для тестирования и сравнения крупных языковых моделей при выполнении задач по разработке программного обеспечения.
Помощь в разработке программного обеспечения: в перспективе SWE-Lancer может способствовать оптимизации применения искусственного интеллекта в разработке ПО, например, в автоматическом ревью кода, предложении исправлений ошибок и других задачах.
Образование и подготовка кадров: может использоваться в качестве учебного инструмента, помогающего студентам и разработчикам понять лучшие практики и вызовы в области разработки программного обеспечения.
Отраслевой стандарт: имеет потенциал стать отраслевым стандартом для оценки практической применимости ИИ в сфере разработки программного обеспечения.
Как использовать SWE-Lancer:
Выбор задач: выберите одну или несколько задач из списка, предоставленного SWE-Lancer, для оценки.
Обработка моделью: передайте выбранные задачи модели искусственного интеллекта, которая выполнит их в соответствии со своим обучением и возможностями.
Оценка результатов: оцените результаты, сгенерированные моделью, чтобы убедиться в их соответствии заранее установленным стандартам качества, и проанализируйте их с учётом экономической ценности задач.
Статья:https://arxiv.org/abs/2502.12115
Подробнее:https://openai.com/index/swe-lancer/









