
 Помощник сценариста▸
 AI Приложения
 AI Новости
VideoWorld: сложные задачи только через зрение, без языковых моделей
小编 ·

VideoWorld: сложные задачи только через зрение, без языковых моделей
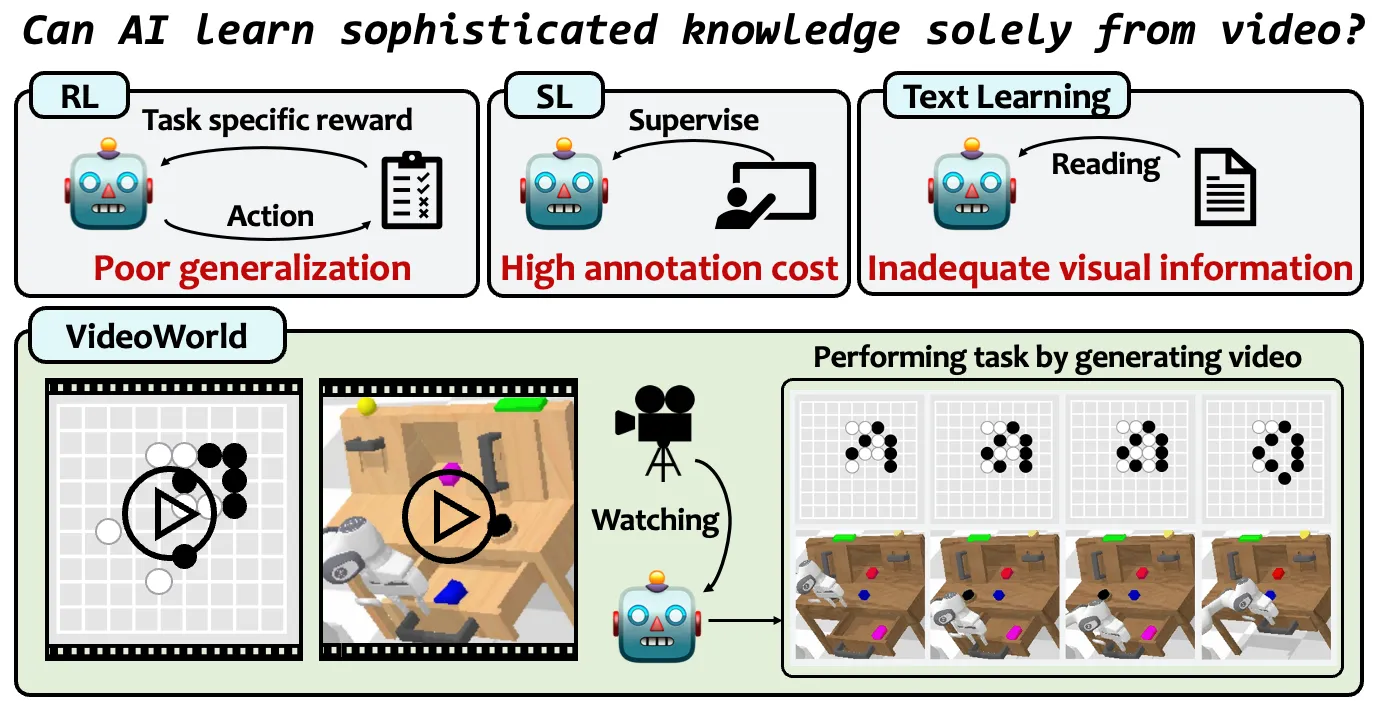
10 февраля 2025 года модель генерации видео «VideoWorld», разработанная совместно командой Doubao Large Model, Пекинским транспортным университетом и Университетом науки и технологий Китая, была официально опубликована в открытом доступе. Ключевая инновация модели VideoWorld заключается в том, что она полностью не зависит от языковых моделей и способна обучаться и генерировать сложные задачи исключительно с помощью визуальной информации.
I. Основные функциональные характеристики
1. Обучение на чисто визуальных знаниях
Самостоятельное освоение сложных правил и стратегий по неразмеченным видеоданным (таких как логика ходов в го, временны́е последовательности операций роботов) без необходимости использования языковых инструкций или механизма вознаграждения обучения с подкреплением
Поддержка многошагового логического вывода и долгосрочного планирования, например, прогнозирование в партии в го следующих 5–9 ходов противника
2. Эффективное сжатие визуального представления
Внедрение модели латентной динамики (LDM), которая кодирует изменения между видеокадрами в компактную латентную последовательность, снижая помехи от избыточной информации
Реализация совместного моделирования краткосрочных и долгосрочных динамических зависимостей: на коротких дистанциях акцент на точных перемещениях (например, тонкая настройка манипулятора), на длинных — захват моделей на уровне задач (например, тактических комбинаций в го)
3. Способность к обобщению в различных сценариях
На робототехнических тестовых наборах CALVIN и RLBench производительность приближается к модели Oracle, позволяя адаптироваться к различным параметрам среды (таким как освещение, расположение объектов)
В партиях в го достигает уровня профессионального пятого дана (базовый набор Video-GoBench), превосходя традиционных агентов обучения с подкреплением.
II. Архитектура VideoWorld:
Базовая архитектура
Основана на VQ-VAE для дискретизации видеокадров в последовательность токенов и использовании авторегрессионного Transformer для покадрового прогнозирования
Обучающие данные содержат только видеоролики выполнения задач (например, записи партий в го, записи операций манипулятора)
Модель латентной динамики (LDM)
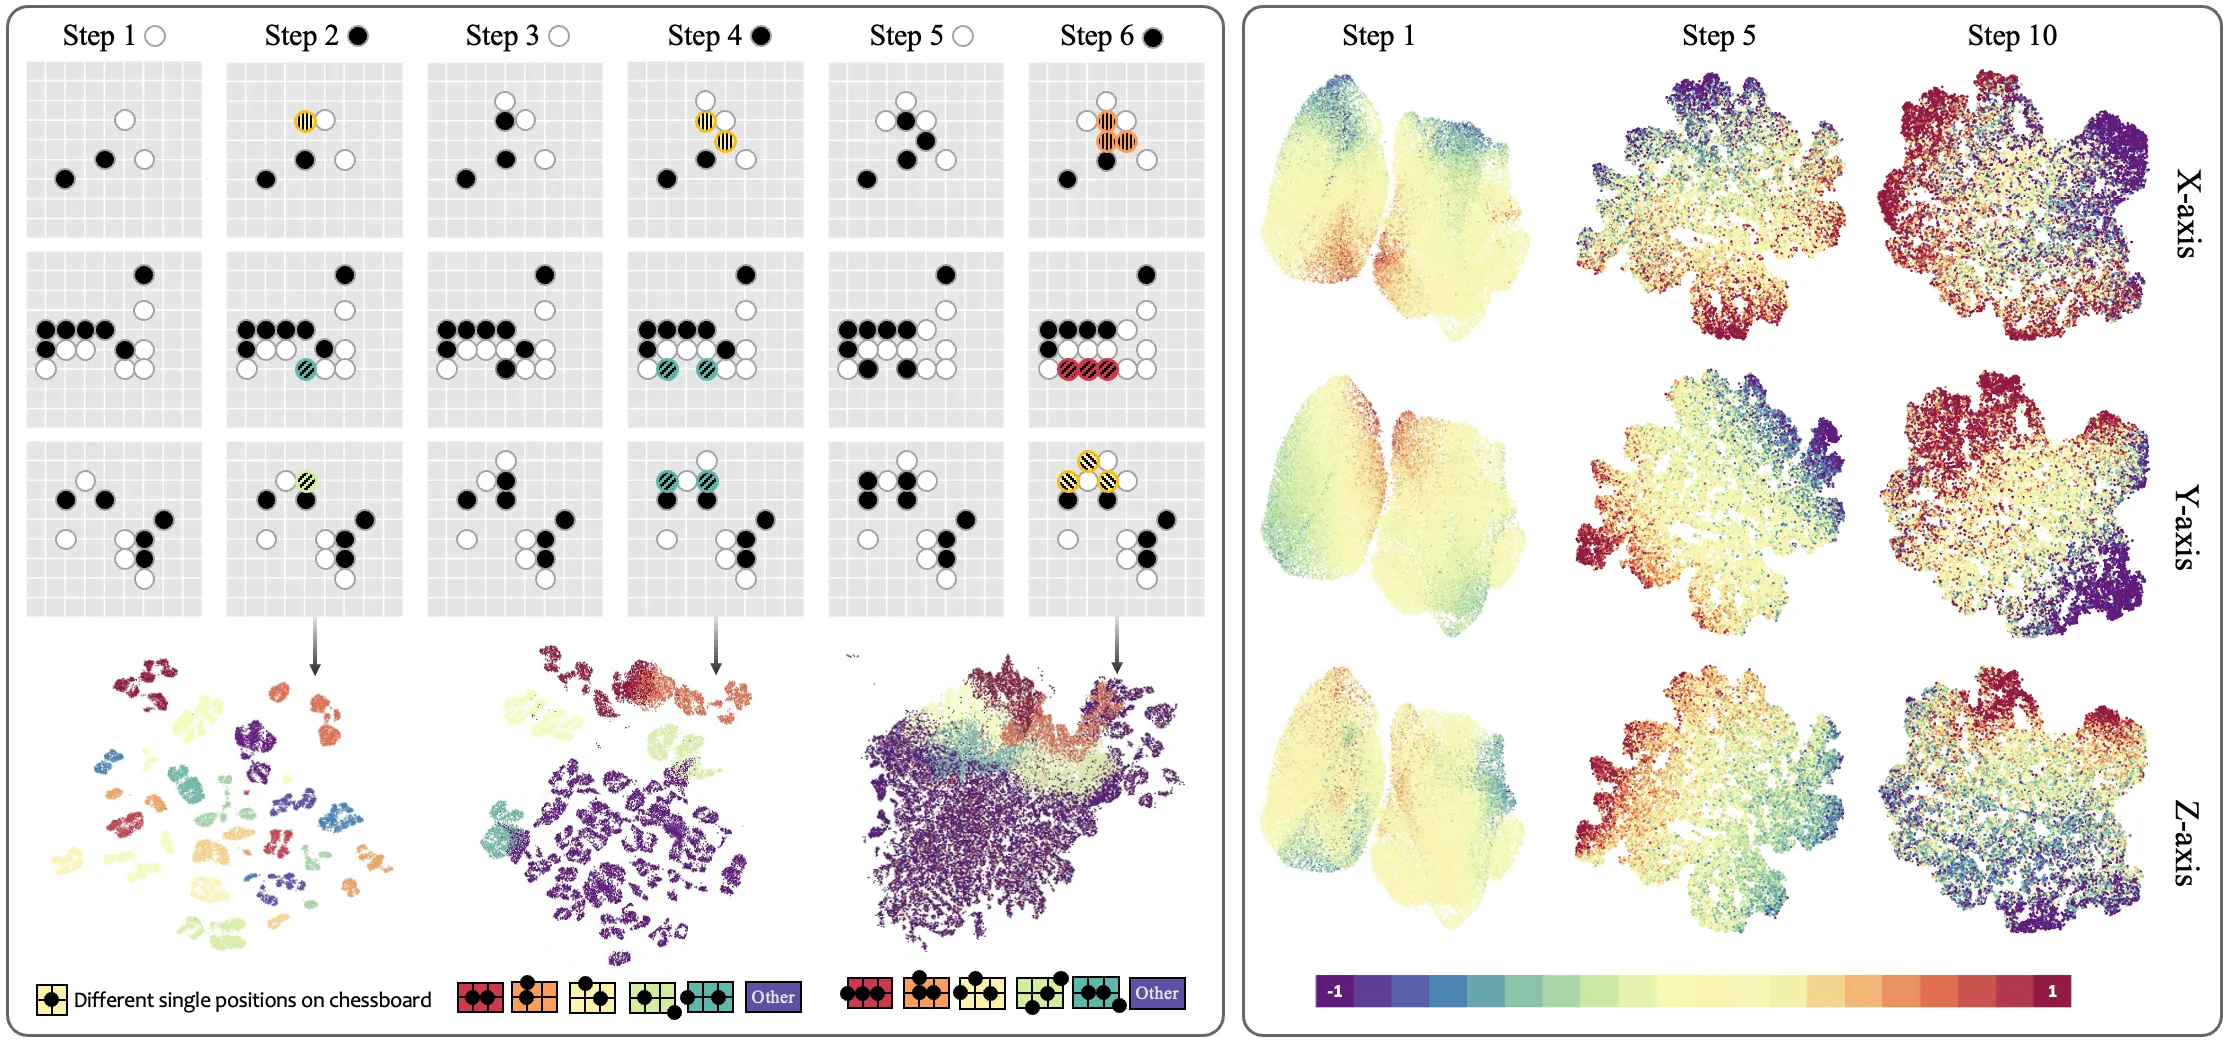
Механизм кодирования: сжатие визуальных изменений будущих H кадров в компактный непрерывный латентный код, который после квантования служит целью прогнозирования
Двухпоточное прогнозирование: совместная оптимизация генерации видеокадров и прогнозирования латентного кода для усиления моделирования ключевых узлов принятия решений
Интерпретируемый анализ: визуализация UMAP показывает, что кластеризация в латентном пространстве тесно связана с динамикой задач.
Конструктивные решения для повышения эффективности
Количество параметров модели контролируется на уровне 300 миллионов, что снижает вычислительные затраты на 80% по сравнению с традиционными видеомоделями
Масштаб обучающих данных: Video-GoBench содержит порядка ста тысяч кадров партий в го
III. Сценарии применения VideoWorld
Создание контента: обеспечивает мощную поддержку для производства коротких видео, разработки сцен в кино, генерации визуального контента в играх и т. д.
Образование: помогает учащимся более наглядно понимать сложные знания благодаря генерации динамических видеороликов.
Реклама: создание персонализированных рекламных видеороликов на основе предпочтений пользователей для повышения эффективности маркетинга.
IV. Загрузка и установка VideoWorld:
1. Клонирование репозитория:
git clone https://github.com/bytedance/VideoWorld.git
cd VideoWorld
2. Установка зависимостей:
pip install -r requirements.txt
3. Запуск примеров:Примеры кода обычно находятся в каталогах examples или scripts. При необходимости отредактируйте конфигурационный файл и запустите соответствующий скрипт.
V. Страница проекта VideoWorld:
Главная страница проекта: https://maverickren.github.io/VideoWorld.github.io
Адрес на GitHub: https://github.com/bytedance/VideoWorld
Ссылка на статью: https://arxiv.org/abs/2501.09781









