
 Помощник сценариста▸
 AI Приложения
 AI Новости
Что такое дистилляция больших моделей и в чём суть обвинений DeepSeek в «дистилляции моделей»?
小编 ·

Что такое дистилляция больших моделей и в чём суть обвинений DeepSeek в «дистилляции моделей»?
DeepSeek — это新兴 компания в области искусственного интеллекта, которая недавно привлекла к себе большое внимание из-за обвинений в использовании технологий Openai для дистилляции моделей. OpenAI утверждает, что DeepSeek мог извлечь знания её модели с помощью дистилляции, чтобы разработать конкурирующий продукт.
Что такое дистилляция больших моделей (Distillation)?
Дистилляция больших моделей — это метод сжатия моделей, целью которого является перенос знаний из одной большой и сложной модели (называемой моделью-учителем) в меньшую и более эффективную модель (называемую моделью-учеником). В ходе этого процесса модель-ученик обучается имитировать выходные данные модели-учителя, что позволяет сохранить производительность при снижении вычислительных затрат.
Эта концепция была предложена Хинтоном и другими исследователями в 2015 году и часто используется для сжатия моделей, ускорения вывода и снижения затрат на развёртывание при максимальном сохранении производительности исходной модели. Технология дистилляции широко применяется в глубоком обучении, особенно в таких областях, как обработка естественного языка и компьютерное зрение.
Ниже представлена интеллект-карта от автора YouTube-канала «Jeff 科技视角» Джефа Ли, которая поможет лучше понять эту тему. Учитель Джеф Ли очень подробно рассказал об этом в видео «Выпуск 379: Дистилляция больших моделей (Distillation) и обвинения, с которыми столкнулся DeepSeek».
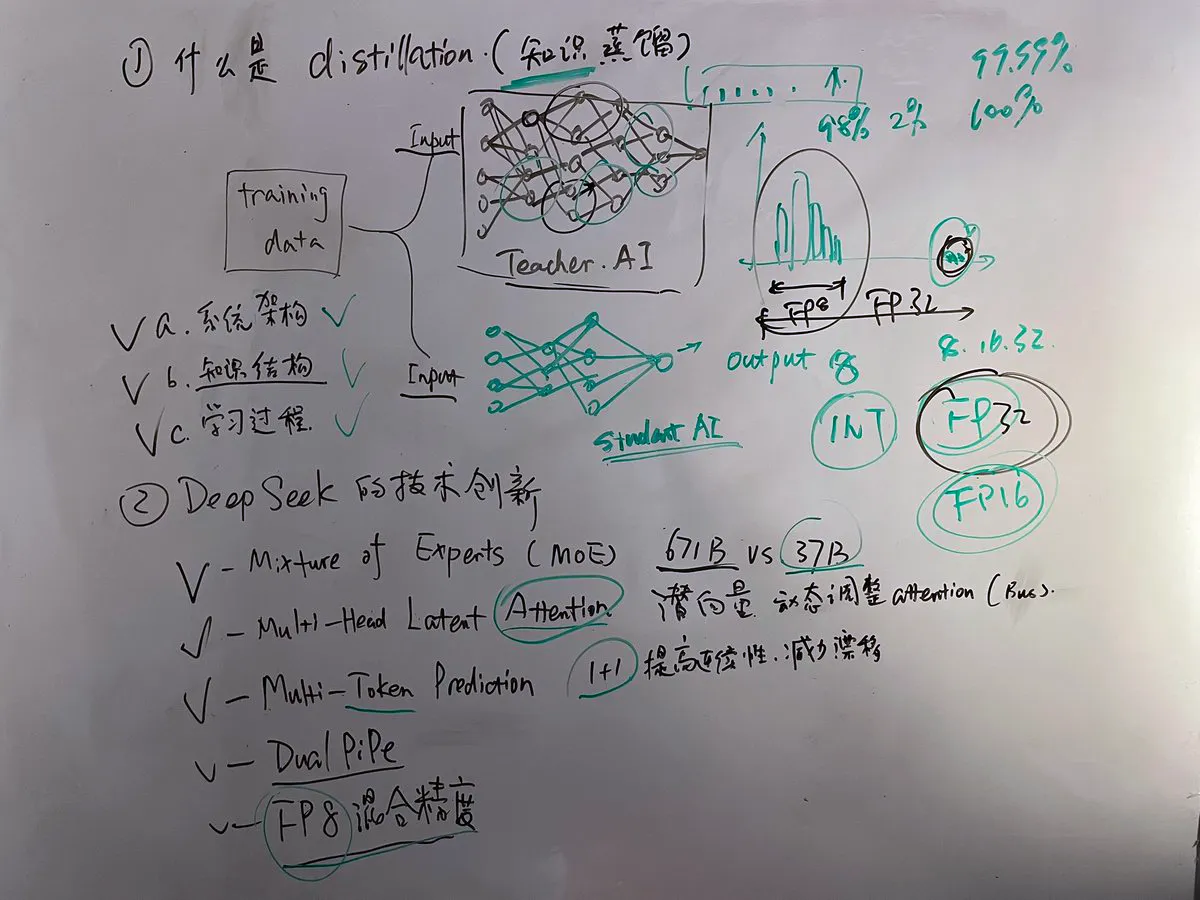
Способы реализации дистилляции больших моделей:
Мягкие метки (Soft Labels): для обучения используются распределения вероятностей, сгенерированные моделью-учителем, вместо жёстких меток.
Скрытые активации (Hidden Activations): часть выходных данных промежуточных слоёв модели-учителя используется в качестве вспомогательного сигнала для модели-ученика.
Веса внимания (Attention Weights): если речь идёт о последовательных моделях, также можно переносить соответствующую информацию механизма внимания.
Обвинение DeepSeek в «дистилляции моделей»
Предыстория:
DeepSeek — это начинающая компания, которая предлагает собственные продукты в области больших языковых моделей.
Низкозатратная разработка моделей DeepSeek, их открытый исходный код и бесплатная стратегия могут угрожать рыночным позициям таких компаний, как OpenAI и Anthropic, что привело к критике со стороны конкурентов, которые считают, что DeepSeek неправомерно использует их технологии и данные.
Ключевые моменты:
Позиция OpenAI
OpenAI обвиняет DeepSeek в том, что компания собирала и использовала нелицензированные данные для обучения собственных моделей.
Собственные проблемы: саму OpenAI также упрекали в незаконном сборе данных из интернета для обучения своих моделей, особенно защищённых авторским правом статей и произведений. Кроме того, OpenAI сталкивалась с судебными исками со стороны таких изданий, как The New York Times, по аналогичным основаниям.
Точка зрения Anthropic
Оспаривание серьёзности: Anthropic считает, что DeepSeek не представляет реальной угрозы для её продуктов, утверждая, что технический уровень компании соответствует лишь версии нескольких месячной давности.
Позиция Microsoft
Microsoft разместила модели DeepSeek на своих платформах Azure AI и GitHub, продемонстрировав определённую форму поддержки, что также вызвало дискуссии о конфликте интересов.
Конкретные споры вокруг дистилляции моделей
Законность и нормативное регулирование: дистилляция моделей является распространённой технической практикой, но на практике она подчиняется строгим правилам. Особенно это касается положений о коммерческом использовании и соглашений о техническом обмене, которые разные компании трактуют и применяют по-разному.
Как определить, что данные были получены «несанкционированным способом»?
Допускается ли использование данных, полученных через определённые API, для обучения новых конкурирующих моделей?
Доказательства и подтверждающие материалы: в настоящее время ни одна из сторон полностью не раскрыла подробных доказательств в поддержку своих утверждений, что повышает сложность и неопределённость ситуации.
Реакция отрасли и общественное мнение
Мнения по этому вопросу как внутри сообщества, так и за его пределами расходятся: некоторые считают это проявлением конкурентной борьбы на рынке; однако многие обращают внимание на то, были ли в достаточной мере соблюдены этические и правовые нормы, стоящие за этим делом.
Обвинения в «дистилляции моделей», с которыми столкнулся DeepSeek, отражают острую конкурентную борьбу, существующую в современной индустрии ИИ, а также вызовы, связанные с правовой неопределённостью в вопросах прав на использование данных и границ технологических инноваций.









