
 Помощник сценариста▸
 AI Приложения
 AI Новости
Alibaba Qwen представляет модель нового поколения vision-language: Qwen2.5-VL
小编 ·

Alibaba Qwen представляет модель нового поколения vision-language: Qwen2.5-VL
阿里Qwen2.5-VL — это новая модель визуального понимания, выпущенная командой Alibaba Tongyi Qianwen. Эта модель обладает мощными возможностями визуального понимания, агентскими функциями, пониманием длинных видео и распознавания событий, и направлена на продвижение применения и развития ai во многих областях.
Основные функции Qwen2.5-VL
Визуальное понимание: Qwen2.5-VL способна точно распознавать распространённые объекты на изображениях, такие как цветы, птицы, рыбы и насекомые, а также анализировать текст, диаграммы, значки, графики и макеты на изображениях. Благодаря этому она отлично справляется с обработкой визуальной информации и может предоставлять пользователям детальные результаты анализа изображений.
Понимание видео: Модель обладает прорывной возможностью понимания видео продолжительностью более 1 часа и способна распознавать и анализировать конкретные события в видео. Эта функция даёт Qwen2.5-VL значительное преимущество в анализе и обработке видеоконтента.
Возможности динамического рассуждения: Qwen2.5-VL обладает способностями динамического рассуждения и может принимать сложные решения и выполнять действия на основе визуальной среды и текстовых инструкций. Это позволяет ей выступать в роли визуального ИИ-агента, напрямую управляющего такими устройствами, как смартфоны и компьютеры.
Версии разного размера: Qwen2.5-VL предлагается в трёх версиях различного масштаба — 3B, 7B и 72B, что позволяет пользователям выбирать подходящую версию в зависимости от потребностей для удовлетворения различных вычислительных ресурсов и сценариев применения.
Основные характеристики
Версии разного размера
Доступны три версии с различным количеством параметров — 3B, 7B и 72B, каждая из которых подходит для разных сценариев применения и конфигураций оборудования.
Версия 3B: подходит для мобильных устройств и других сред с ограниченными ресурсами.
Версия 7B: баланс между производительностью и потреблением ресурсов, подходит для большинства сценариев применения.
Версия 72B: версия с наивысшей производительностью, подходит для приложений, требующих высокой точности и мощных функций.
Передовые функции
Возможности визуального позиционирования: способность точно определять объекты на изображении и возвращать информацию об их расположении в виде координат.
Универсальное распознавание изображений: способность распознавать не только распространённые объекты (такие как цветы, птицы, рыбы), но и анализировать такие элементы изображений, как текст, диаграммы, значки и т. д.
Анализ документов: значительно улучшены возможности понимания документов и таблиц, особенно в решении академических задач, математических способностях и проверке документов.
Понимание видео: поддержка понимания длительного видео (до нескольких часов) с возможностью локализации событий с точностью до секунды, суммирования основных моментов видео и извлечения ключевой информации.
Визуальный агент: способность управлять компьютерами и смартфонами без специальной донастройки под конкретную задачу, выполняя сложные задачи рассуждения и принятия решений.
Распознавание и понимание текста: улучшенные возможности OCR, поддержка распознавания текста и извлечения информации в нескольких сценариях, на разных языках и в разных направлениях.
Улучшения
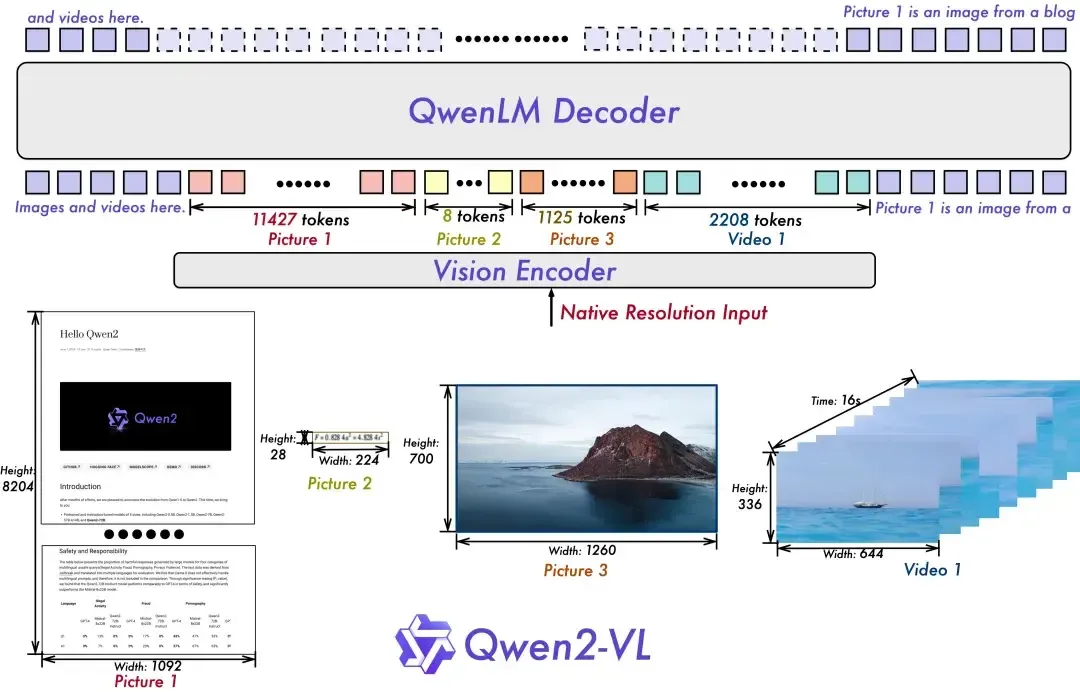
Способность пространственно-временного восприятия: улучшено восприятие моделью временных и пространственных масштабов, что позволяет ей лучше понимать и обрабатывать данные различных типов.
Упрощение сетевой структуры: введён механизм оконного внимания, снижающий вычислительную нагрузку и повышающий эффективность модели.
Динамическое разрешение: использование ViT с нативным динамическим разрешением обеспечивает сохранение нативного разрешения модели при одновременном снижении вычислительной нагрузки.
Производительность
Лидерство во многих бенчмарках: модель демонстрирует выдающиеся результаты в бенчмарках во многих областях, особенно превосходя конкурирующие модели в задачах понимания документов, визуальных вопросов-ответов, понимания видео и визуального агента.
Конкретные примеры:
Понимание документов: отличные результаты в таких задачах, как DocVQA.
Понимание видео: способность точно понимать видеоконтент длительностью до нескольких часов, быстро находить и резюмировать важные события.
Визуальный агент: возможность выполнять сложные задачи автоматизации, такие как управление устройствами и программными интерфейсами, без дополнительной настройки.
Сценарии применения Qwen2.5-VL
Интеллектуальное обслуживание клиентов: Qwen2.5-VL может применяться в сценариях видеообслуживания клиентов, анализируя в реальном времени изображения товаров или штрих-коды, показанные пользователями, и предоставляя соответствующую информацию о продуктах.
Финансовая и коммерческая сферы: модель поддерживает структурированный вывод и подходит для обработки данных счетов, форм и т. д., что особенно актуально для приложений в финансовой и коммерческой сферах.
Образование и обучение: в образовательной сфере Qwen2.5-VL может использоваться для анализа учебных видео, помогая студентам понимать сложные концепции и материалы.
Анализ медицинских изображений: возможности визуального понимания модели также могут применяться для анализа медицинских изображений, помогая врачам лучше интерпретировать данные визуализации.
Модель Qwen2.5-VL сохраняет архитектуру предыдущего поколения Qwen-VL, используя последовательную структуру ViT (визуальный трансформер) и Qwen2, поддерживающую единый ввод изображений и видео. Такая конструкция позволяет модели лучше объединять визуальную и языковую информацию, повышая способность понимания мультимодальных данных. Кроме того, в Qwen2.5-VL введено мультимодальное позиционное кодирование вращения (M-ROPE), которое разлагает позиционное кодирование на три части — временную и пространственную (высота и ширину), тем самым усиливая мультимодальные возможности обработки и рассуждения модели. Модель также обладает способностью распознавания изображений с любым разрешением, что позволяет обрабатывать изображения с разным разрешением и соотношением сторон, обеспечивая согласованность входных данных и информации изображения.
Как получить Qwen2.5-VL:
Адрес open-source: Hugging Face
Github: Qwen2.5-VL
Онлайн-версия: Qwen Chat









