
 Помощник сценариста▸
 AI Приложения
 AI Новости
DeepSeek R1: открытая модель логического вывода от DeepSeek, конкурирующая с OpenAI o1
小编 ·

DeepSeek R1: открытая модель логического вывода от DeepSeek, конкурирующая с OpenAI o1
Что такое DeepSeek R1?
DeepSeek R1 — это открытая модель рассуждений большого размера, выпущенная китайской компанией в области искусственного интеллекта DeepSeek. Благодаря технологическому подходу, основанному на обучении с подкреплением, она демонстрирует производительность, сопоставимую с официальной версией модели o1 от OpenAI, в сложных задачах, таких как математика, программирование и логическое рассуждение на естественном языке, и особенно выделяется в задачах на рассуждение. В ней применяется технология обучения с подкреплением, что значительно повышает способность модели к рассуждению и обеспечивает эффективное обучение при минимальном объёме размеченных данных. Такой подход также даёт DeepSeek-R1 преимущество в стоимости: утверждается, что затраты на её работу составляют лишь 3% от затрат OpenAI.
Ключевые технологии DeepSeek R1:
1. Способность к рассуждению на основе обучения с подкреплением
Обучение с использованием чистого обучения с подкреплением (RL): DeepSeek R1-Zero напрямую применяет масштабное обучение с подкреплением к базовой модели без контролируемого дообучения (SFT), впервые подтвердив, что чистое RL может стимулировать способность LLM к рассуждению. Модель использует алгоритм GRPO (Group Relative Policy Optimization) для снижения затрат на обучение и применяет систему вознаграждений на основе правил (вознаграждение за точность и вознаграждение за формат) для формирования структурированной цепочки рассуждений (CoT).
Оптимизация с помощью данных холодного старта: для решения проблем читаемости и смешения языков в R1-Zero, в DeepSeek R1 вводится небольшой объём данных холодного старта (примеры длинных цепочек рассуждений), а многоэтапное обучение (дообучение на холодном старте → RL с уклоном в рассуждения → RL для всех сценариев) повышает читаемость и универсальность выходных данных.
Длинные цепочки рассуждений и дистилляция моделей
Поддержка сверхдлинных цепочек рассуждений: поддерживается контекстное окно 128K, что позволяет разбивать сложные задачи на многоэтапные рассуждения, например генерировать подробные выводы объёмом в десятки тысяч символов при решении математических задач.
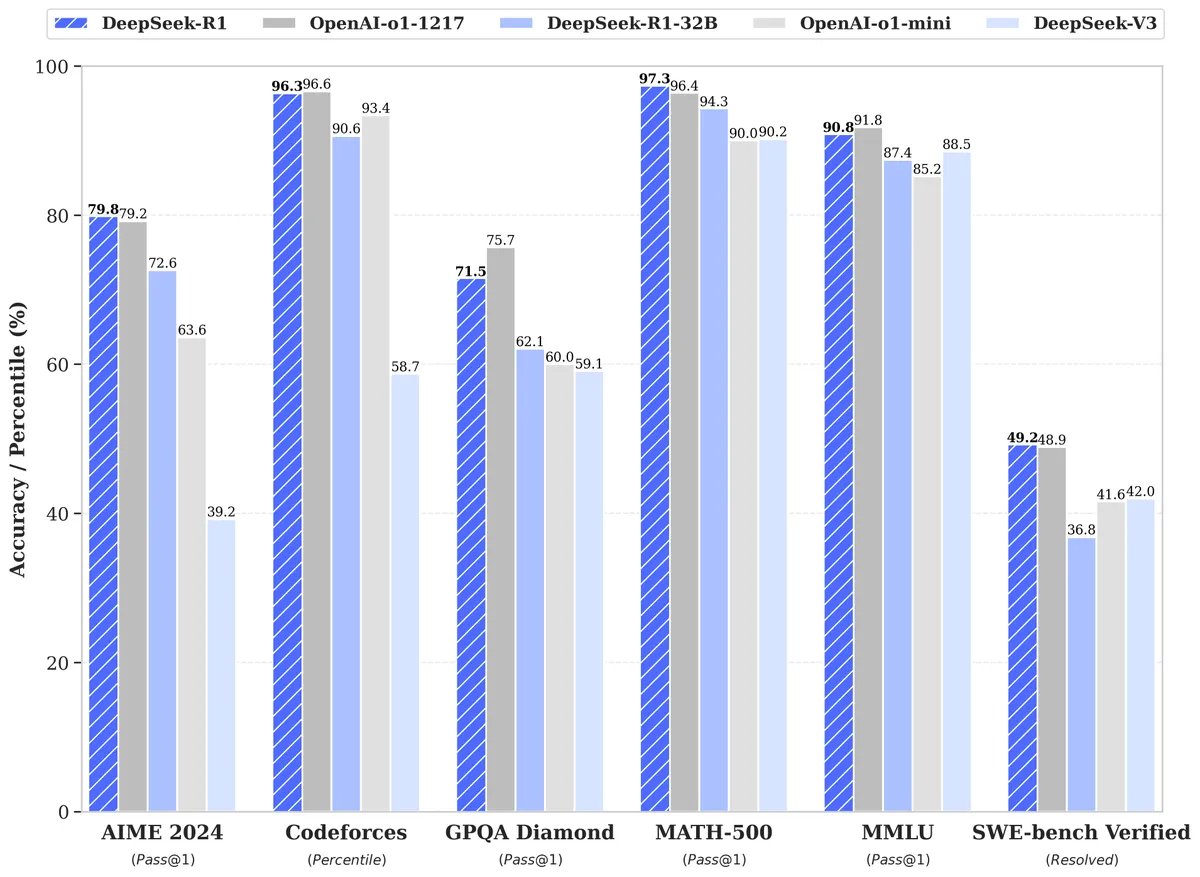
Эффективная технология дистилляции: способность R1 к рассуждению дистиллируется на 800 тыс. образцов в компактные модели серий Qwen и Llama (например, 7B, 32B, 70B). Дистиллированная версия Qwen-32B достигает точности pass@1 72,6% в тесте AIME 2024, приближаясь к производительности o1-mini.
2. Результаты производительности и бенчмарки
Математика и программирование
Уровень математических олимпиад: точность pass@1 модели R1 в AIME 2024 (Американский математический конкурс) достигает 79,8%, а в бенчмарке MATH-500 она набирает 97,3%, превосходя OpenAI-o1-1217. В тесте с самыми сложными задачами китайского единого государственного экзамена по математике (Gaokao) R1 справляется за 83 секунды, однако имеет недостатки в строгости оформления шагов решения.
Экспертный уровень генерации кода: в соревнованиях Codeforces получает рейтинг Elo 2029 (превосходя 96,3% участников-людей), а в тесте LiveCodeBench показатель pass@1 составляет 65,9%. По данным пользовательских тестов, R1 генерирует код для визуализации квантовой механики всего за 9 минут, и он сразу готов к запуску.
Задачи на общие языковые знания
Комплексные способности в разных областях: в тесте MMLU (многоаспектное понимание языка) набирает 90,8%, в MMLU-Pro — 84%, в GPQA Diamond — 71,5%, что значительно превосходит DeepSeek-V3 и приближается к OpenAI-o1.
Гуманитарные науки и историческое рассуждение: правильность ответов на китайские загадки-«головоломки» достигает 100%; на сложные исторические вопросы, такие как история Древнего Египта и коренные народы Африки, модель также даёт логически стройные и информативные ответы, превосходя по информационному наполнению модели без рассуждений.
3. Открытая экосистема и преимущество в низкой стоимости
Стратегия открытого исходного кода и благоприятные условия для бизнеса
Открытый исходный код по лицензии MIT: полная модель (671B параметров) и 6 дистиллированных моделей (от 1,5B до 70B) полностью открыты и допускают бесплатное коммерческое использование, модификацию и дальнейшую разработку. Например, дистиллированная версия Qwen-14B может работать на оборудовании настольного класса, набирая 53,1% в LiveCodeBench.
Революция в ценообразовании API: стоимость входных токенов составляет всего 1 юань за миллион (при попадании в кэш), а выходных — лишь 16 юаней за миллион, что составляет около 3,7% от цены OpenAI-o1. По данным пользовательских тестов, стоимость одного вызова API может составлять всего 0,06 доллара США.
Инструменты для разработчиков и поддержка интеграции
Развёртывание на разных платформах: поддерживаются Hugging Face, фреймворк vLLM и интеграция со Spring AI; разработчики могут вызвать модель с помощью простой настройки. Например, пользователям Spring AI достаточно добавить зависимость и настроить API-ключ для подключения.
Оптимизация стабильности рассуждений: в API по умолчанию отключён параметр temperature, что обеспечивает стабильность результатов, а цепочка рассуждений и окончательный ответ возвращаются в отдельных полях reasoning_content и content соответственно.
4. Сценарии применения
Научные исследования и образование: помощь в математическом моделировании, генерации кода и историческом анализе с подробным изложением хода рассуждений для поддержки академических исследований. Например, генерация кода для анимации квантовой механики или разбор сложных математических задач.
Корпоративный интеллект: интеграция в системы обслуживания клиентов, инструменты анализа данных или платформы автоматизированного принятия решений, что снижает затраты на внедрение ИИ.
Благодаря открытой стратегии и сверхнизкой стоимости (затраты на обучение составляют 5,576 млн долларов США, что примерно в 10 раз меньше, чем у GPT-4) R1 развязывает ценовую войну в отрасли; такие компании, как Meta, уже создали специальные группы для изучения её технологического подхода.
Эксперты, такие как Ян ЛеКун, считают, что успех R1 знаменует переход моделей с открытым исходным кодом от роли «догоняющих» к роли «лидеров», стимулируя глобальное сотрудничество разработчиков и технологические инновации.
DeepSeek R1, обладая способностью к рассуждению на основе обучения с подкреплением и стратегией открытого исходного кода при низкой стоимости, стал важным прорывом в области ИИ. Модель не только превосходно справляется с профессиональными задачами в математике и программировании, но и благодаря открытой экосистеме способствует глобальным технологическим инновациям, предлагая новую парадигму для развития AGI.









