
 Помощник сценариста▸
 AI Приложения
 AI Новости
Alibaba официально выпустила открытую большую модель Qwen2.5-1M
小编 ·

Alibaba официально выпустила открытую большую модель Qwen2.5-1M
Alibaba официально выпустила открытую большую модель Qwen2.5-1M 27 января 2025 года. Это первый случай, когда команда Tongyi Qianwen расширила длину контекста открытой модели до 1 миллиона токенов (что эквивалентно примерно 10 объёмным романам или 30 000 строкам кода), добившись значительного прорыва в производительности при обработке длинных текстов.
I. Основные особенности Qwen2.5-1M
Поддержка сверхдлинного контекста: модель Qwen2.5-1M поддерживает обработку контекста до 1 миллиона токенов, что эквивалентно примерно 1 миллиону английских слов или 1,5 миллиона китайских иероглифов. Эта возможность позволяет модели обрабатывать объёмные документы, такие как книги, юридические файлы и длинные отчёты, без необходимости утомительного разделения текста.
Различные размеры моделей: в этот выпуск вошли модели Qwen2.5-7B-Instruct-1M и Qwen2.5-14B-Instruct-1M, предоставляющие различные масштабы параметров для удовлетворения потребностей различных сценариев применения.
Эффективный фреймворк вывода: команда Qwen открыла исходный код фреймворка вывода на базе vLLM, интегрированного с механизмом разреженного внимания, что обеспечивает ускорение скорости обработки входных данных объёмом 1M токенов в 3–7 раз. Такая эффективность позволяет разработчикам быстрее развёртывать и применять модель.
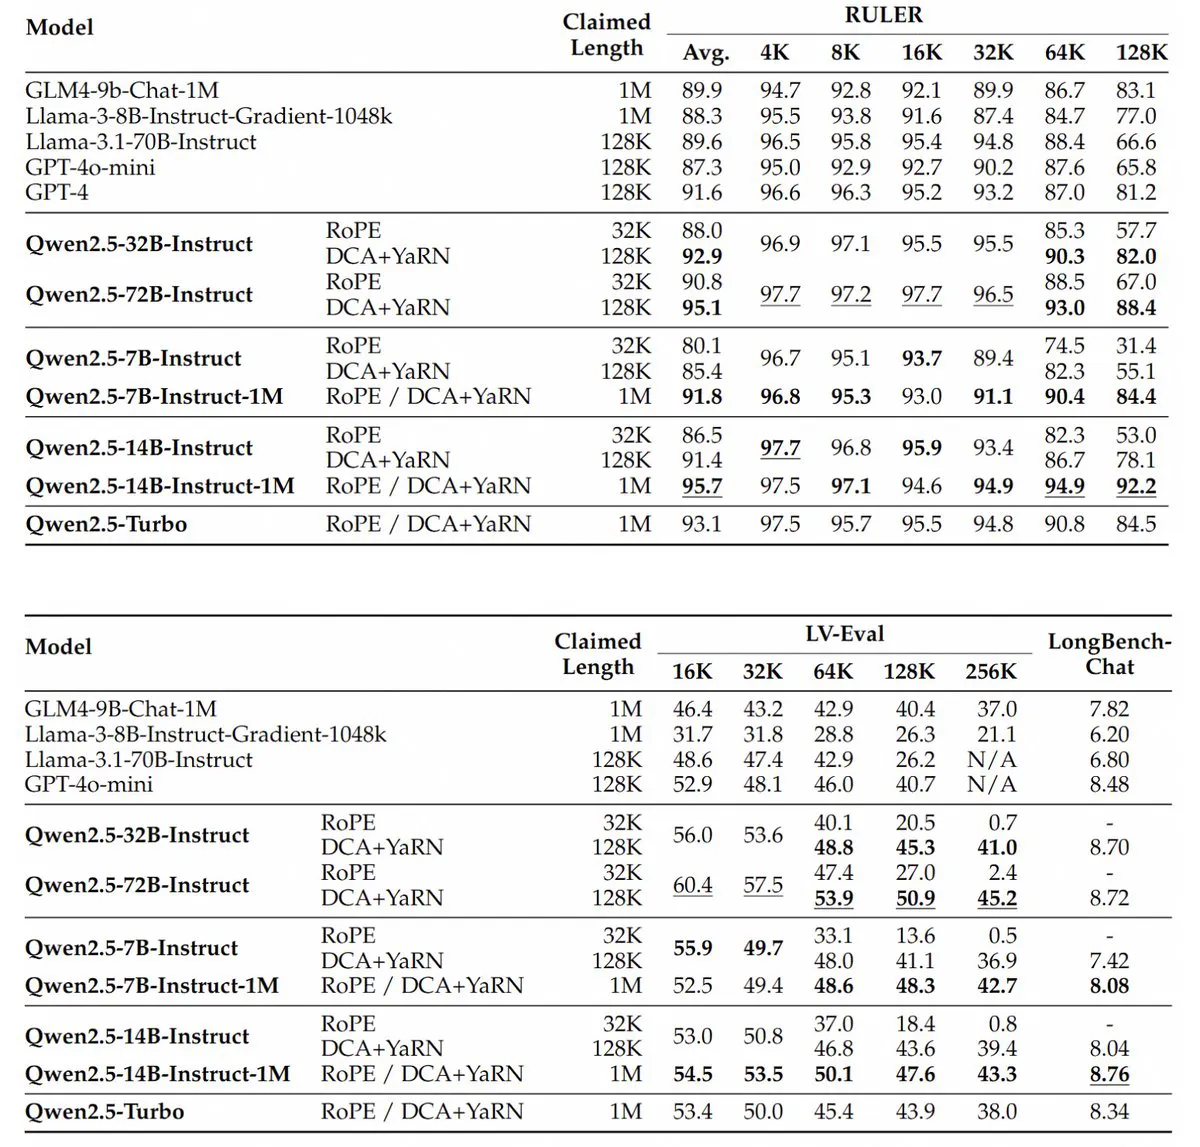
Преимущества в производительности: в задачах с длинным текстом модель Qwen2.5-1M значительно превосходит предыдущую версию с 128K, особенно при обработке задач длиной более 64K, демонстрируя более сильные возможности.
II. Характеристики модели и показатели производительности
Возможности обработки длинного контекста
Поддержка миллиона токенов: серия Qwen2.5-1M включает версии 7B и 14B с нативной поддержкой длины контекста 1M токенов, что позволяет обрабатывать объёмные документы, репозитории кода или сложные многоэтапные диалоги без необходимости сегментации ввода.
Точный поиск и понимание: в задаче «Иголка в стоге сена» (Passkey Retrieval) модель способна точно извлекать скрытую информацию из документа объёмом 1M токенов; лишь версия 7B допускает небольшое количество ошибок. В бенчмарках понимания длинного текста, таких как RULER, LV-eval и других, версия 14B стабильно превосходит собственную закрытую модель Qwen2.5-Turbo и GPT-4o-mini от Openai.
Совместимость с задачами на коротком тексте
Модели 7B и 14B показывают производительность в задачах на коротком тексте (таких как ответы на вопросы и составление резюме), сопоставимую с версией 128K, не жертвуя базовой производительностью ради расширенных возможностей длинного контекста. Например, модель 14B по производительности в задачах на коротком тексте близка к GPT-4o-mini, но при этом длина её контекста в 8 раз больше.
III. Технологические прорывы и открытый фреймворк
Прогрессивное обучение и экстраполяция длины
Поэтапное расширение: от предварительного обучения до контролируемого дообучения длина контекста постепенно расширяется с 4K до 256K, после чего способность выравнивания на коротких текстах оптимизируется с помощью обучения с подкреплением56.
Dual Chunk Attention (DCA): введена инновационная технология экстраполяции позиционного кодирования, которая позволяет расширить поддерживаемую длину контекста модели с 256K до 1M без дополнительного обучения, решая проблему деградации внимания при кодировании дальних позиций.
Оптимизация эффективного вывода
Механизм разреженного внимания: на базе фреймворка vLLM интегрирован механизм разреженного внимания (MInference) в сочетании с поблочным предварительным заполнением и технологией динамического параллелизма, что обеспечивает ускорение скорости вывода для входных данных объёмом 1M токенов в 3,2–6,7 раз и значительное снижение потребления памяти (например, память активации модели 7B сокращается на 96,7%).
Поддержка открытого фреймворка: исходный код фреймворка вывода и технический отчёт об обучении полностью открыты, что позволяет разработчикам быстро развёртывать модель и поддерживает квантование FP8 для снижения требований к оборудованию.
IV. Сценарии применения
Генерация текста: модель Qwen2.5-1M может использоваться для создания объёмных статей, отчётов и рассказов, что подходит для таких областей, как создание контента, новостная журналистика и т. д.
Информационный поиск: благодаря возможности обработки сверхдлинного контекста модель способна эффективно осуществлять поиск информации в длинных текстах, что подходит для отраслей, требующих обработки больших объёмов документов, таких как юриспруденция и медицина.
Диалоговые системы: данная модель может использоваться для создания интеллектуальных диалоговых систем, способных понимать и генерировать сложный диалоговый контент, улучшая пользовательский опыт.
Мультимодальные приложения: архитектура модели Qwen2.5-1M позволяет ей сочетаться с другими модальностями (такими как изображения и аудио), расширяя область применения до задач мультимодального понимания и генерации.
Выпуск Qwen2.5-1M не только заполнил пробел в области обработки сверхдлинного контекста среди открытых моделей, но и благодаря технологическим инновациям и открытой экосистеме предоставил разработчикам высокопроизводительный и доступный выбор инструментов. Его успех может ускорить глобальное исследование применений длинного текста в индустрии ИИ и способствовать повышению роли сообщества открытого ПО в гонке за AGI.









