
 Помощник сценариста▸
 AI Приложения
 AI Новости
FunAudioLLM: голосовой ИИ-прорыв от Alibaba
小编 ·

FunAudioLLM: голосовой ИИ-прорыв от Alibaba
FunAudioLLM — это набор моделей обработки речи, разработанный компанией Alibaba и предназначенный для улучшения голосового взаимодействия между человеком и большими языковыми моделями. Он состоит из двух основных моделей: SenseVoice и CosyVoice.
SenseVoice: модель распознавания речи, способная распознавать речь на множестве языков, определять эмоции говорящего и обнаруживать особые события в аудио (например, музыку, смех и т. п.). Она обеспечивает быструю и точную транскрипцию речевого содержания.
CosyVoice: модель генерации речи, основное назначение которой — создание естественной и эмоционально насыщенной речи. Она может имитировать разных говорящих и даже клонировать голос человека по нескольким секундам аудиозаписи.
Благодаря сочетанию SenseVoice и CosyVoice, FunAudioLLM обеспечивает комплексные возможности понимания и генерации речи, делая голосовое взаимодействие между человеком и большими языковыми моделями более естественным и разнообразным.
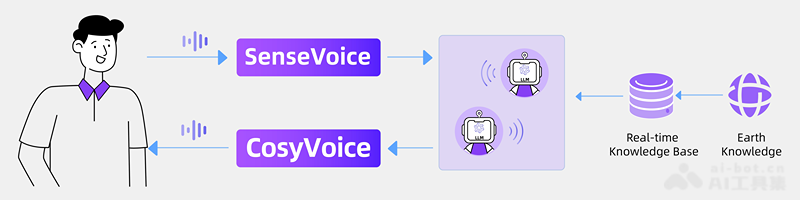
Основные особенности SenseVoice и CosyVoice:
SenseVoice ориентирована на многоязычное распознавание речи, распознавание эмоций и обнаружение аудиособытий, обеспечивая высокоточную обработку речи с низкой задержкой. CosyVoice ориентирована на естественную генерацию речи и управление ею, поддерживает генерацию на нескольких языках, с разными тембрами и стилями речи, а также позволяет выполнять обучение без примеров (zero-shot) и осуществлять тонкое управление речью. Сочетание обеих моделей даёт FunAudioLLM возможность обеспечивать превосходное качество голосового взаимодействия в широком спектре сценариев применения.
Основные особенности SenseVoice
1. Многоязычное распознавание речи
SenseVoice-Small: поддерживает пять языков — китайский, английский, кантонский, японский и корейский. Архитектура модели неавторегрессионная и сквозная (end-to-end), что обеспечивает крайне низкую задержку распознавания. Она работает в 5 раз быстрее Whisper-small и в 15 раз быстрее Whisper-large.
SenseVoice-Large: высокоточное распознавание речи с поддержкой более 50 языков.
2. Распознавание эмоций
Распознавание эмоций в речи (таких как радость, грусть, гнев и др.) путём анализа высоты тона, ритма и изменения интонации.
3. Обнаружение аудиособытий
Обнаружение особых событий в речи, таких как музыка, смех, аплодисменты и т. п., с предсказанием времени начала и окончания события.
SenseVoice-Small способна обнаруживать различные события взаимодействия человека с компьютером, такие как фоновая музыка, аплодисменты, смех, плач, кашель, чихание и др.
4. Идентификация языка
Способность определять язык, на котором говорит говорящий, что обеспечивает точность распознавания речи и понимания контекста.
5. Обратная текстовая нормализация (ITN)
Предоставление транскрипций с пунктуацией и форматированием, что повышает читаемость и точность распознанного текста.
Основные особенности FunAudioLLM:
Многоязычное распознавание речи: более 400 000 часов обучающих данных, производительность распознавания превосходит модели Whisper.
Высокоэффективное распознавание: модель SenseVoice-Small использует неавторегрессионную сквозную архитектуру с крайне низкой задержкой. Обработка 10 секунд аудио занимает всего 70 миллисекунд, что в 15 раз быстрее Whisper-Large.
Распознавание эмоций: на нескольких тестовых наборах данных достигает результатов, соответствующих лучшим на сегодняшний день моделям распознавания эмоций.
Обнаружение событий: поддержка обнаружения различных распространённых аудиособытий.
Удобная дообучение: предоставляются удобные скрипты и стратегии дообучения, позволяющие пользователям легко решать проблему редких (длиннохвостовых) примеров в зависимости от бизнес-сценария.
Развёртывание сервиса: предоставляется конвейер развёртывания сервиса с поддержкой множества параллельных запросов; поддерживаемые языки клиентов включают Python, C++, HTML, Java, C# и др.
Основные особенности CosyVoice:
1. Генерация речи
Поддержка многоязычной генерации речи, включая китайский, английский, кантонский, японский и корейский языки.
Способность генерировать естественную и эмоционально насыщенную речь с поддержкой различных стилей речи и эмоциональной выразительности.
2. Разнообразное управление речью
Управление тембром: возможность точно управлять тембром генерируемой речи, обеспечивая её соответствие голосу конкретного говорящего.
Управление стилем речи: управление стилем речи с помощью текстовых команд, таких как эмоции, скорость и тон.
3. Обучение без примеров (Zero-Shot)
Для клонирования голоса достаточно всего нескольких секунд аудиозаписи; дополнительные обучающие данные не требуются.
Поддержка межъязыкового клонирования голоса, позволяющая говорить на одном языке голосом, принадлежащим другому языку.
4. Тонкое управление паралингвистическими характеристиками
Поддержка вставки таких тонких речевых элементов, как смех, дыхание, модальные частицы и т. п., что делает сгенерированную речь более естественной и живой.
Управление текстовыми командами: с помощью текстовых команд можно точно управлять личностью говорящего, его эмоциями и стилем речи.
5. Многоперсонажный диалог
Способность генерировать речь для диалогов с участием нескольких персонажей, что подходит для таких сценариев, как интерактивные подкасты и эмоциональные чаты.
Адрес проекта: https://github.com/FunAudioLLM









