
 Помощник сценариста▸
 AI Приложения
 AI Новости
Seed-ASR: модель автоматического распознавания речи от ByteDance

Seed-ASR: модель автоматического распознавания речи от ByteDance
Seed-ASR, модель автоматического распознавания речи от ByteDance, способна преобразовывать различные голосовые сообщения в текстовую информацию. В отличие от традиционных TTS-систем, ориентированных на одну задачу, Seed-TTS может моделировать множество голосов и допускает одновременное управление по многим параметрам, распознавая разные языки, диалекты, акценты и даже такие речевые особенности, как проглатывание слов.Seed-ASR была обучена на более чем 20 миллионах часов аудиоданных и почти 900 тысячах часов парных данных ASR.Система поддерживает не только мандаринский диалект, но и 13 китайских диалектов, 7 иностранных языков, а также английский язык с различными акцентами.
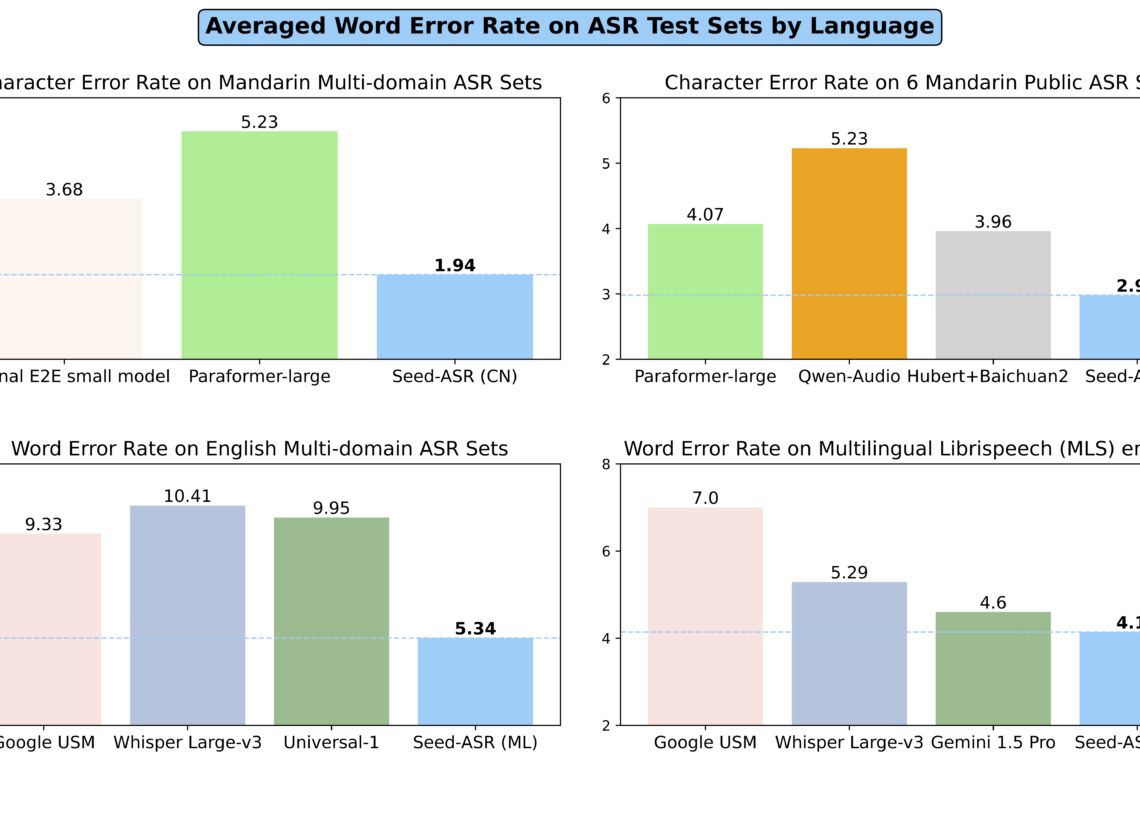
Seed-ASR обладает мощными возможностями контекстного анализа и способна распознавать речевой контент в определённом контексте. Например, модель может использовать историю диалогов или записи совещаний для более точного распознавания имён, географических названий и других контекстно-зависимых ключевых слов в текущей речи.
Seed-ASR обладает высокой масштабируемостью. Это означает, что она представляет собой не просто фиксированную систему, а платформу, которую можно настраивать в соответствии с конкретными потребностями. Например, если вы хотите, чтобы она специализировалась на распознавании медицинских терминов или понимании определённого акцента, это можно реализовать путём дообучения модели.
Ключевая технология Seed-ASR заключается в интеграции большой языковой модели в систему распознавания речи, что обеспечивает возможности контекстного понимания. Это не простое объединение двух систем, а фундаментальное изменение подхода к обработке речи. Это как если бы системе распознавания речи установили «супермозг», который не только слушает, но и думает.
Технические преимущества Seed-ASR:
Высокая точность распознавания: обработка сложных речевых входных данных с помощью модели с миллиардами параметров обеспечивает высокую точность распознавания.
Модель большой ёмкости: использование большой языковой модели повышает точность распознавания речи и возможности контекстного понимания — это как использовать «суперкомпьютер» для диктовки ваших заметок, что звучит впечатляюще.
Поддержка множества языков: включает мандаринский диалект, 13 китайских диалектов, а также множество иностранных языков, с планами по расширению до более чем 40 языков.
Контекстное восприятие: способность использовать контекстную информацию для повышения точности распознавания — подобно тому, как в разговоре с другом система понимает, о чём шла речь ранее, и на основе этой информации точнее интерпретирует текущую реплику.
Поэтапный метод обучения: включает самообучение с самоконтролем, контролируемое дообучение, контекстное дообучение и обучение с подкреплением, что позволяет постепенно наращивать возможности модели.
Сценарии применения Seed-ASR:
Человеко-машинное взаимодействие: обеспечение голосового ввода путём преобразования речи в текст в реальном времени для быстрого и удобного взаимодействия с устройствами, оборудованием и приложениями.
Модерация контента: преобразование аудиозаписей в текст и анализ текста с помощью правил контроля качества для своевременного выявления и обработки нарушений.
Транскрибирование совещаний и интервью: преобразование аудио совещаний и интервью в текст в реальном времени или асинхронно с автоматическим разделением речевых фрагментов, что снижает затраты и повышает эффективность.
Субтитры для аудио- и видеоматериалов: автоматическое распознавание и преобразование речи и текстов песен из аудио- и видеоматериалов в текст, создание субтитров, соответствующих аудио- и видеоконтенту, в один клик.
Seed-ASR уже применяется в приложении Doubao и используется пользователями для англоязычных бесед, виртуальных собеседников, копирования голосов близких и в ряде других сценариев. Для корпоративных клиентов Seed-ASR также реализована на платформе Volcano Engine в сценариях голосового взаимодействия, модерации контента, транскрибирования совещаний и интервью, создания субтитров для аудио- и видеоматериалов.
На сегодняшний день команда Dou Large Model, занимающаяся речевыми технологиями, опубликовала ряд технических результатов, включая Seed-TTS, Seed-ASR и другие.
Официальный сайт Seed-ASR:https://bytedancespeech.github.io/seedasr_tech_report/









