
 Помощник сценариста▸
 AI Приложения
 AI Новости
Hallo: иерархический аудиоуправляемый визуальный синтез для анимации портретных изображений
小编 ·

Hallo: иерархический аудиоуправляемый визуальный синтез для анимации портретных изображений
Hallo можетгенерировать поющие и говорящие видео на основе одного изображения и аудиовхода, а также управлять мимикой и позами персонажа. По сравнению с EMO, Hallo использует диффузионную модель для иерархического аудиоуправляемого визуального синтеза, что позволяет на основе входной речи генерировать анимацию с синхронизацией губ, изменениями выражения лица и движениями тела персонажа. Это повышает точность согласования между речью и сгенерированной анимацией, обеспечивая синхронизацию губ, выражений лица и поз с речью.
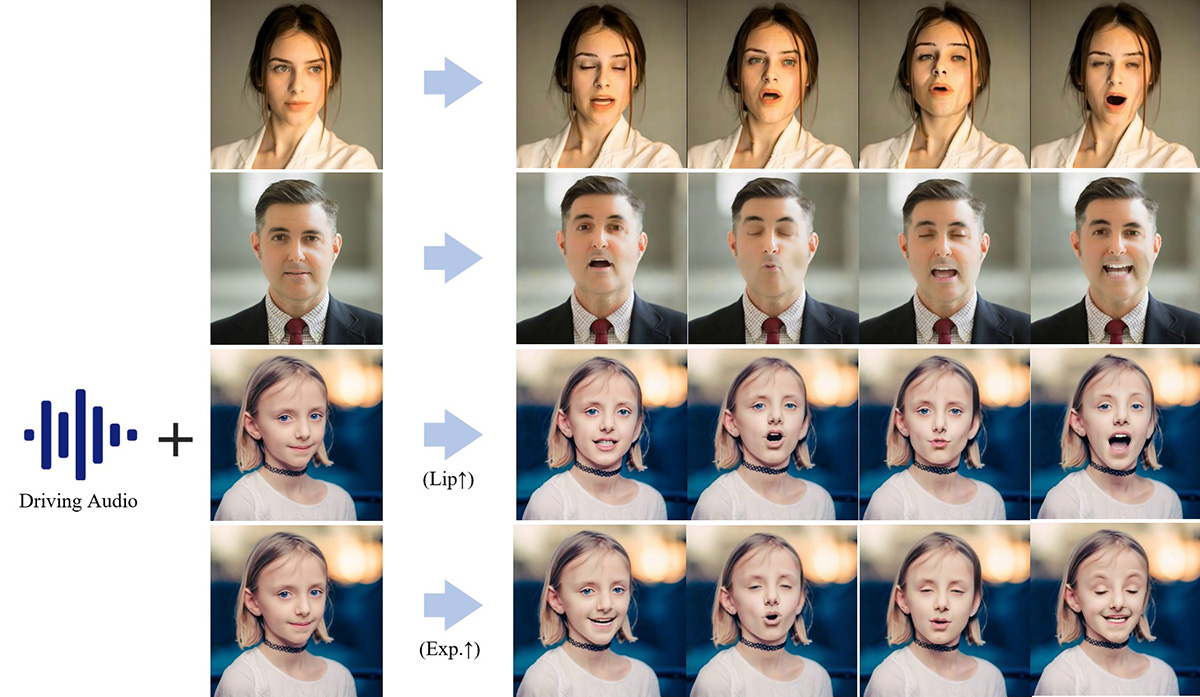
Функциональные особенности Hallo:
Генерация анимации виртуальных персонажей: создание реалистичной динамической анимации виртуальных персонажей на основе речевого аудиовхода с точной синхронизацией движений губ, мимики и поз.
Генерация анимации реальных персонажей: применение технологии к анимации реальных людей на основе речи, при этом сгенерированная анимация точно отражает изменения выражений лица и движений реального человека.
Разнообразное управление движением: обеспечение точного контроля над выражениями лица, позами и движениями губ персонажа, поддержка адаптивного управления множеством выражений и поз, расширяя разнообразие и реалистичность анимации.
Кросс-актёрское применение: поддержка генерации персонализированной анимации для различных идентичностей — на основе аудиовхода создаётся анимация, адаптированная под разные роли.
Генерация анимации пения: на основе речевого и песенного аудиовхода генерируется синхронная анимация пения, точно отражающая движения губ и выражение лица при пении.
Другие особенности Hallo:
Работа в реальном времени: использование архитектуры диффузионной модели повышает оперативность генерации анимации, делая её более реалистичной и естественной.
Персонализация: возможность настройки индивидуальных эффектов анимации для разных актёров или персонажей.
Разнообразие: обеспечение множества видов управления движением, включая выражения лица, позы и движения губ, что делает анимацию более разнообразной и реалистичной.
Адрес проекта Hallo: https://fudan-generative-vision.github.io/hallo
Hallo на Github: https://github.com/fudan-generative-vision/hallo
Документ Hallo: https://arxiv.org/abs/2406.08801
HuggingFace: https://huggingface.co/fudan-generative-ai/hallo









