
 Помощник сценариста▸
 AI Приложения
 AI Новости
Alibaba Cloud выпускает модель Qwen2 с открытым исходным кодом
小编 ·

Alibaba Cloud выпускает модель Qwen2 с открытым исходным кодом
Alibaba Cloud выпускает модель с открытым исходным кодом Qwen 2, производительность которой превосходит все существующие модели с открытым исходным кодом и закрытые модели в Китае.
Модели Qwen 2 доступны в различных размерах, включая 0.5B, 1.5B, 7B, 57B-A14B и 72B — всего 5 вариантов. В сравнительных тестах среди моделей аналогичного размера Qwen 2 показала результаты, превосходящие все остальные модели с открытым исходным кодом. Мы попробовали её на арене больших моделей CompassArena — действительно впечатляет, и, пожалуй, это одна из лучших моделей для китайского языка на данный момент.
Ключевые особенности Qwen 2:
5 размеров предобученных и дообученных на инструкциях моделей: Qwen2-0.5B, Qwen2-1.5B, Qwen2-7B, Qwen2-57B-A14B и Qwen2-72B;
Помимо английского и китайского, модели обучены на данных 27 языков;
Самые современные результаты в обширных бенчмарк-оценках;
Значительное улучшение показателей в программировании и математике;
Qwen2-7B-Instruct и Qwen2-72B-Instruct поддерживают расширенную длину контекста до 128K токенов.
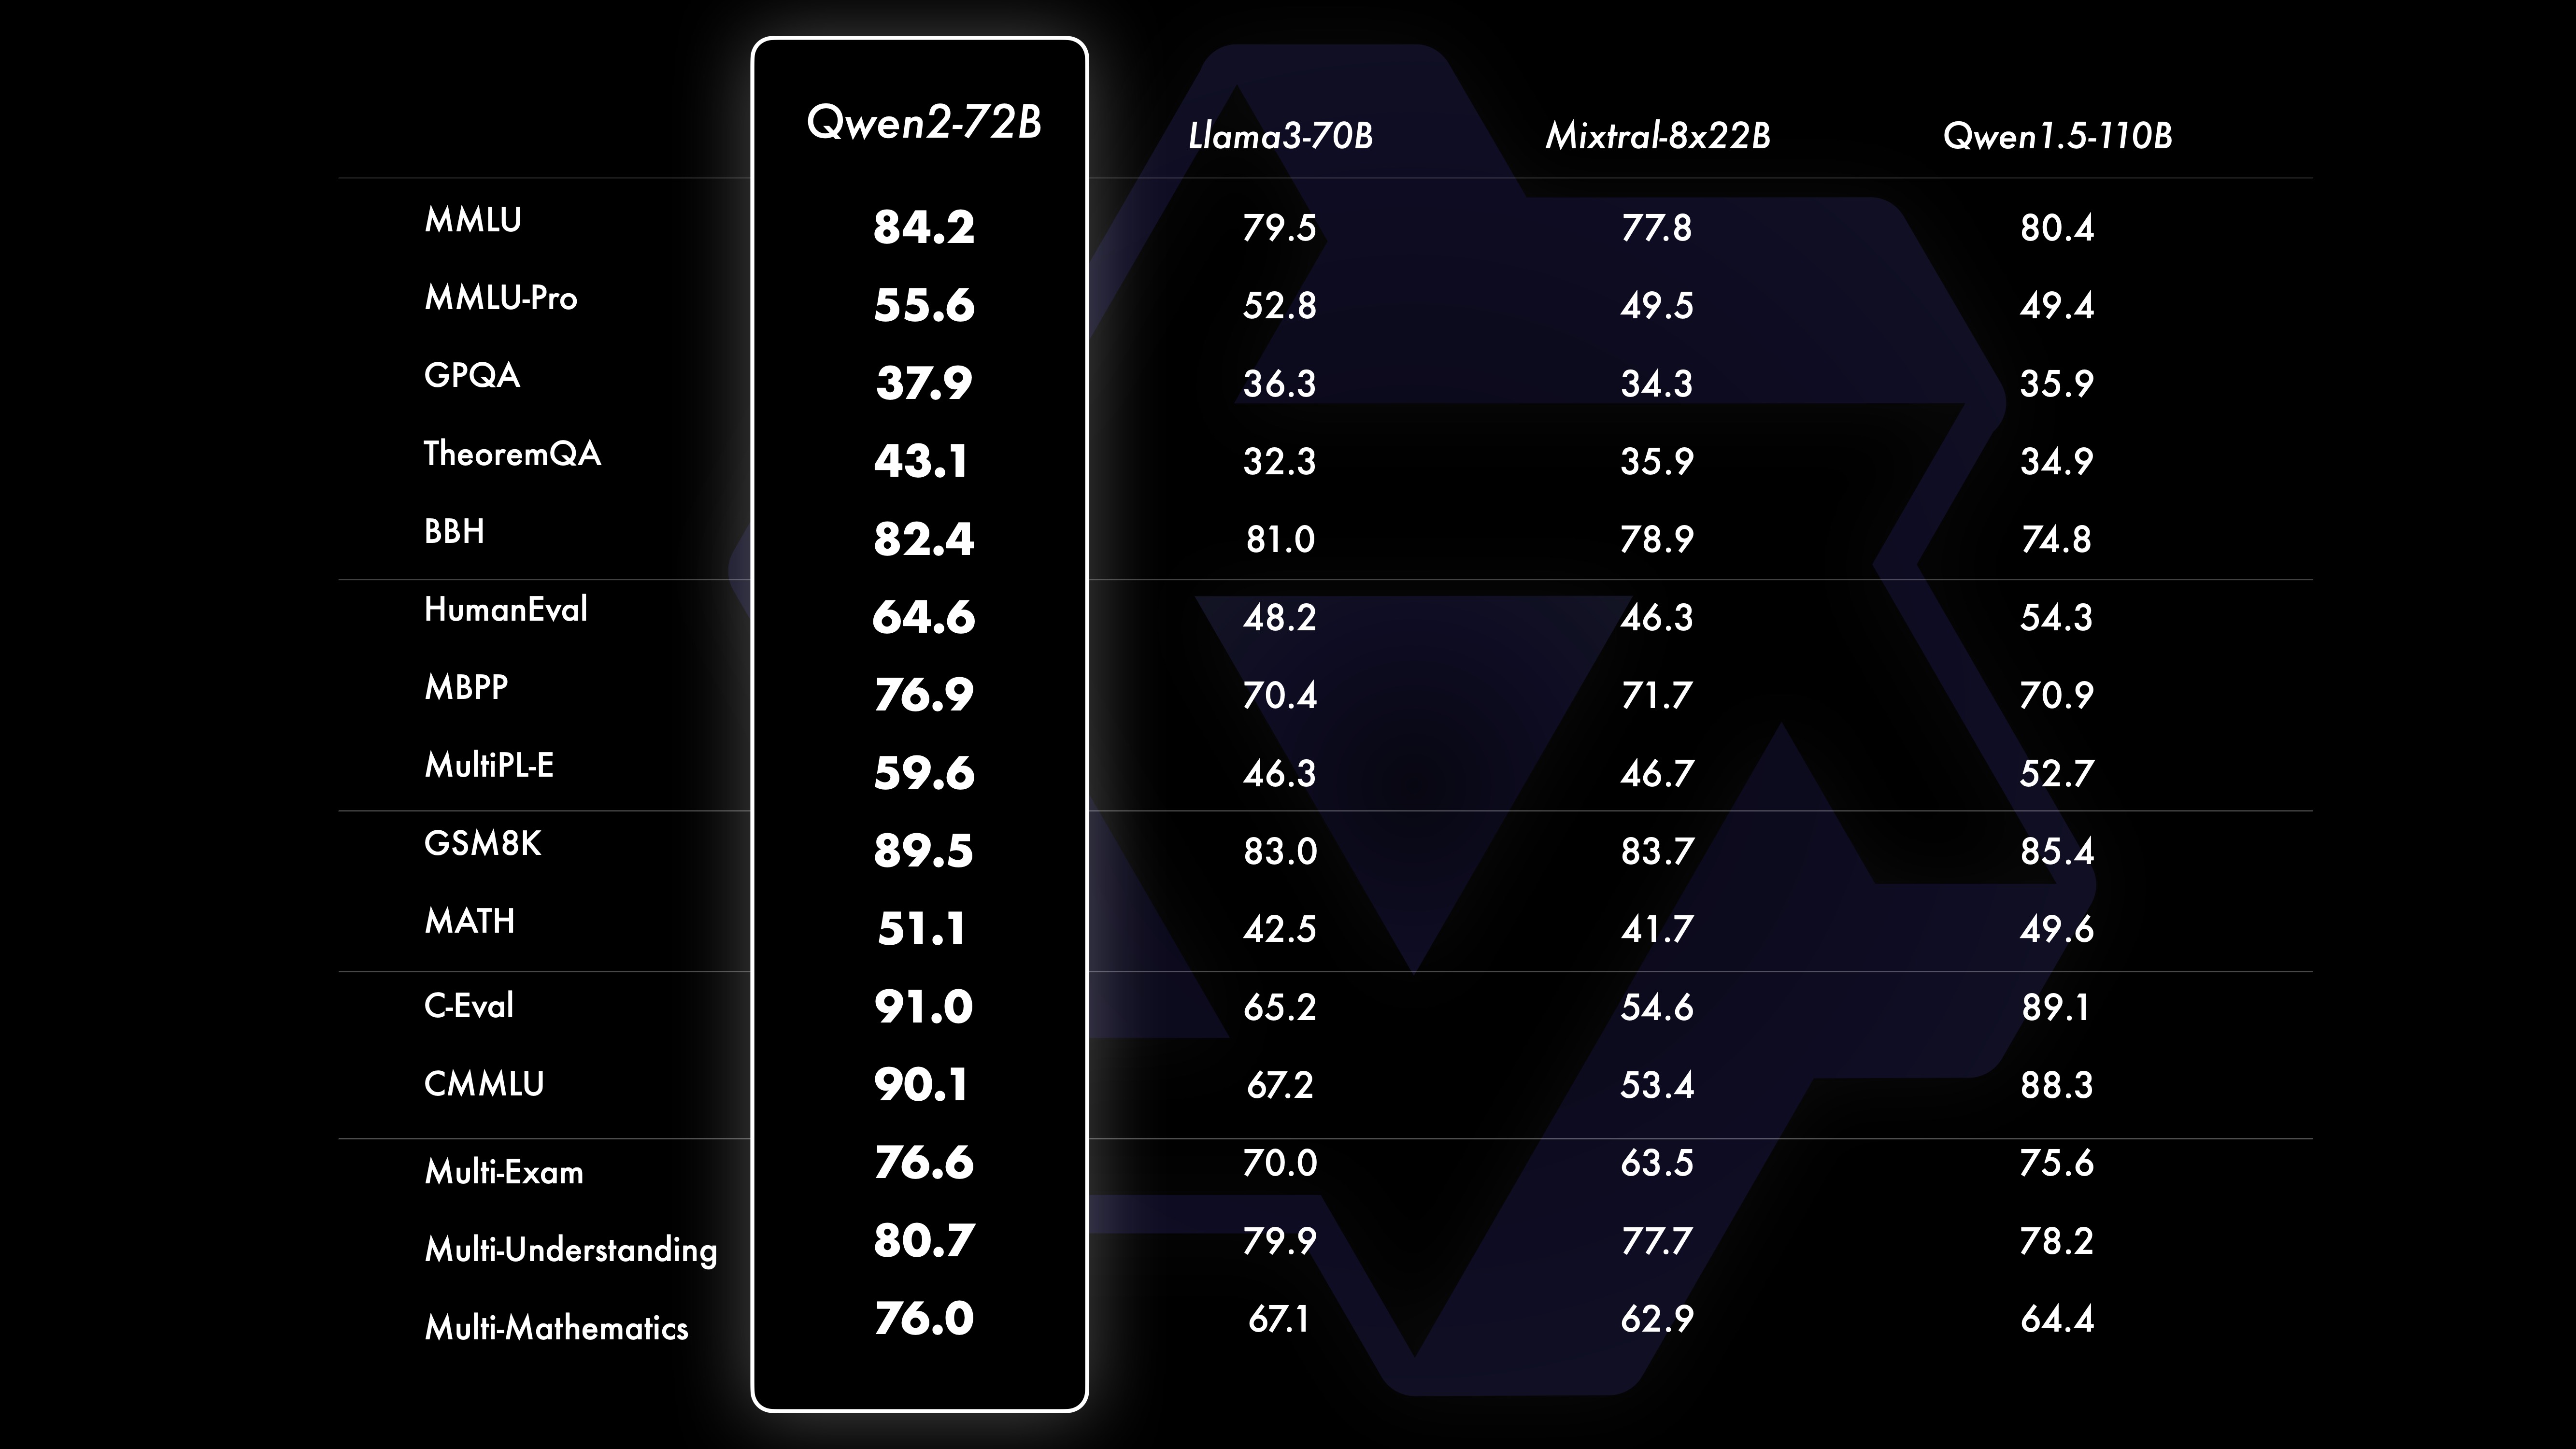
Сравнительные оценки показывают, что по сравнению с Qwen1.5 производительность больших моделей (70B+ параметров) значительно возросла. В данном обзоре основное внимание уделяется модели большого размера Qwen2-72B. Что касается базовых языковых моделей, Qwen2-72B и самые современные модели с открытым исходным кодом оценивались по различным возможностям, включая понимание естественного языка, получение знаний, способности к программированию, математические навыки и многоязычные способности. Благодаря тщательно подобранным наборам данных и оптимизированным методам обучения Qwen2-72B демонстрирует превосходную производительность по сравнению с такими ведущими моделями, как Llama-3-70B. Примечательно, что, несмотря на меньшее количество параметров, её производительность превосходит предшественницу Qwen1.5-110B.
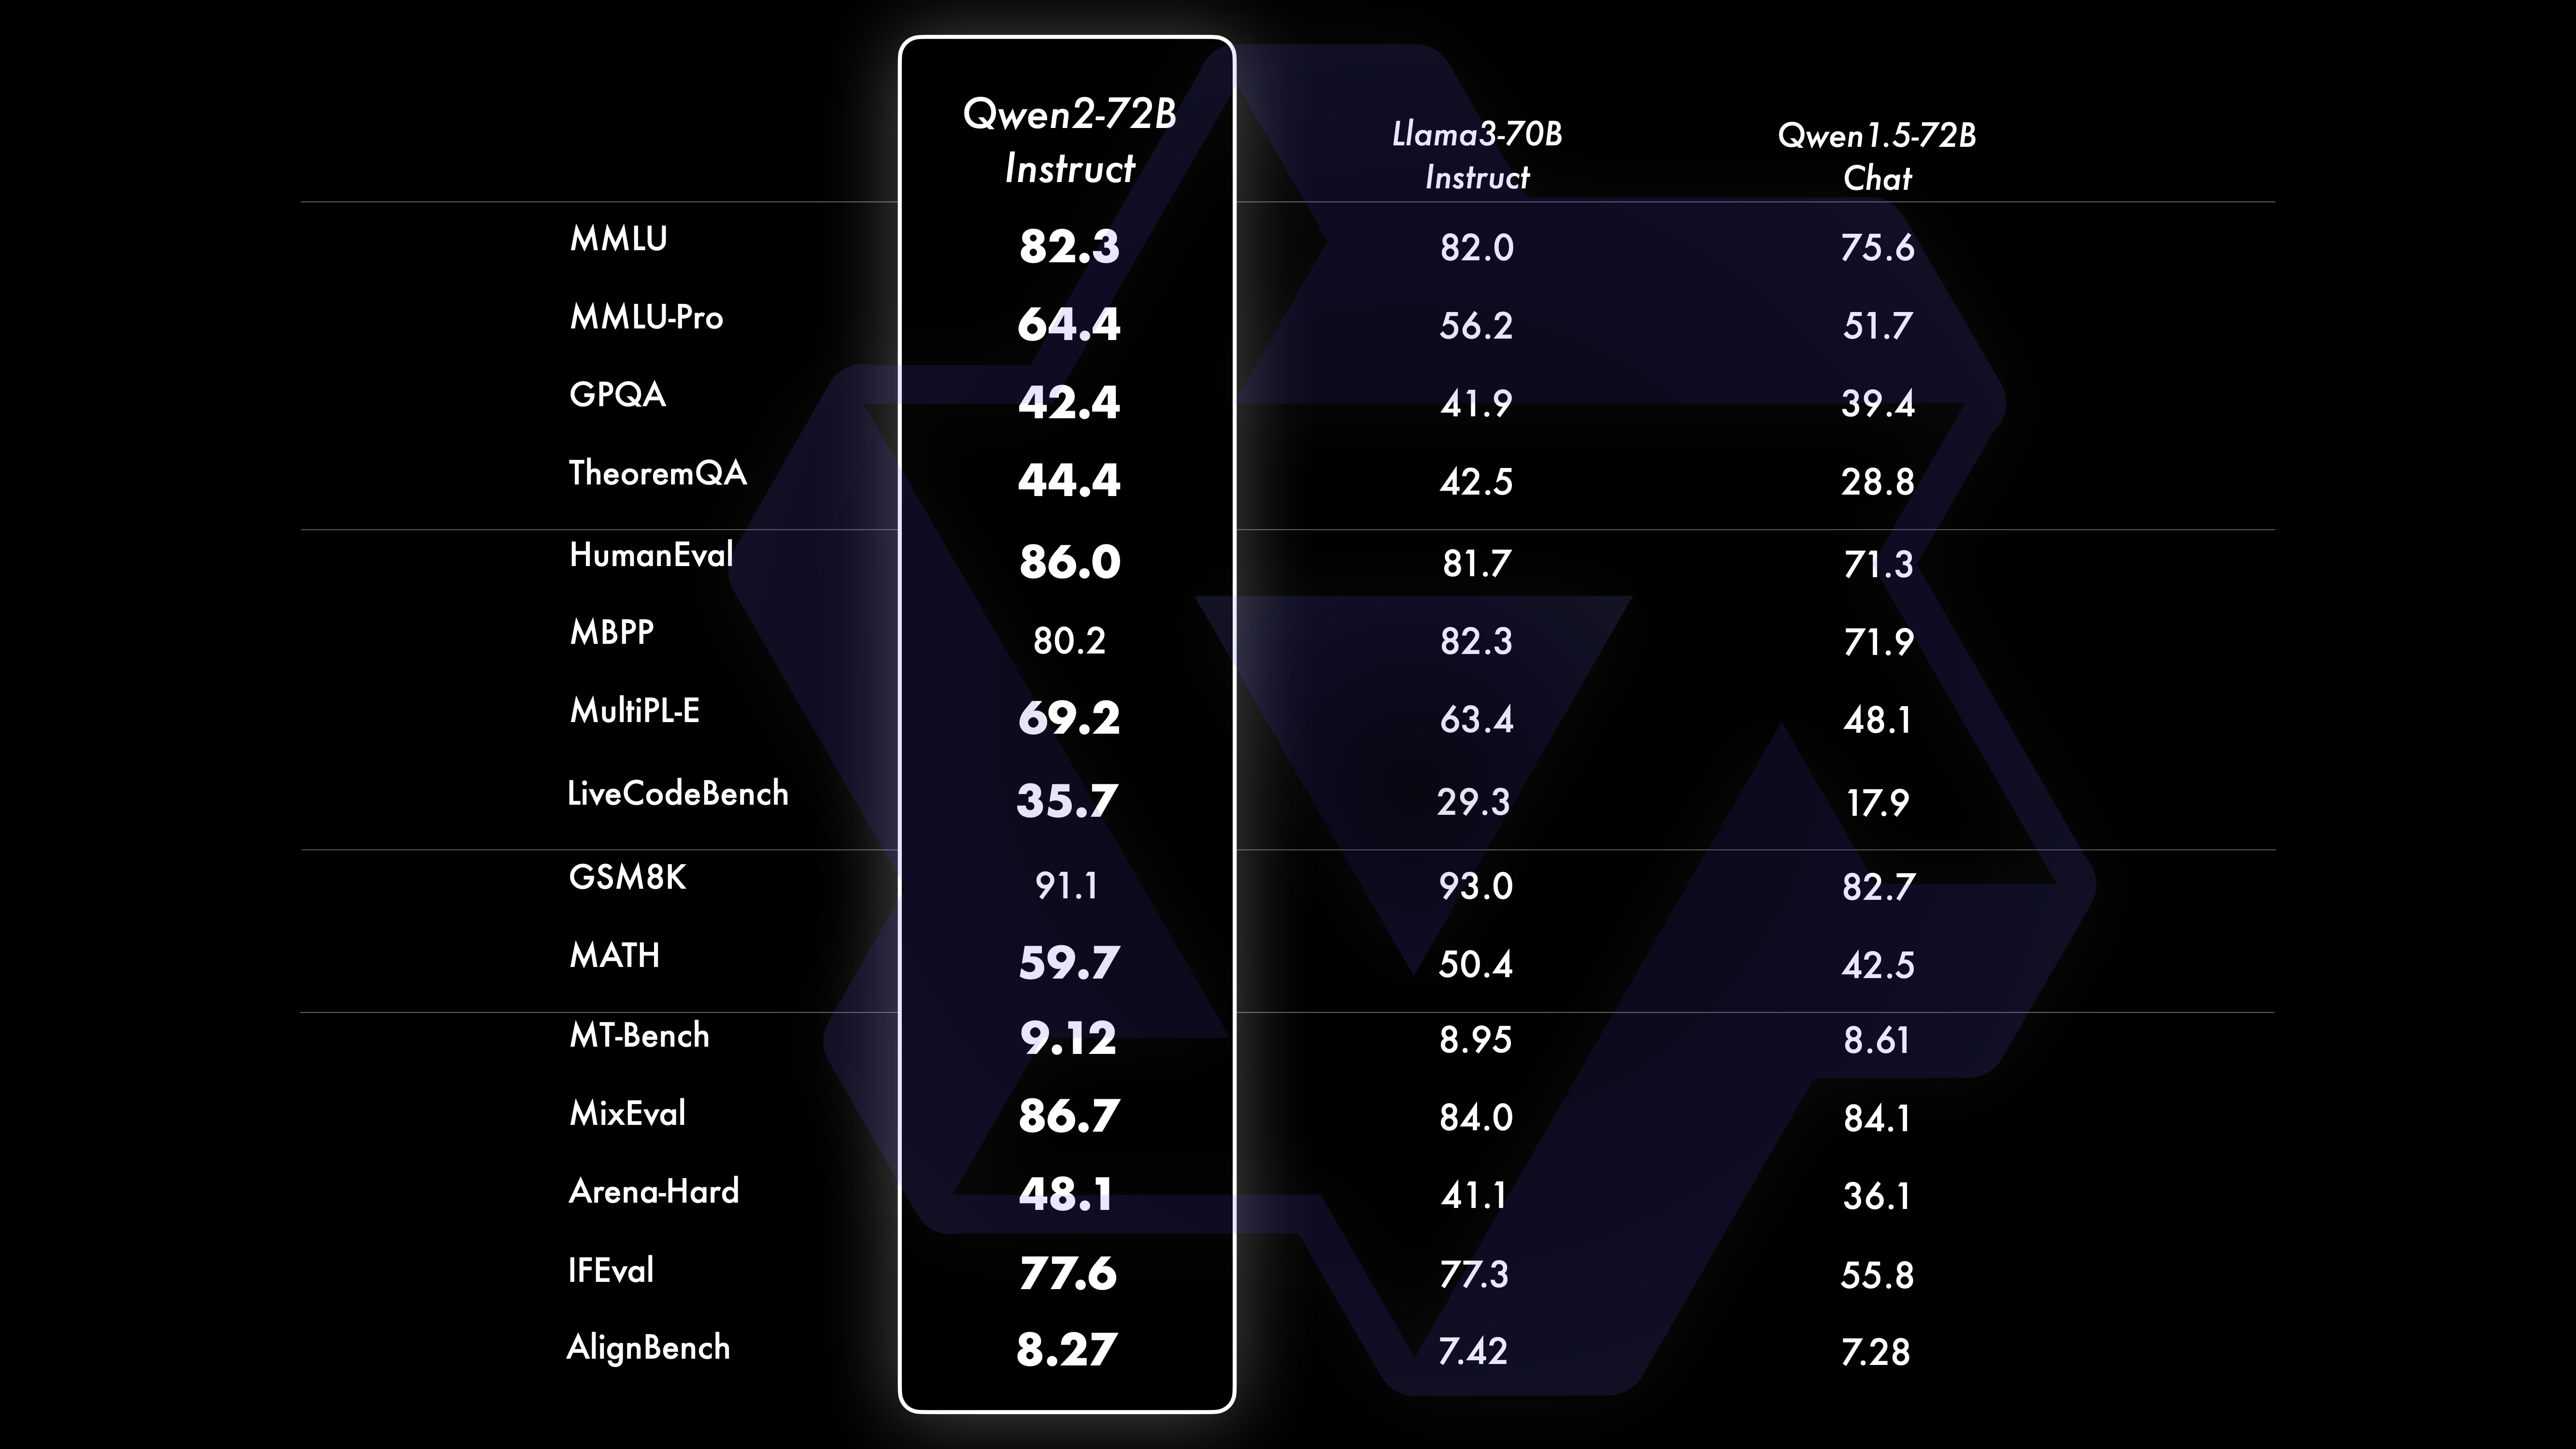
После обширного масштабного предобучения мы проводим пост-обучение, чтобы дополнительно повысить интеллект Qwen и приблизить его к человеческому. Этот процесс также улучшает возможности модели в таких областях, как программирование, математика, рассуждения, следование инструкциям и многоязычное понимание. Кроме того, выходные данные модели согласовываются с человеческими ценностями, что гарантирует её полезность, честность и безвредность. Наш этап пост-обучения разработан в соответствии с принципами масштабируемого обучения и требует минимальных ручных аннотаций. В частности, мы изучаем, как с помощью различных стратегий автоматического согласования получать высококачественные, надёжные, разнообразные и творческие демонстрационные данные и данные о предпочтениях — например, отбраковка выборок в математике, обратная связь по выполнению задач в программировании и следовании инструкциям, обратный перевод для творческого письма, а также масштабируемое наблюдение для ролевых сценариев и т. д. В части обучения мы используем комбинацию контролируемого дообучения, обучения модели вознаграждения и онлайн-обучения DPO. Мы также применяем новый оптимизатор онлайн-слияния, чтобы минимизировать «налог на согласование». Все эти усилия в совокупности значительно повысили возможности и интеллект наших моделей, как показано в таблице ниже.
Что дальше для Qwen2?
Мы обучаем ещё более крупные модели Qwen2, чтобы продолжить исследование масштабирования моделей, а также наше недавнее масштабирование данных. Кроме того, мы расширяем языковую модель Qwen2 до мультимодальной, способной понимать визуальную и аудиоинформацию. В ближайшем будущем мы продолжим открывать исходный код новых моделей, ускоряя развитие ai-сообщества с открытым исходным кодом. Следите за обновлениями!
Github: https://github.com/QwenLM/Qwen2
Ссылка для скачивания: https://modelscope.cn/organization/qwen
Попробовать: https://modelscope.cn/studios/opencompass/CompassArena/summary
Подробное описание: https://qwenlm.github.io/blog/qwen2/









