
 Помощник сценариста▸
 AI Приложения
 AI Новости
Seed-TTS: высококачественная модель text-to-speech от ByteDance
小编 ·

Seed-TTS: высококачественная модель text-to-speech от ByteDance
Недавно в области TTS произошёл настоящий прорыв. Сразу после того, как был открыт исходный код chatTTS, Byte выпустила seed-tts с превосходными результатами.
Seed-TTS — это высококачественная модель преобразования текста в речь (TTS), разработанная ByteDance. Модель Seed-TTS способна генерировать речь, практически неотличимую от человеческой.
Являясь фундаментальной моделью генерации речи,Seed-TTS демонстрирует выдающиеся результаты в контекстном обучении речи, а по показателям сходства с диктором и естественности речи как в объективных, так и в субъективных оценках соответствует реальной человеческой речи.
Seed-TTS без какого-либо дополнительного обучения, используя лишь короткий голосовой фрагмент, способна клонировать и генерировать высоко естественную и выразительную речь, подходящую для таких задач, как чтение романов и озвучивание.
Seed-TTS также предоставляет расширенные возможности управления различными атрибутами речи, включая, помимо прочего, эмоции, интонацию, стиль речи и т. д., а также позволяет редактировать сгенерированную речь путём редактирования текста.
Seed-TTS может изменять содержание аудио, сохраняя при этом тембр, высоту тона и эмоциональную окраску неизменными.
Seed-TTS поддерживает регулировку скорости речи, позволяя свободно контролировать темп аудио.
Seed-TTS обеспечивает превосходную управляемость различными атрибутами речи (например, эмоциями) и способна генерировать высоко выразительную и разнообразную речь для дикторов из реальных условий.
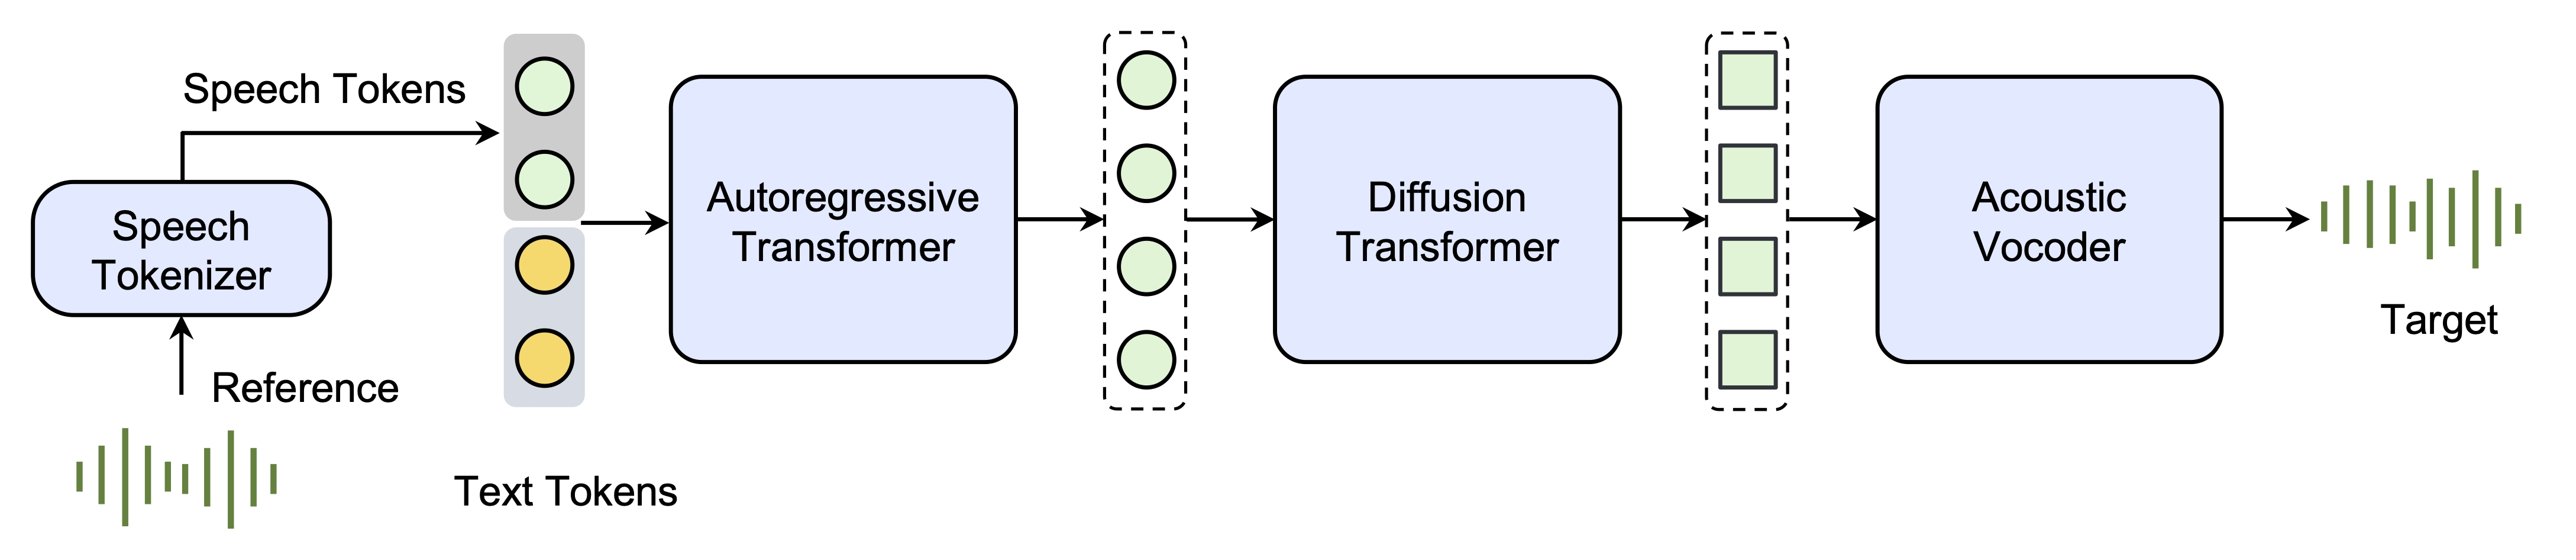
Кроме того, мы предлагаем метод самодистилляции для декомпозиции речи, а также метод обучения с подкреплением для повышения робастности модели, сходства с диктором и управляемости. Мы также представляем неавторегрессионный (NAR) вариант модели Seed-TTS под названием Seed-TTS DiT, который использует полностью диффузионную архитектуру. В отличие от предыдущих NAR-систем TTS, Seed-TTS DiT не зависит от предварительно оценённых длительностей фонем и выполняет генерацию речи сквозным образом. Мы показываем, что этот вариант достигает производительности, сопоставимой с вариантом на основе языковой модели, как в объективных, так и в субъективных оценках, и демонстрируем его эффективность при редактировании речи.
Статья: https://arxiv.org/abs/2406.02430









