
 Помощник сценариста▸
 AI Приложения
 AI Новости
ViViD: виртуальная примерка видео с помощью диффузионных моделей
小编 ·

ViViD: виртуальная примерка видео с помощью диффузионных моделей
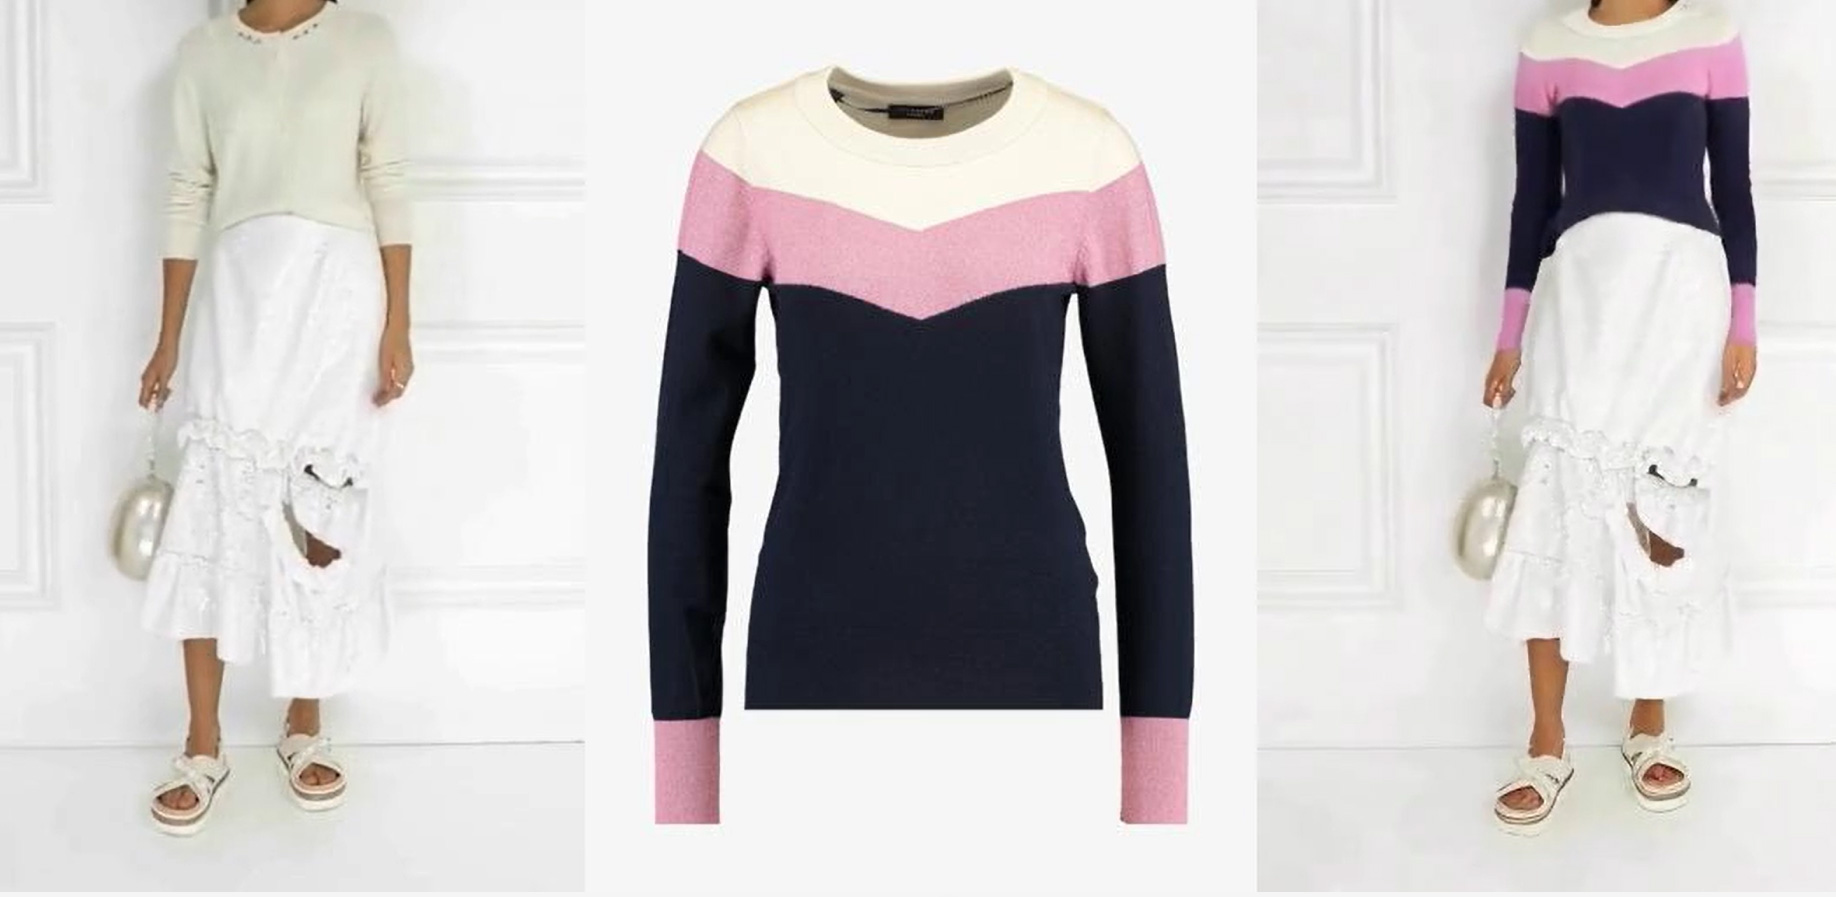
ViViD — это технология виртуальной примерки одежды на видео, разработанная Alibaba, которая позволяет произвольно заменять одежду на человеке в видео. ViViD способна генерировать естественные и реалистичные видео виртуальной примерки, перенося одежду на человека в видео, при этом сохраняя остальную часть видео неизменной.
Демонстрационный сайт ViViD: https://becauseimbatman0.github.io/ViViD
Адрес статьи ViViD: https://arxiv.org/abs/2405.11794
С быстрым развитием электронной коммерции потребители могут легко получить доступ к различным типам одежды через такие онлайн-платформы, как Taobao и JD.com. Однако, полагаясь только на изображения одежды на сайтах электронной коммерции, потребителям сложно представить, как одежда будет выглядеть на них. Хотя технология замены одежды на изображениях уже достаточно зрелая, технология замены одежды на видео, особенно в части взаимодействия с движениями тела, встречается всё ещё довольно редко.
Виртуальная примерка на видео предполагает перенос одежды на целевого человека. Прямое применение технологий примерки на основе изображений к видео покадрово приводит к временной несогласованности результатов, а предыдущие решения для примерки на основе видео могли давать только результаты низкого визуального качества и размытые.
Целью технологии виртуальной примерки одежды на видео ViViD, совместно разработанной исследовательскими группами Университета науки и технологий Китая и группы Alibaba, является решение этой проблемы путём синтеза видео, позволяющего потребителям увидеть, как одежда действительно будет выглядеть на них. Этот видеофреймворк использует модели диффузии (Diffusion Models) для достижения высококачественной и согласованной примерки на видео.
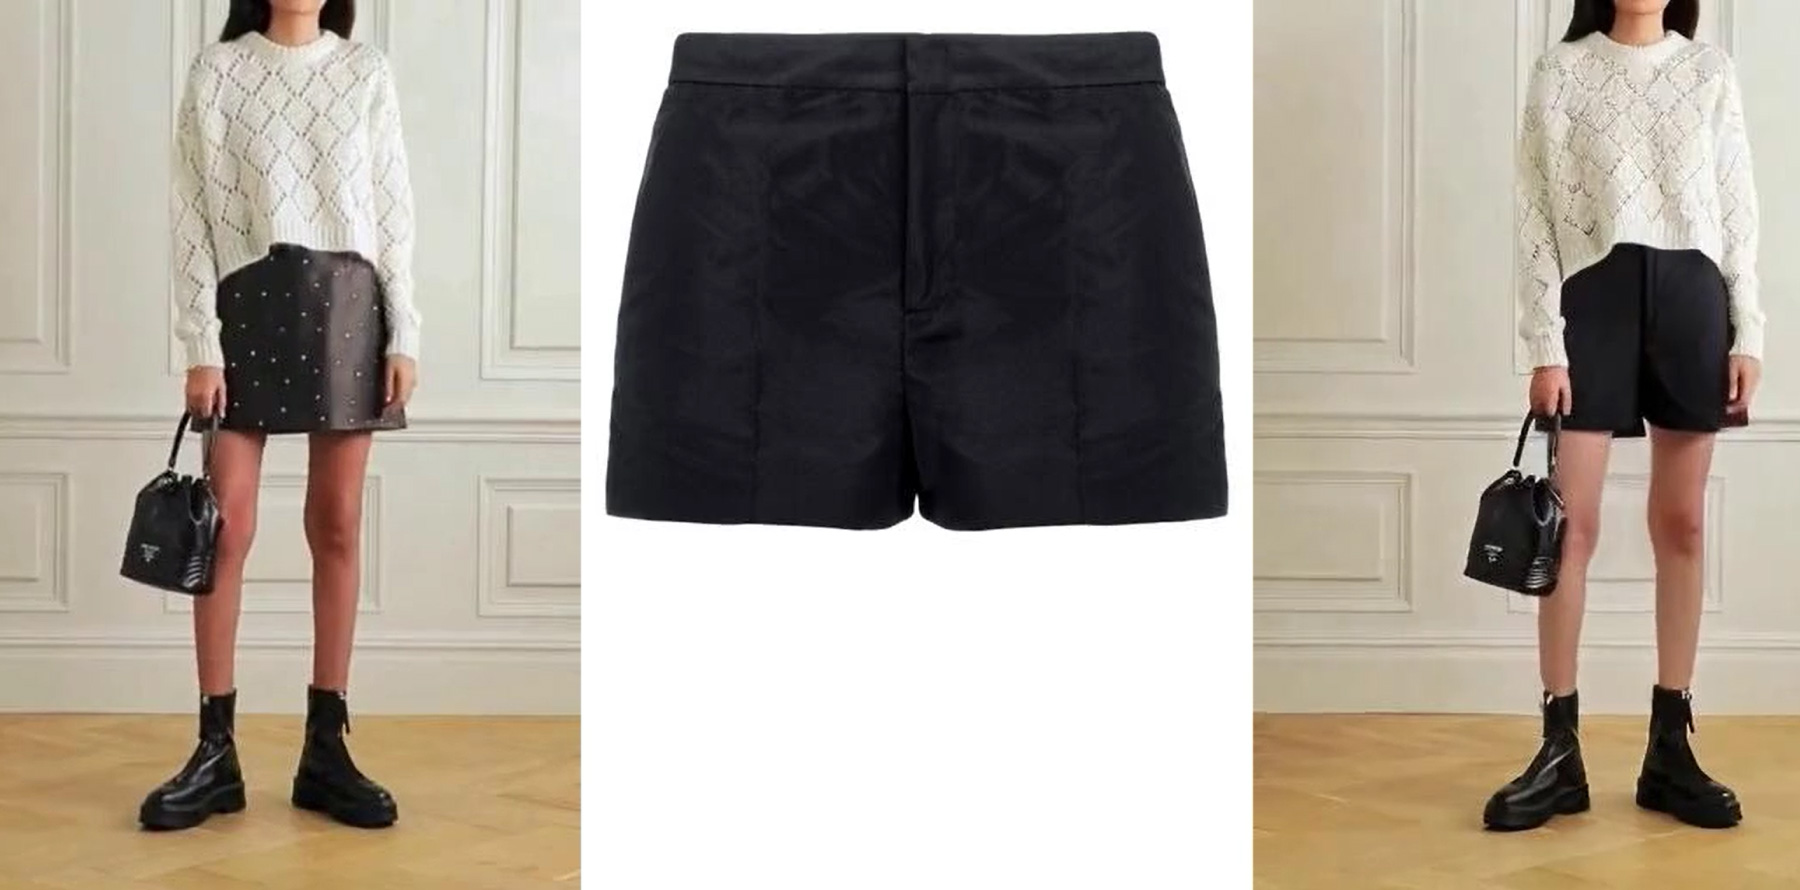
В частности, мы разработали кодировщик одежды для извлечения детализированных семантических признаков одежды, который направляет модель на захват деталей одежды и внедряет их в целевое видео с помощью предложенного механизма слияния признаков внимания. Для обеспечения временно́й и пространственной согласованности мы ввели лёгкий кодировщик поз для кодирования сигналов позы, позволяющий модели изучать взаимодействие между одеждой и позой человека, а также встроили иерархические временны́е модули в модель стабильной диффузии текст-в-изображение для получения более связного и реалистичного синтеза видео.
Кроме того, мы собрали новый набор данных, который на сегодняшний день является самым крупным, с самым разнообразным типам одежды и самым высоким разрешением для задачи виртуальной примерки на видео. Обширные эксперименты показывают, что наш метод способен давать удовлетворительные результаты видеопримерки. Набор данных, код и веса будут опубликованы.









