
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Story-Iter: UCSC-VLAA의 긴 스토리 시각화 솔루션
Story-Iter: UCSC-VLAA의 긴 스토리 시각화 솔루션소개
Story-Iter란 무엇인가요?
Story-Iter는 UCSC-VLAA에서 제안한 장편 스토리 시각화 솔루션입니다. 이 작업은 내러티브 텍스트를 기반으로 일관된 이미지 시퀀스를 생성하는 것으로, 최대 100프레임에 이르는 장편 스토리 장면을 지원합니다.
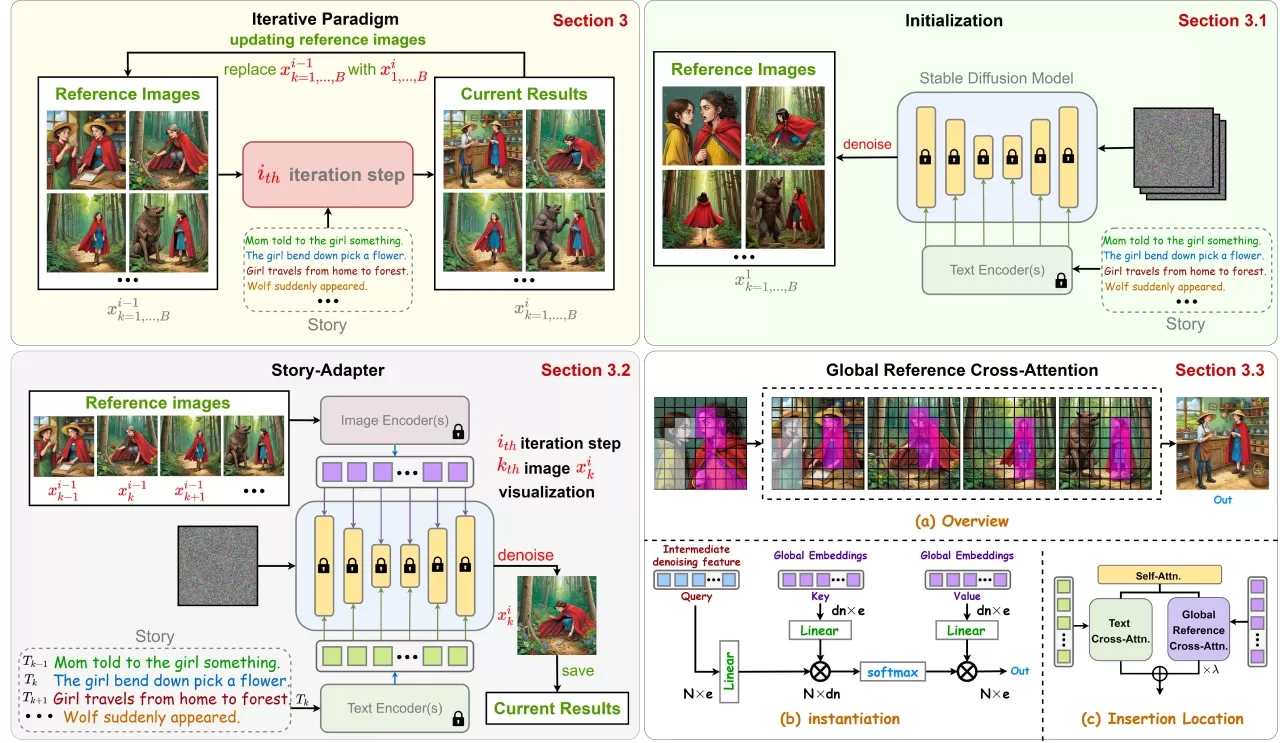
자기회귀 방식과 달리, Story-Iter는 외부 반복 메커니즘을 채택합니다. 즉, 확산 모델 내부의 노이즈 제거 단계 외에 추가적인 반복 루프를 도입하여, 이전 라운드에서 생성된 모든 참조 이미지를 지속적으로 통합함으로써 각 프레임의 품질을 최적화합니다.
🔧 Story-Iter 기능 특징
1. 글로벌 참조 크로스 어텐션 모듈
플러그 앤 플레이: 추가 학습 없이 기존 확산 모델(예: Stable Diffusion)에 바로 통합 가능
글로벌 임베딩: 모든 참조 프레임을 글로벌 임베딩으로 모델링하여 긴 시퀀스의 의미적 일관성 보장
크로스 어텐션 메커니즘: 이미지 생성 과정에서 모든 참조 이미지의 정보 흐름을 집계
2. 반복 최적화 패러다임
초기화 단계: 스토리 텍스트 프롬프트를 기반으로 각 프레임 이미지의 초기 버전 생성
반복 정제: 이전 라운드에서 생성된 모든 이미지를 다음 라운드의 참조로 사용하여 점진적으로 최적화
점진적 개선: 전체 시각적 맥락과 텍스트 제약을 반복적으로 통합하여 정밀한 세밀한 상호작용 생성 실현
3. 긴 시퀀스 지원
최대 100프레임의 장편 스토리 이미지 시퀀스 생성 지원
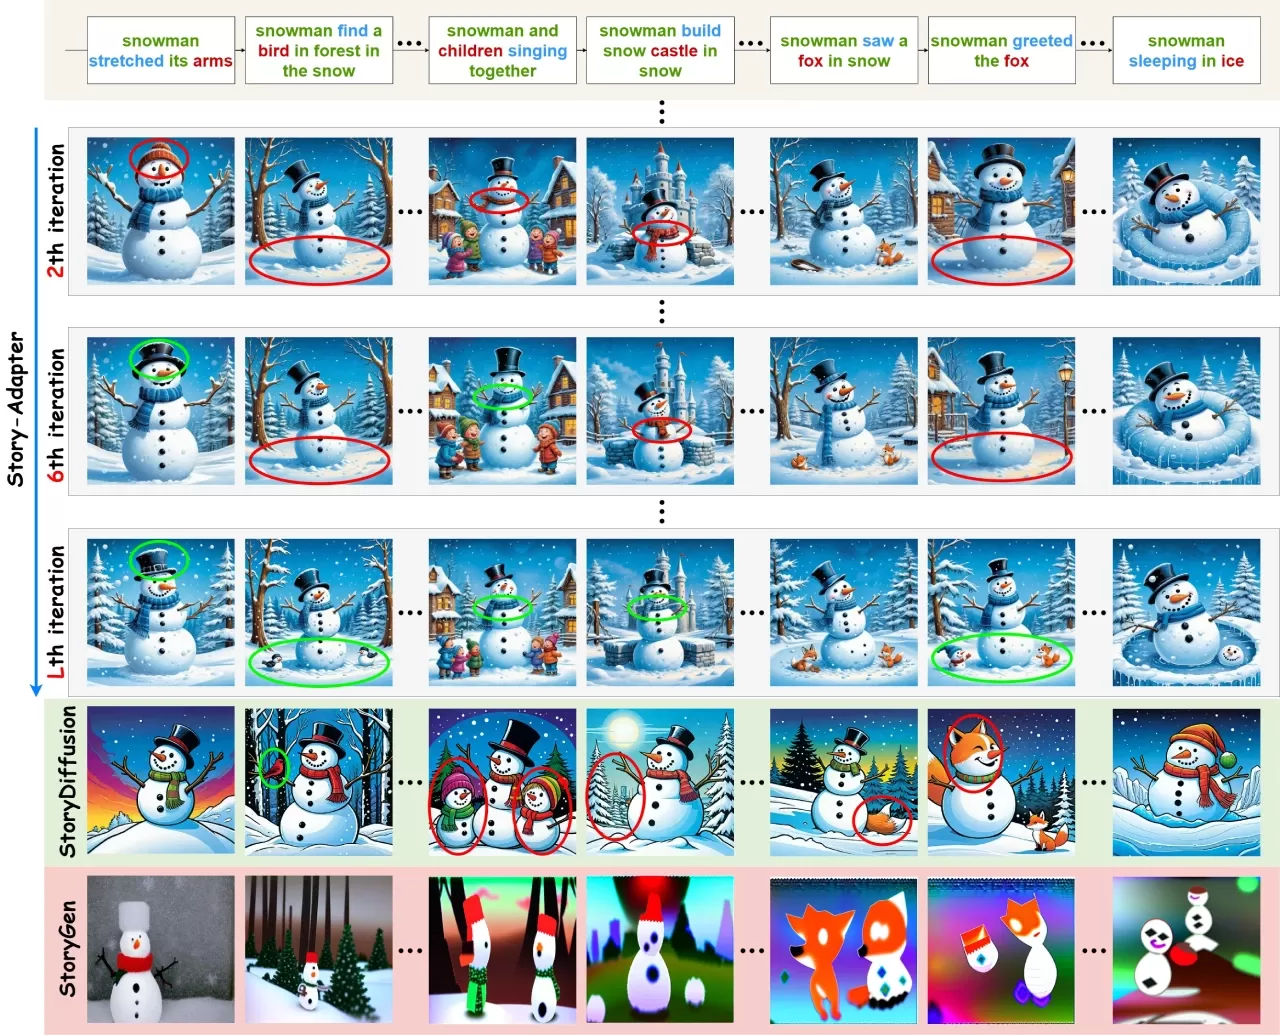
의미적 일관성과 세밀한 상호작용 측면에서 우수한 성능
🎯 Story-Iter 활용 시나리오
만화/그림책 생성: 장편 스토리 텍스트로부터 일관된 만화 페이지를 자동 생성
애니메이션 프리비주얼라이제이션: 애니메이션 제작을 위한 스토리보드 수준의 시각적 프리뷰 제공
영화 스토리보드: 감독과 촬영감독이 빠르게 콘티 스케치를 생성하도록 지원
어린이 동화책: 교육용 콘텐츠를 위해 풍부한 일러스트가 포함된 내러티브 도서 제작
광고 크리에이티브: 장편 시퀀스의 제품 홍보용 비주얼 스토리 생성
게임 시네마틱: 게임 스토리에 연속적인 비주얼 내러티브 생성
✅ Story-Iter 장단점
장점
학습 불필요: 추가적인 모델 학습이나 미세 조정이 필요 없는 플러그 앤 플레이 방식
높은 연산 효율성: 대규모 멀티모달 인코더를 도입하는 방식 대비 연산 비용이 낮음
일관성 보장: 글로벌 참조 메커니즘을 통해 긴 시퀀스에서 캐릭터, 장면, 스타일의 일관성을 효과적으로 유지
세밀한 상호작용: 복잡한 인물 간 상호작용을 포함하는 고품질 장면 생성 가능
확장성: 기존 방식을 훨씬 능가하는 최대 100프레임의 스토리 생성 지원
단점
반복 오버헤드: 학습이 불필요하지만, 반복 과정에서 다수의 추론이 필요하여 시간 비용이 높음
기반 모델 의존성: 성능이 기반 확산 모델(예: SD)의 능력에 제한됨
장편 스토리의 어려움: 100프레임까지 지원하지만, 매우 긴 스토리에서는 여전히 일관성 드리프트가 발생할 수 있음
공식 코드 미공개: 현재 GitHub 저장소가 완전히 공개되지 않았거나 초기 단계에 있을 수 있음
🛠️ Story-Iter 사용 방법
환경 준비
# 저장소 클론 (이미 공개되었다고 가정)
git clone https://github.com/UCSC-VLAA/story-iter.git
cd story-iter
# 의존성 설치
pip install -r requirements.txt
기본 사용 절차
스토리 텍스트 준비: 스토리를 연속적인 텍스트 설명으로 분할 (각 프레임마다 하나의 설명 대응)
초기 생성: 첫 번째 라운드 생성을 실행하여 텍스트 프롬프트만을 기반으로 초기 이미지 시퀀스 생성
반복 최적화:
생성된 이미지를 다음 라운드 생성의 참조로 활용
GRCA 모듈을 활성화하여 글로벌 참조 정보를 집계
수렴하거나 사전 설정된 반복 횟수에 도달할 때까지 반복
결과물 출력: 최종 최적화된 일관된 스토리 이미지 시퀀스 획득
주요 파라미터
--num_iterations: 반복 횟수 (일반적으로 3-5회 반복 시 현저한 개선 효과)
--use_grca: 글로벌 참조 크로스 어텐션 모듈 활성화
--num_frames: 스토리 프레임 수 (최대 100프레임 지원)
❓ Story-Iter 자주 묻는 질문
Q1: Story-Iter와 Story-Adapter의 관계는 무엇인가요?
arXiv 정보에 따르면, Story-Iter와 Story-Adapter는 동일 프로젝트의 서로 다른 명칭입니다. 논문 인용은 Story-Adapter: A Training-free Iterative Framework for Long Story Visualization로 표기되어 있으나, 프로젝트 페이지와 ICLR 2026 제출물에서는 Story-Iter라는 명칭이 사용됩니다.
Q2: 자체 모델을 학습해야 하나요?
그렇지 않습니다. Story-Iter는 학습 불필요(training-free) 프레임워크로, 사전 학습된 Stable Diffusion 모델에 바로 적용할 수 있습니다.
Q3: 어떤 기반 모델을 지원하나요?
주로 Stable Diffusion 시리즈 모델(예: SD 1.5, SDXL)을 기반으로 하며, GRCA 모듈 삽입을 통해 기능을 확장합니다.
Q4: 100프레임 스토리 생성에 소요되는 시간은?
구체적인 시간은 하드웨어 구성과 반복 횟수에 따라 달라집니다. 반복 최적화 메커니즘을 채택하므로, 총 소요 시간 = 단일 프레임 생성 시간 × 프레임 수 × 반복 횟수입니다. A100 GPU 사용 시 속도를 크게 높일 수 있습니다.
Q5: 캐릭터 일관성은 어떻게 보장하나요?
GRCA 모듈의 글로벌 참조 메커니즘을 통해, 각 반복에서 이미 생성된 모든 프레임의 정보를 집계하여 캐릭터 외형, 의상 및 장면 요소가 전체 스토리에서 일관되게 유지되도록 합니다.
📚 관련 리소스
프로젝트 홈페이지: https://jwmao1.github.io/storyiter/
논문 주소: https://arxiv.org/abs/2410.06244
GitHub 저장소: https://github.com/UCSC-VLAA/story-iter
소속 기관: UCSC-VLAA(캘리포니아 대학교 산타크루즈分校 시각 언어 및 인공지능 연구소)














