
 대본 기획 도우미▸
 AI 앱
 AI 뉴스

StableAvatar: 오디오로 노래 또는 말하는 영상을 직접 생성하는 도구
StableAvatar: 오디오로 노래 또는 말하는 영상을 직접 생성하는 도구소개
StableAvatar란 무엇인가?
StableAvatar는复旦大学, 微软亚洲研究院, 西安交通大学 등 기관의 연구원들이 개발한 도구로, 오디오만으로 노래나 말을 하는 비디오를 직접 생성할 수 있으며, 비디오 길이에 제한이 없고 화질도 매우 높습니다.
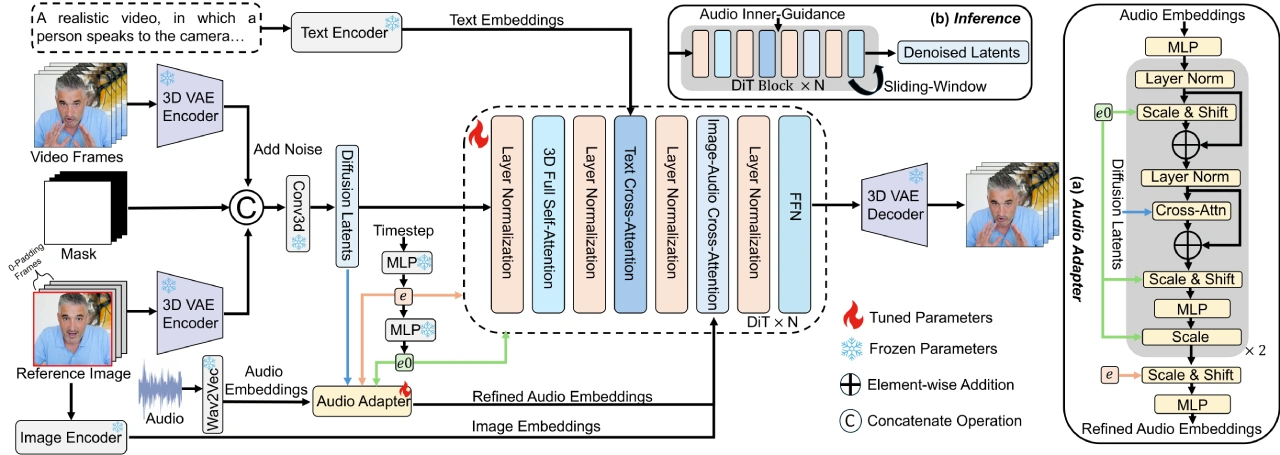
StableAvatar 핵심 기술
时间步感知音频适配器(타임 스텝 인지 오디오 어댑터): 이 기술은 주로 변환 과정에서 오디오 정보가 잘못되는 것을 방지합니다. 초기의 오디오 정보와 이미지의 초기 정보를 "크로스 어텐션" 방식으로 처리하여(쉽게 말하면 둘이 더 잘 연관되도록 하는 것) 서로 연결되게 한 다음, "타임 스텝 임베딩"으로 조정합니다(시간대별로 정보에 미세 조정을 하는 것과 비슷). 마지막으로 더 정확한 오디오 정보를 얻어, 이후 비디오를 생성할 때 화면과 오디오가 맞지 않거나 화면이 왜곡되는 현상을 방지합니다.
音频原生引导机制(오디오 네이티브 가이드 메커니즘): 비디오 생성의 마지막 단계(즉, 추론 단계)에서 모델이 자체적으로 예측한 오디오와 화면 정보를 활용합니다. 이러한 동적으로 변화하는 정보를 "가이드 신호"로 사용하여 생성된 비디오와 오디오의 동기화를 강화하고, 소리와 입모양이 맞지 않는 상황이 발생하지 않도록 합니다.
StableAvatar 작동 원리
오디오 처리: 먼저 입력된 오디오를 Wav2Vec 모델을 통해 오디오 특징(audio embeddings)을 추출한 다음, 앞에서 언급한 "오디오 어댑터"를 사용하여 이러한 특징을 최적화하여 오디오 정보를 더 정확하게 만듭니다.
참조 이미지(예: 인물의 초기 사진) 처리: 참조 이미지는 두 가지 경로를 통해 비디오 생성 모델로 입력됩니다.
첫 번째 경로: 참조 이미지와 제로 패딩 프레임(빈 프레임에 해당)을 시간축을 따라 연결한 다음, 고정된 3D VAE 인코더를 통해 잠재 변수 인코딩(화면의 숨겨진 정보와 유사)으로 변환합니다. 이 잠재 변수 인코딩은 압축된 비디오 프레임 및 이진 마스크(어떤 부분을 중점적으로 처리해야 하는지 표시)와 채널 축에서 연결되어 이후 화면 생성의 기반을 제공합니다.
두 번째 경로: CLIP 인코더(이미지의 핵심 특징을 추출할 수 있는 모델)를 통해 참조 이미지를 이미지 임베딩(image embeddings)으로 변환한 다음, 이러한 특징을 디노이징 모듈(DiT)의 각 "이미지-오디오 크로스 어텐션 모듈"에 입력하여, 생성된 비디오에서 인물의 외모가 참조 이미지와 일치하도록 하는 것이 목적입니다.
비디오 생성: 추론 단계에서 원래 입력되어야 할 실제 비디오 프레임은 무작위 노이즈로 대체되며(이 종류 모델의 일반적인 작동 방식), 다른 입력(예: 최적화된 오디오, 처리된 참조 이미지 정보)은 변경되지 않습니다. 최종적으로 모델 계산을 통해 연속된 비디오 프레임이 생성되어 완전한 비디오가 형성됩니다.
StableAvatar 장점
초장시간 비디오 생성 가능: 이전의 도구들은 대부분 15초 미만의 짧은 비디오만 생성할 수 있었던 반면, StableAvatar는 임의의 길이의 비디오를 생성할 수 있으며, 화질도 여전히 매우 높습니다(고품질).
인물 이미지 변형 없음: 매우 긴 비디오를 생성하더라도 비디오 속 인물의 얼굴과 몸동작이 일관되게 유지되어, 얼굴이 변형되거나 신체 비율이 이상해지거나 전후 외모가 맞지 않는 문제가 발생하지 않습니다.
추가 처리 불필요: 생성된 비디오는 바로 사용할 수 있으며, 더 이상 얼굴을 보정하기 위해 다른 도구(예: 흔히 사용되는 얼굴 교체 도구 FaceFusion 또는 복원 모델 GFP-GAN, CodeFormer 등)를 사용할 필요가 없어 많은 번거로움을 줄여줍니다.
StableAvatar 활용 시나리오
1. 영화 및 비디오 제작
고난이도 액션 장면: 배우가 직접 위험한 동작(예: 건물에서 뛰어내리기, 폭발 장면)을 찍을 필요가 없으며, 이를 사용하여 비디오를 생성하면 비용과 위험을 줄일 수 있습니다.
캐릭터 애니메이션: 영화나 비디오 속 인물에 사실적인 동작과 표정을 더하여 캐릭터를 더 생동감 있게 만듭니다.
오래된 필름 복원: 오래된 영화 필름 속 인물을 더 선명하게 복원하여, 클래식 캐릭터를 다시 살아 있게 합니다.
2. 게임 개발
캐릭터 애니메이션: 게임 속 캐릭터의 동작과 표정이 더 사실적이어서 플레이어가 게임에 더 몰입할 수 있습니다.
시네마틱 컷신: 게임 스토리 전환 영상이 더精彩하여 플레이어가 계속 플레이하도록 유도합니다.
가상 캐릭터 인터랙션: 게임 속 NPC(비플레이어 캐릭터)의 동작과 표정이 더 자연스러워 게임 세계가 더 현실적으로 느껴집니다.
3. 가상 현실(VR) 및 증강 현실(AR)
가상 캐릭터 생성: VR/AR 애플리케이션에서 사실적인 인물을 생성하여 사용자가 실제 사람과 상호작용하는 듯한 느낌을 받게 합니다.
VR 소셜: 사용자는 생성된 가상 인물과 대화하고 상호작용하여 소셜의 재미를 더할 수 있습니다.
VR 여행: 사용자가 VR 장비를 통해 전 세계 곳곳의 풍경을 "몸소" 체험하여 정말 여행을 다녀온 것처럼 느낄 수 있습니다.
4. 소셜 미디어 및 라이브 스트리밍
가상 스트리머: 생성된 가상 스트리머 이미지가 항상 일관되게 유지되며, 라이브 스트리밍 시 애니메이션 효과가 더 사실적입니다.
창작 콘텐츠: 숏폼 크리에이터와 디지털 아티스트가 이를 사용하여 다양한 재미있는 동적 이미지를 디자인하고, 보다 창의적인 콘텐츠를 제작할 수 있습니다.
5. 교육 및 고객 서비스
가상 어시스턴트: 교육 또는 고객 서비스 시나리오에서 일관된 이미지의 가상 교사 또는 고객 서비스를 생성하여 더 생생하고 개인화된 서비스를 제공합니다(예: 가상 교사가 학생들에게 수업을 할 때 항상 동일한 외모를 유지하는 것).
6. 광고 및 디지털 마케팅
영화급 광고: 복잡한 인물 동작과镜头 효과를 생성할 수 있어, 광고, 단편 영화 또는 애니메이션 프로모션 제작에 적합하며, 화질이 영화 수준에 도달합니다.













