
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Spark-TTS: 고효율 TTS 시스템, 제로샷 음성 복제 및 다국어 음성 합성 지원
Spark-TTS: 고효율 TTS 시스템, 제로샷 음성 복제 및 다국어 음성 합성 지원소개
Spark-TTS란 무엇인가요?
Spark-TTS는 SparkAudio 팀이 개발한 텍스트 음성 변환(TTS) 시스템으로, Qwen2.5를 기반으로 구축되어 텍스트에서 직접 음높이, 속도, 화자 특성을 제어할 수 있으며, 제로샷 음성 복제, 다국어 합성, 세밀한 음성 제어, Web UI를 통한 음성 생성을 지원하여 텍스트를 자연스럽고 고품질의 음성 콘텐츠로 빠르게 변환할 수 있습니다. 전통적인 TTS 시스템과 달리, LLM이 예측한 인코딩에서 직접 오디오를 재구성하여 음성 생성 프로세스를 단순화하고 효율성을 높였습니다.
Spark-TTS 핵심 기능
제로샷 음성 복제: Spark-TTS는 제로샷 음성 복제를 지원하여, 특정 화자의 학습 데이터가 없어도 화자의 음성을 복제할 수 있습니다. 다국어 및 코드 전환 시나리오에서 다양한 언어와 화자 간의 원활한 전환을 탁월하게 수행합니다.
다국어 지원: 이 시스템은 중국어와 영어를 지원하며, 다국어 합성 시 높은 자연스러움과 정확성을 유지합니다. 사용자가 한 언어로 텍스트를 입력하면 다른 언어의 음성 출력을 얻을 수 있습니다.
세밀한 음성 제어: 사용자는 성별, 음높이, 속도와 같은 매개 변수를 조정하여 가상 화자의 음성을 맞춤 설정할 수 있으며, 가상 진행자, 오디오북 등 다양한 음성 콘텐츠가 필요한 시나리오의 요구를 충족합니다.
효율적인 음성 합성: Spark-TTS는 완전히 Qwen2.5 아키텍처를 기반으로 하며, 추가적인 생성 모델이 필요 없고 LLM이 예측한 인코딩에서 직접 오디오를 재구성하여 프로세스를 단순화하고 복잡성을 줄입니다.
가상 화자 생성: 사용자는 매개 변수를 조정하여 고유한 음성 스타일을 부여한 자신만의 가상 화자를 생성할 수 있습니다.
Spark-TTS 기술 아키텍처
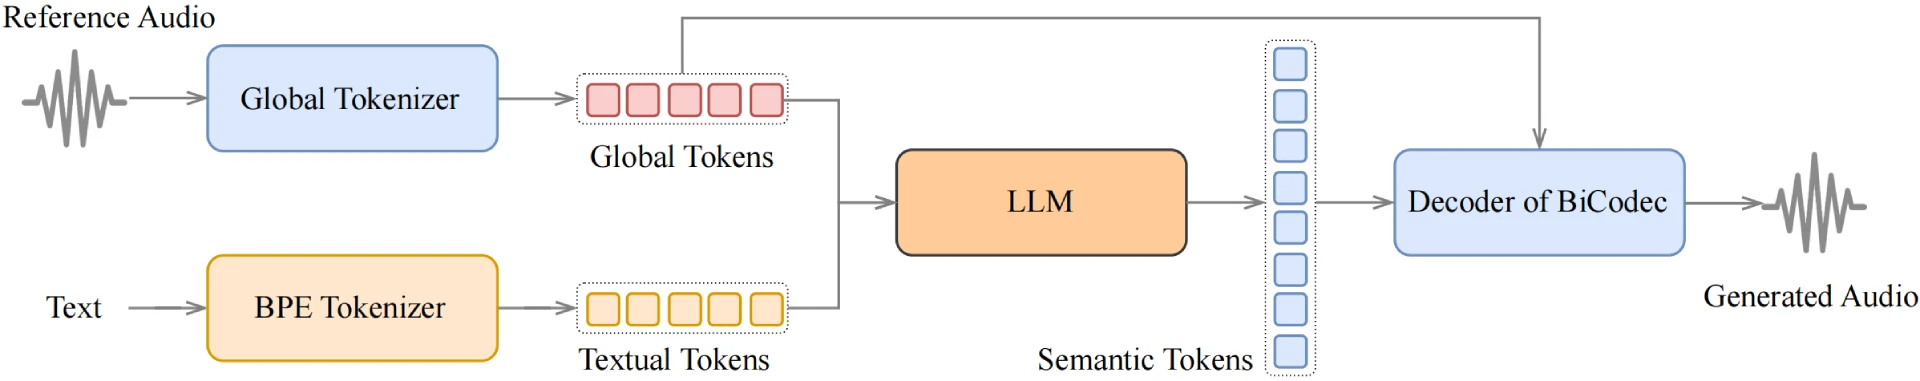
Spark-TTS의 기술적 기반은 BiCodec 단일 스트림 음성 코덱으로, 음성을 저비트율 의미 토큰(언어 콘텐츠 담당)과 고정 길이 전역 토큰(화자 속성 담당)으로 분해합니다. 이러한 분리 방식은 음성 특성의 유연한 조정을 가능하게 하며, Qwen2.5의 사고 연쇄(Chain-of-Thought) 기술과 결합하여 음성 생성의 품질과 제어 가능성을 더욱 향상시킵니다.
Spark-TTS 활용 시나리오
오디오북 제작: 자연스러운 음성 품질은 오디오북 제작에 특히 적합합니다.
가상 진행자: 음성 매개 변수를 조정하여 특정 요구 사항에 맞는 가상 화자를 생성합니다.
다국어 음성 합성: 다양한 언어를 지원하여 전 세계적 적용 범위를 확장합니다.
Spark-TTS 설치 및 사용
1. 환경 준비
Python 설치: Python 3.12가 설치되어 있는지 확인합니다.
Conda 설치: 가상 환경 관리에 사용되며, Miniconda 공식 웹사이트에서 다운로드하여 설치할 수 있습니다.
2. 저장소 복제
git clone https://github.com/SparkAudio/Spark-TTS.git
cd Spark-TTS
3. 의존성 설치
conda create -n sparktts -y python=3.12
conda activate sparktts
pip install -r requirements.txt
중국 본토에 있는 경우 알리윤(Aliyun) 미러를 사용할 수 있습니다:
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com
4. 사전 학습 모델 다운로드
다음 명령을 통해 사전 학습 모델을 다운로드합니다:
from huggingface_hub import snapshot_download
snapshot_download("SparkAudio/Spark-TTS-0.5B", local_dir="pretrained_models/Spark-TTS-0.5B")
5. 기본 사용법
다음 명령을 실행하여 음성 합성을 수행합니다:
python -m cli.inference \
    --text "text to synthesis." \
    --device 0 \
    --save_dir "path/to/save/audio" \
    --model_dir pretrained_models/Spark-TTS-0.5B \
    --prompt_text "transcript of the prompt audio" \
    --prompt_speech_path "path/to/prompt_audio"
6. Web UI 사용
python webui.py --device 0
GitHub 저장소:https://github.com/SparkAudio/Spark-TTS
HuggingFace 모델 라이브러리: https://huggingface.co/spaces/Mobvoi/Offical-Spark-TTS
논문:https://arxiv.org/pdf/2503.01710
데모:https://sparkaudio.github.io/spark-tts/
관련 정보:
Llasa: Llama 기반의 텍스트 음성 변환(TTS)으로, 자연스럽고 유창하며 감정이 풍부한 생성 효과
Octave: Hume AI에서 발표한 맥락 인식 및 감정 적응이 가능한 TTS 모델














