
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Step-Audio: Stepfun이 출시한 최초의 오픈소스 음성 상호작용 모델
Step-Audio: Stepfun이 출시한 최초의 오픈소스 음성 상호작용 모델소개
Step-Audio는 업계 최초의 제품급 오픈소스 음성 상호작용 모델로, 시나리오 요구 사항에 따라 감정, 방언, 언어, 노래, 개인화 스타일을 포함한 다양한 음성 표현을 생성할 수 있는 능력을 갖추고 있으며, 상호작용이 자연스럽고 원활합니다. 중국어水平考试 6급 평가에서 Step-Audio는 뛰어난 성능을 보이며, 중국어를 가장 잘 이해하는 오픈소스 모델로赞誉받았습니다. 이ai 모델은 阶跃星辰과 吉利汽车 그룹이 공동으로 연구 개발했으며, 2025년 2월 18일에 공식적으로 오픈소스로 공개되었습니다.
Step-Audio 기능 특징:
통합 모델: 130억 개의 파라미터를 기반으로 한 멀티모달 모델로, 음성 이해와 생성을 통합하며, 음성 인식, 의미 이해, 대화, 음성 클로닝, 오디오 편집 및 합성을 동시에 처리할 수 있습니다.
감정 및 스타일 다양화: 필요에 따라 다양한 감정(분노/기쁨/슬픔), 방언(광둥어/쓰촨어 등), 언어, 노래(RAP/허밍) 및 개인화 스타일의 음성을 생성하며, 감정, 방언, 언어 및 노래를 정밀하게 제어합니다.
고품질 대화: 자연스럽고 고품질의 대화 경험을 제공하며, 실제 사람과 대화하는 것처럼 자연스럽고 원활한 상호작용을 제공합니다.
지능형 상호작용: 논리적 추론, 창작, 명령 제어, 언어, 역할 수행 및 텍스트 게임과 같은 고급 상호작용 특성을 갖추고 있습니다.
Step-Audio 적용 시나리오:
지능형 고객 서비스: 개인화되고 감정적인 서비스를 제공하여 사용자 경험을 향상시킵니다.
오디오북: 감정이 담긴 낭독을 생성하여 오디오북 몰입감을 높입니다.
게임 NPC: 게임 캐릭터에 자연스럽고 원활한 음성 상호작용을 제공합니다.
회의 기록: 음성을 실시간으로 텍스트로 변환하고 음성 피드백을 제공합니다.
교육 지원: 개인화된 교육 보조 도우, 교육 스타일과 어조를 조정합니다.
Step-Audio 기술 특징:
고압축비 기술: Video-VAE 등 고효율 압축 기술을 사용하여 데이터 처리를 최적화합니다.
이중 언어 처리 능력: Hunyuan-CLIP 및 Step-LLM을 활용하여 중국어 및 영어 프롬프트를 처리합니다.
DIT 아키텍처 및 Video-DPO 알고리즘: 복잡한 비디오 오디오 데이터 처리를 최적화합니다.
대규모 데이터셋 학습: 대규모 데이터셋을 구축하여 모델의 일반화 및 세부 사항 표현을 보장합니다.
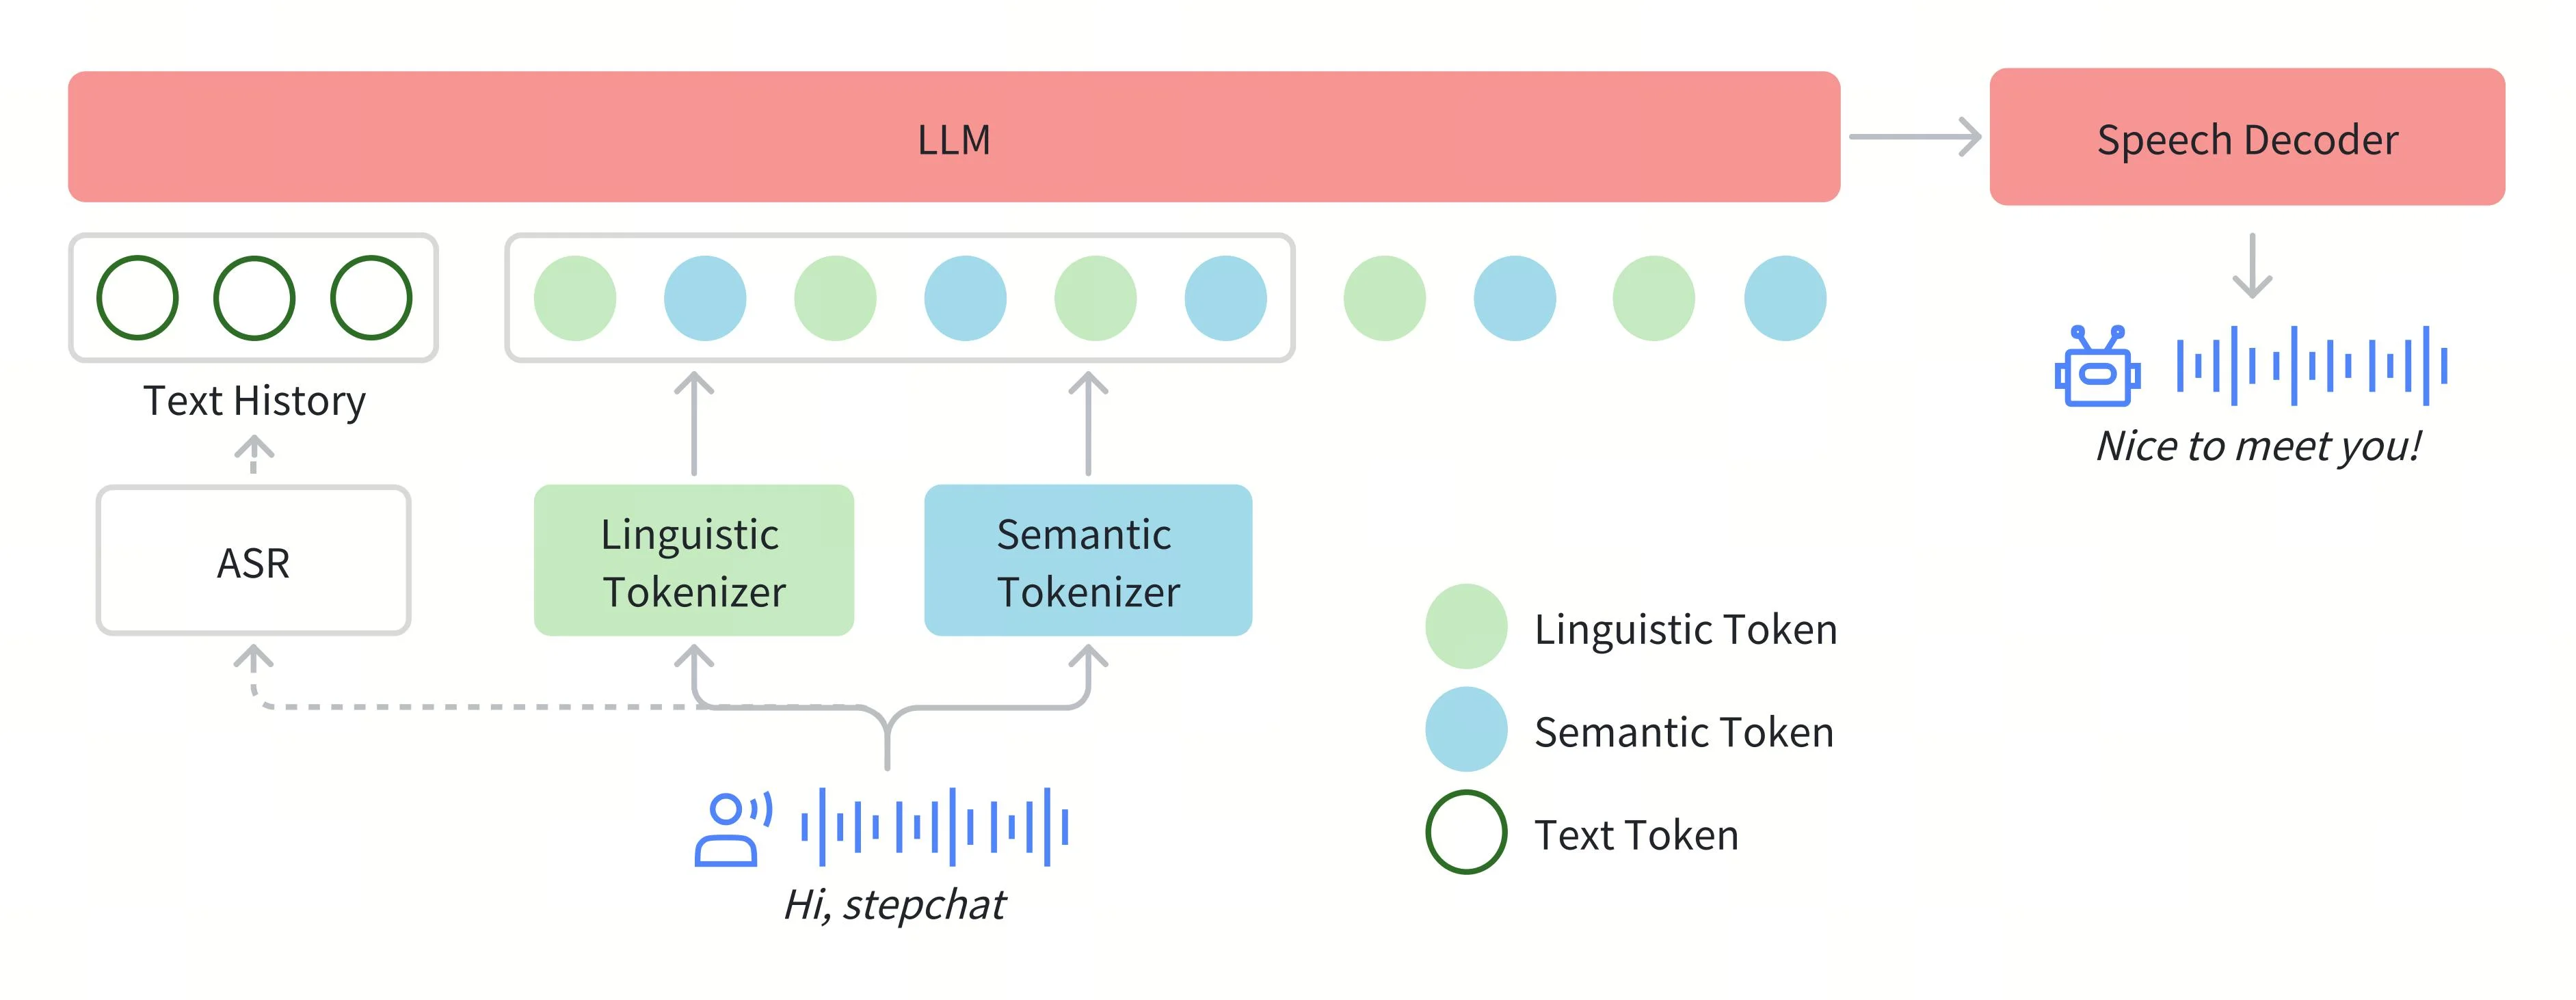
Step-Audio 사용 방법:
모델 획득: 跃问 APP 또는 Hugging Face 등 플랫폼의 Step-Audio 오픈소스 버전에 접속합니다.
기술 보고서: arxiv.org 또는 GitHub의 기술 보고서를 참조하여 자세한 내용을 확인합니다.
API 인터페이스: API 호출을 통해 음성 상호작용을 구현하며, MIT 오픈소스 라이선스를 따릅니다.
통합 개발: 공식 문서 또는 예제 코드에 따라 애플리케이션에 통합합니다.
맞춤형 학습: 고급 사용자는 특정 시나리오에 맞게 미세 조정하거나 성능을 향상시킬 수 있습니다.
Step-Audio 획득 방법
GitHub: https://github.com/stepfun-ai/Step-Audio
ModelScope: [点击访问]
기술 보고서: [点击访问]
PAI Model Gallery 원클릭 배포 지원 [点击访问]














