
 대본 기획 도우미▸
 AI 앱
 AI 뉴스

MakeAnything: 일관성 있는 시퀀스 이미지 생성 모델
MakeAnything: 일관성 있는 시퀀스 이미지 생성 모델소개
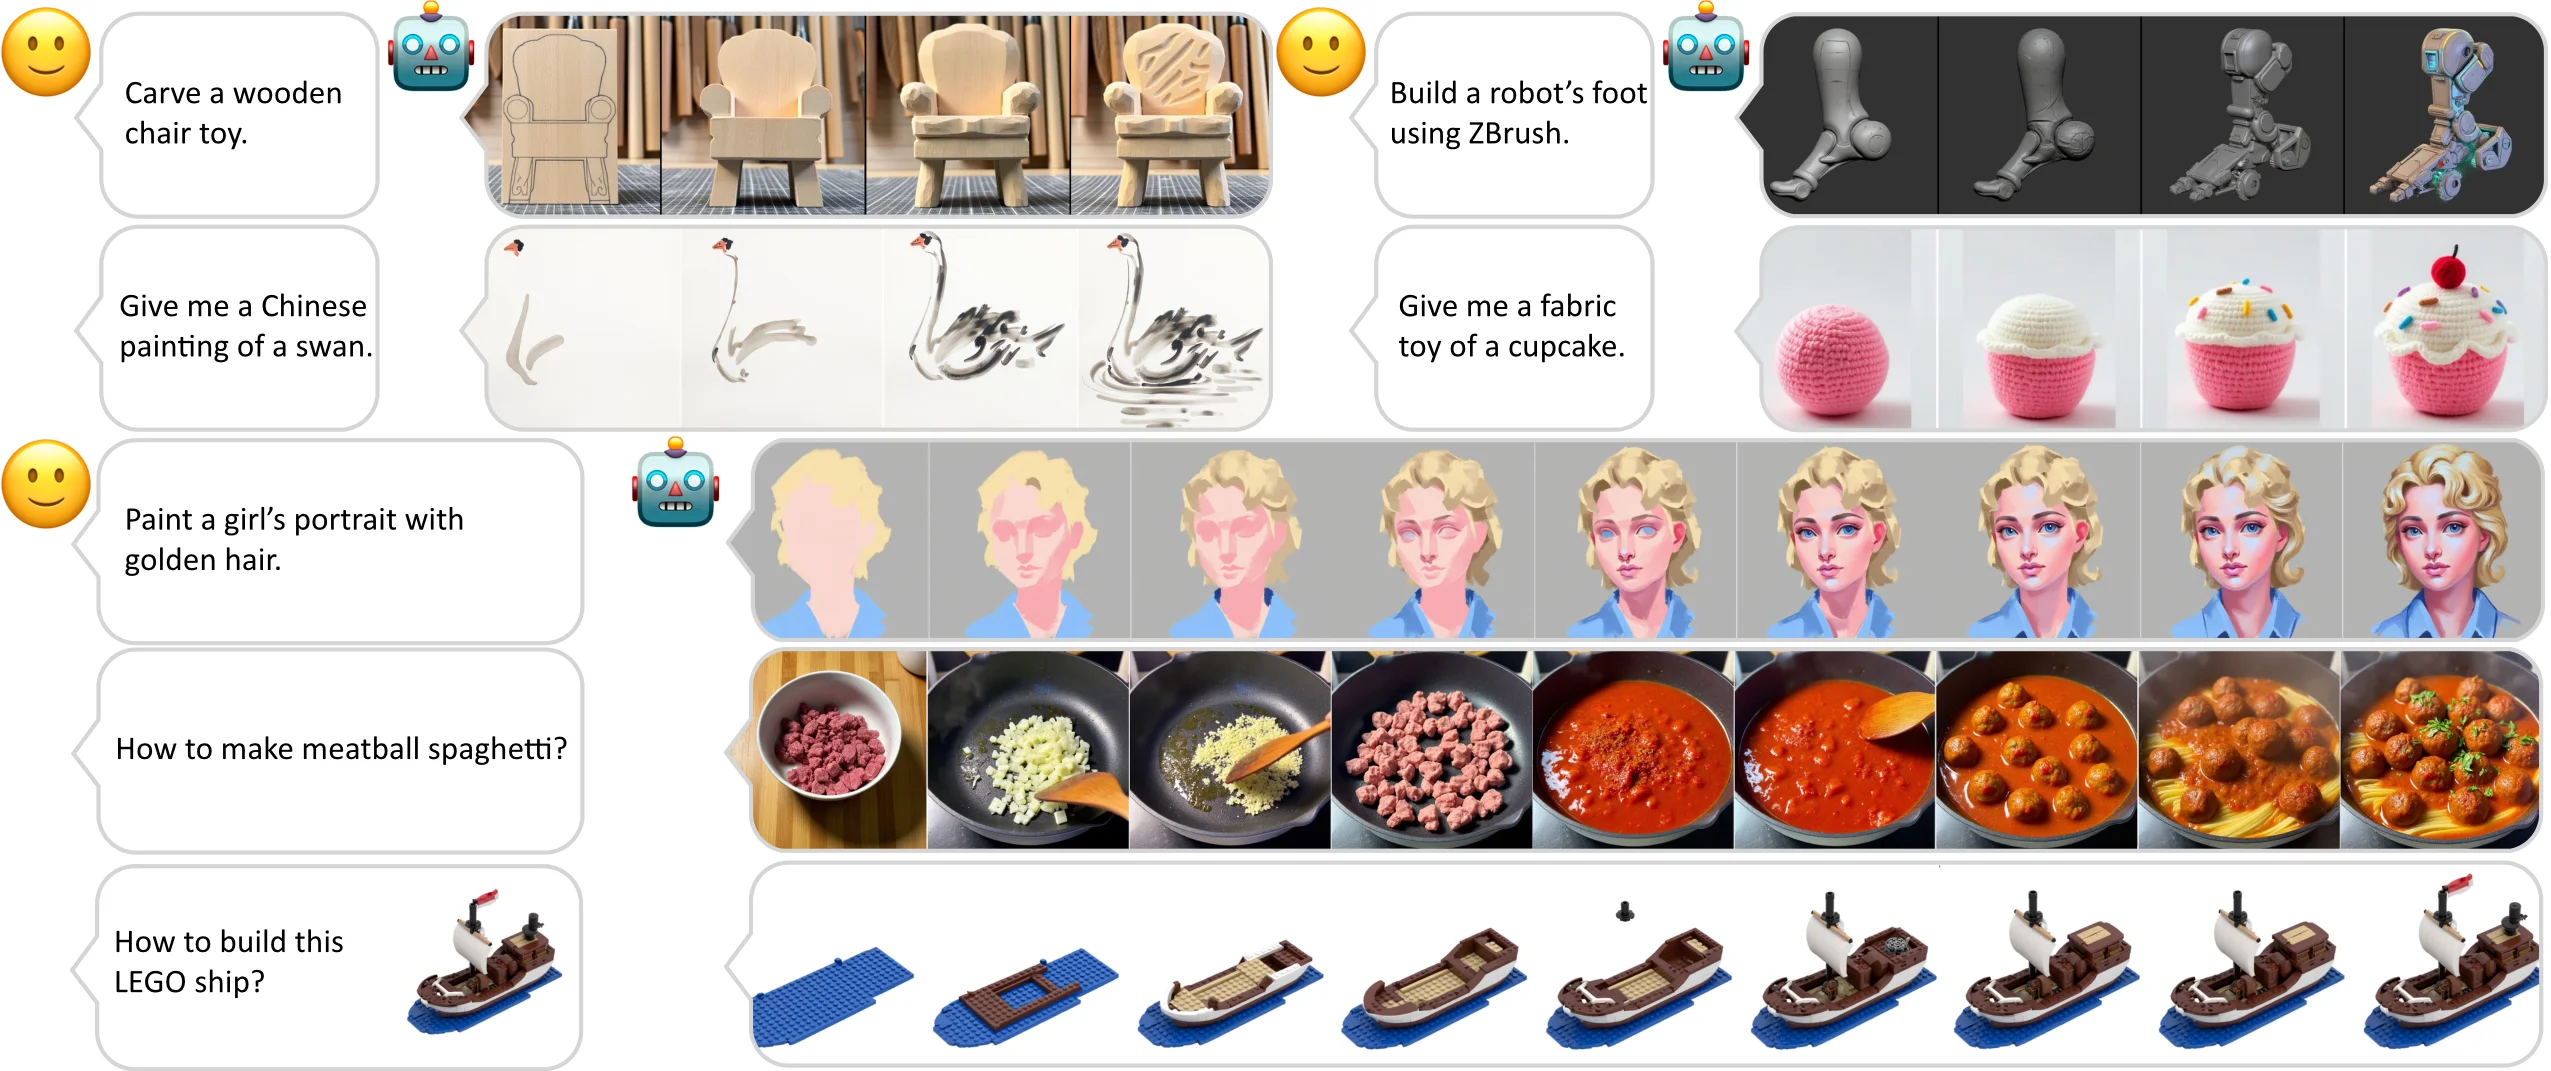
MakeAnything은 싱가포르 국립대학교에서 개발한 확산 트랜스포머(Diffusion Transformers) 기반의 시퀀스 생성 모델로, 텍스트 설명을 통해 시퀀스 이미지를 생성할 수 있으며, 강력한 생성 능력을 바탕으로 일관성 있는 다중 하위 이미지 퍼즐을 제공합니다.
MakeAnything 기능 특징:
확산 트랜스포머: 확산 트랜스포머의 뛰어난 성능을 활용하여 복잡한 이미지를 생성합니다.
텍스트-이미지 변환: 텍스트 설명을 다양한 스타일의 이미지로 변환하는 것을 지원하며, 학습과 프롬프트를 통해 생성 효과를 향상시킵니다.
하위 이미지 일관성: 이미지 생성 과정에서 생성된 다중 하위 이미지가 시각적으로 일관성을 유지하도록 보장합니다.
MakeAnything 기술 특징:
이 모델은 비대칭 저秩 적응(LoRA) 기술과 ReCraft 모델을 결합하여 생성 과정을 더욱 효율적으로 만들었으며, 정적 이미지를 해석 가능한 창작 과정으로 변환하여 사용자가 각 단계를 명확히 알 수 있게 함으로써 다단계 시퀀스를 생성할 때 논리적连贯성 및 시각적 일관성을 유지하는 문제를 해결합니다.
MakeAnything 사용 단계:
학습 데이터 준비: 작업 요구 사항에 따라 텍스트와 이미지 데이터 세트를 준비하며, 일반적으로 데이터 정제 및 형식 정리 작업을 수행해야 합니다.
모델 학습: MakeAnything 데이터 세트에서 비대칭 LoRA 방법을 사용하여 학습을 진행하고, 모델을 조정하여 생성 능력을 향상시킵니다.
콘텐츠 생성: 학습이 완료된 후 사용자는 텍스트 프롬프트를 입력할 수 있으며, 모델은 이를 기반으로 관련 이미지와 기타 멀티모달 콘텐츠를 생성합니다.
후처리: 생성된 콘텐츠는 후처리 단계에서 더욱 최적화될 수 있으며, 색상 조정이나 디테일 추가 등을 통해 사용자 요구에 더욱 부합되도록 합니다.
MakeAnything 적용 범위:
조각 디자인: 조각 디자인의 스케치와 3D 모델을 생성하는 데 사용됩니다.
회화 창작: 자동화된 예술 회화에 적용되어 창작자에게 새로운 영감을 제공합니다.
자동차 변형: 자동차 디자인 분야에서 다양한 시점과 스타일의 변형 효과를 구현합니다.
공예 및 DIY: 사용자는 다양한 공예 기술을 다루는 단계별 안내를 생성하여 실제 작업에 활용할 수 있습니다.
요리 및 레시피: 상세한 요리 단계를 생성하여 사용자가 복잡한 요리를 만드는 과정을 학습하도록 돕습니다.
Github:https://github.com/showlab/MakeAnything














