
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Tarsier: 바이트댄스가 출시한 대규모 비전-언어 모델
Tarsier: 바이트댄스가 출시한 대규모 비전-언어 모델소개
Tarsier는 바이트댄스에서 출시한 대규모 시각 언어 모델(LVLM) 시리즈로, 비디오 이해 작업(비디오 설명 생성, 질의응답, 위치 파악, 환각 테스트 등)에 중점을 둡니다.
Tarsier의 주요 기능
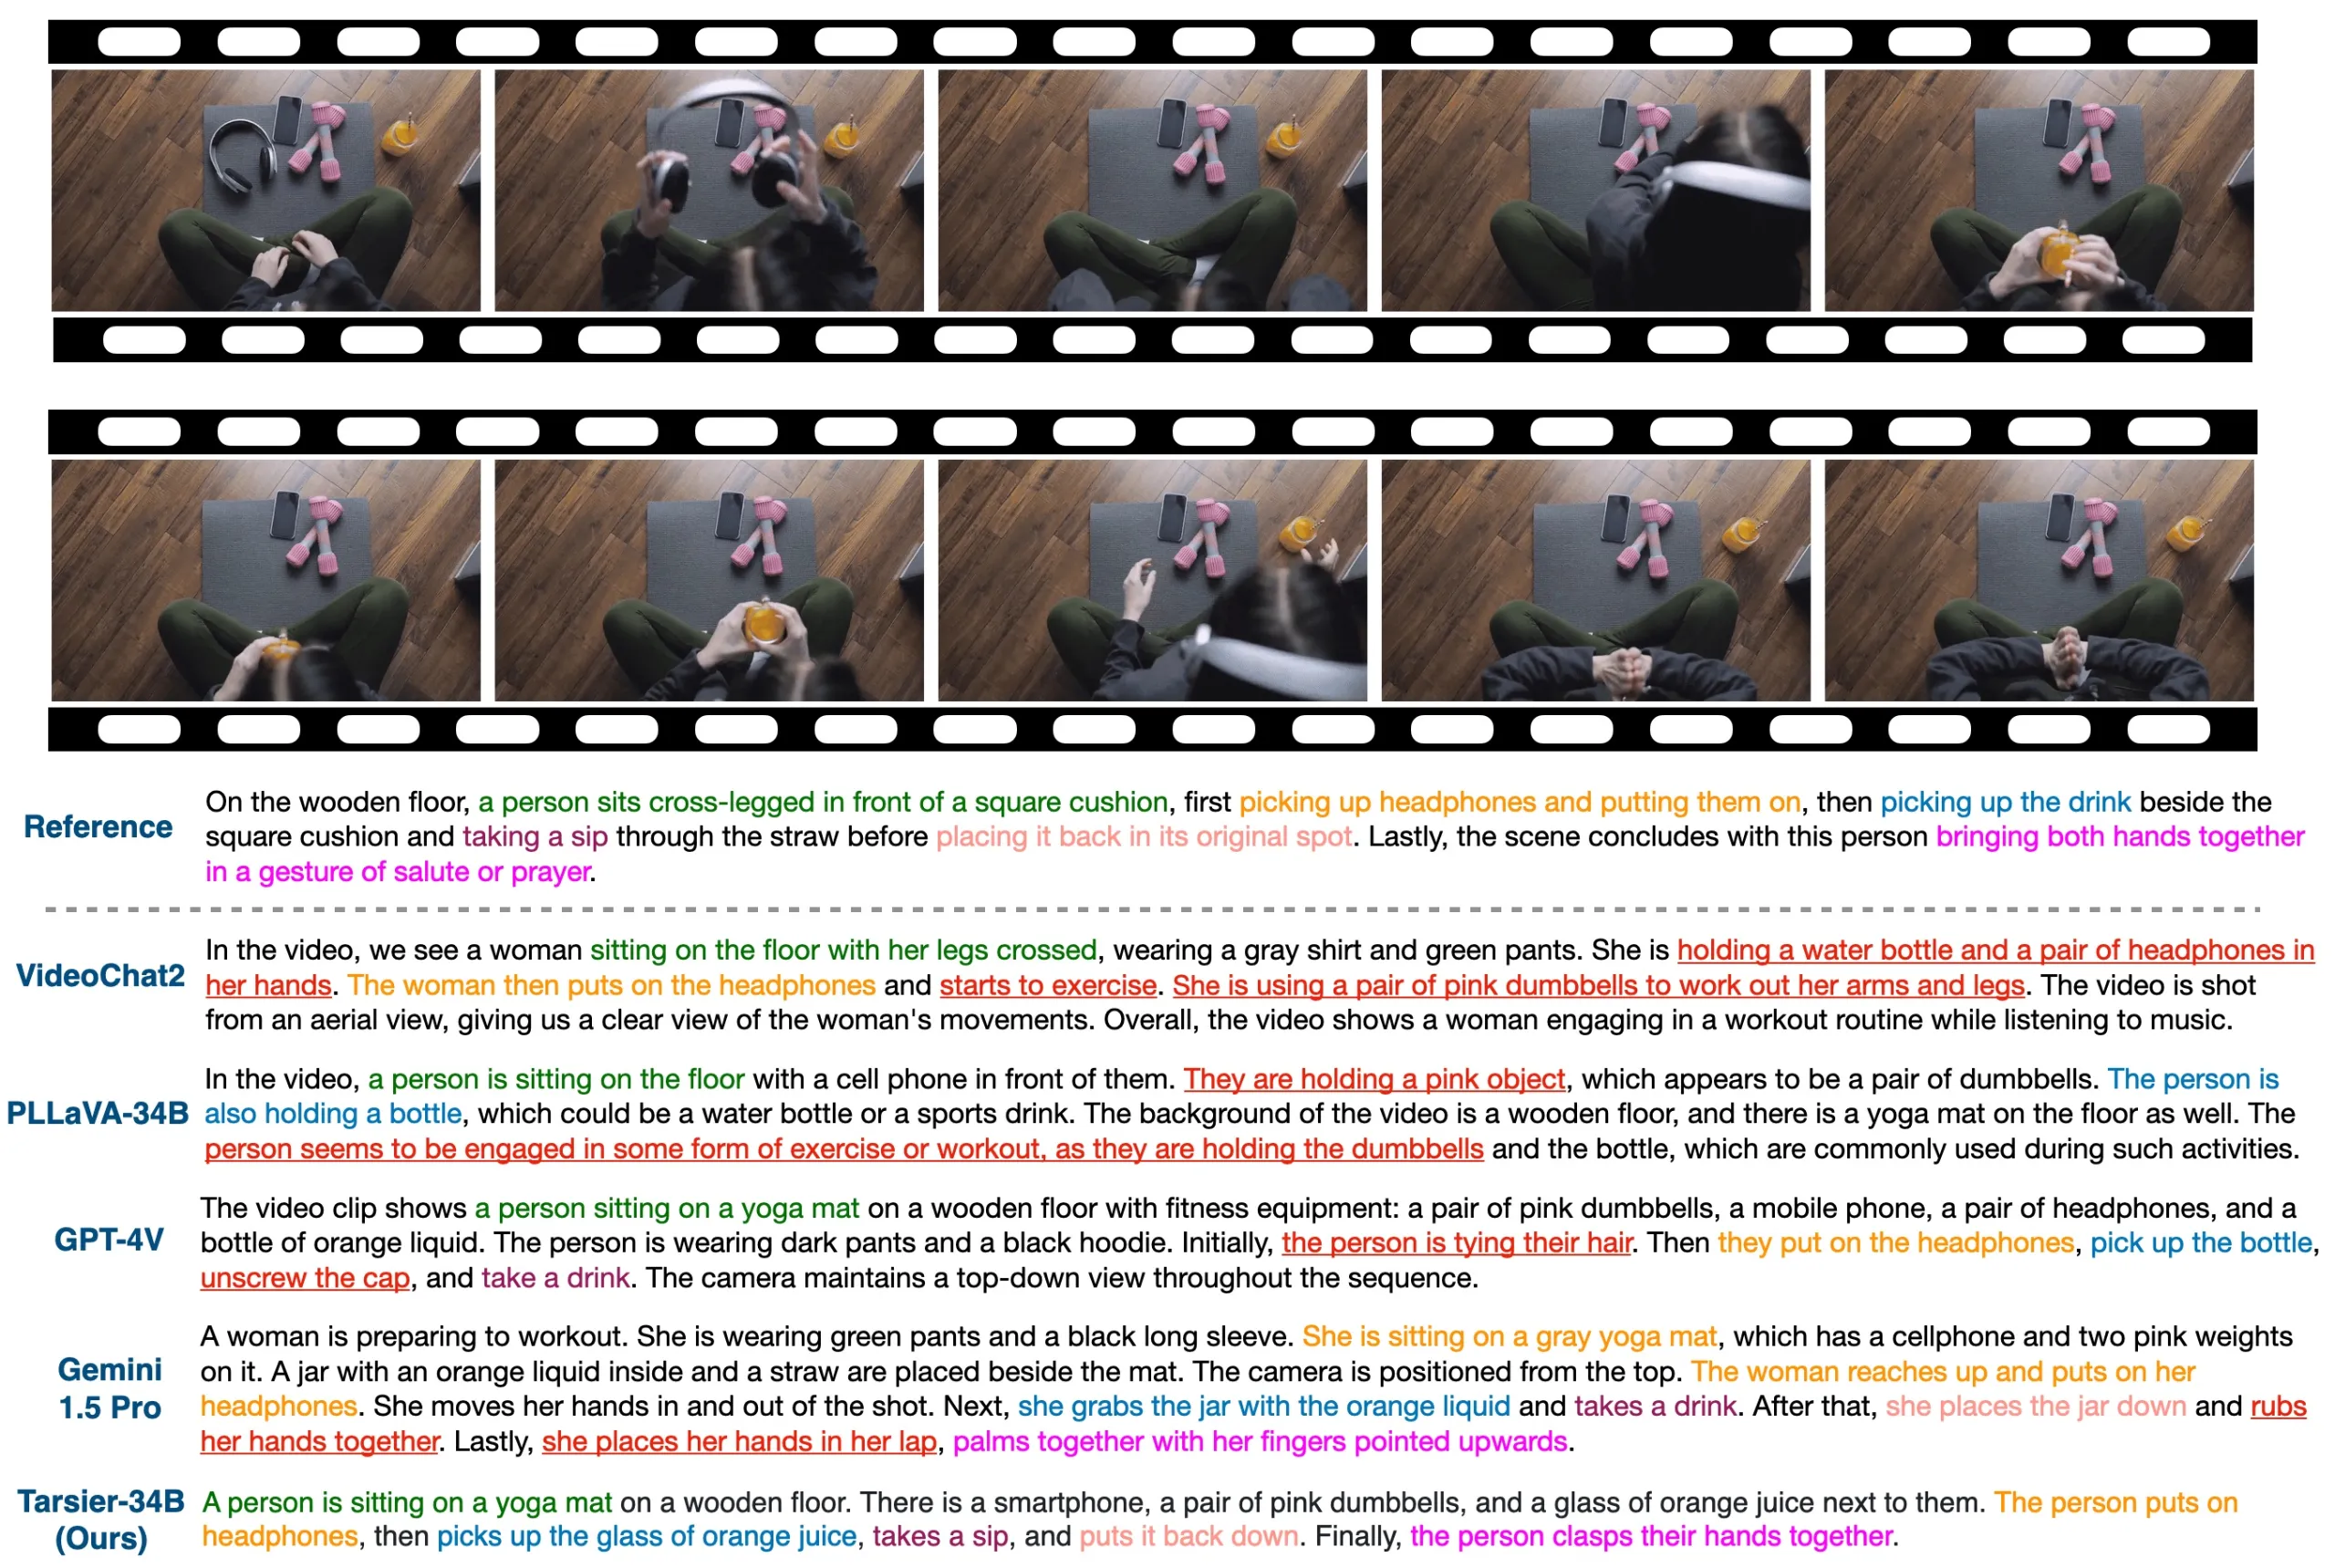
비디오 설명 생성: Tarsier는 동작, 장면, 줄거리 등 비디오의 다양한 세부 사항을 다루는 고품질의 비디오 설명을 생성하여 사용자가 비디오 콘텐츠를 더 잘 이해할 수 있도록 도와줍니다.
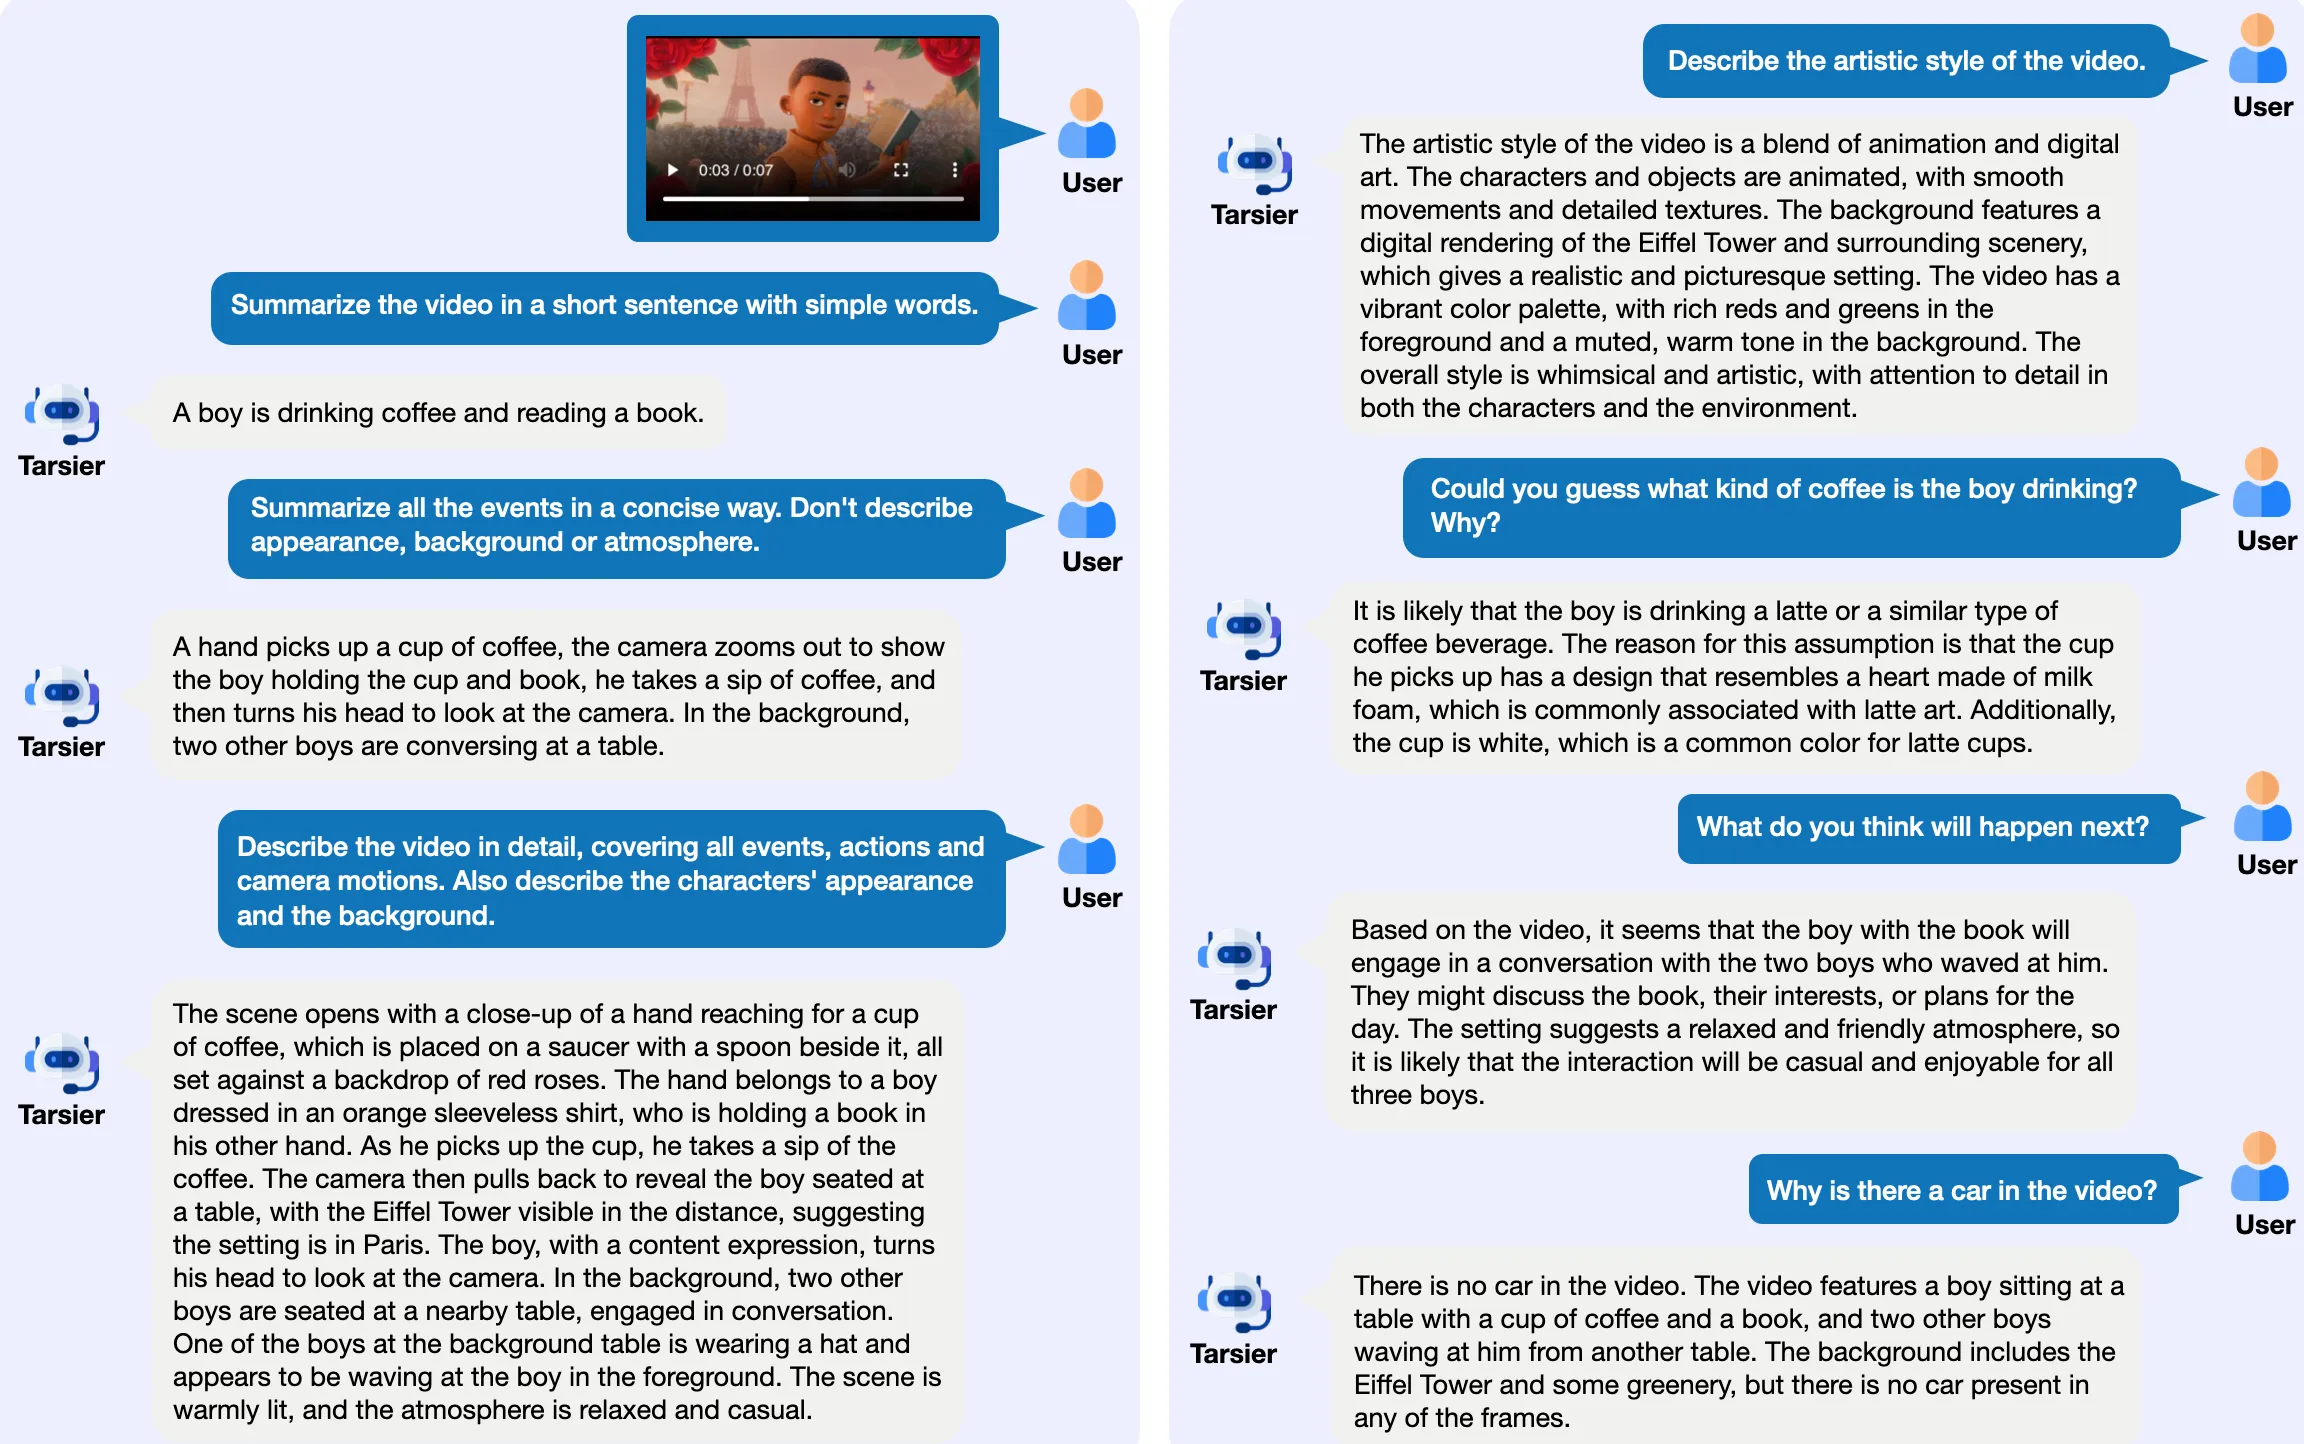
질의응답 기능: Tarsier 모델은 비디오 질의응답 기능을 지원하며, 사용자는 비디오 콘텐츠를 기반으로 질문을 할 수 있고 모델이 관련 답변을 제공합니다.
위치 파악 기능: 비디오에서 특정 이벤트가 발생하는 시점을 감지하고 위치를 파악하며, 여러 비디오 구간의 위치 파악을 지원하여 특정 객체나 장면을 식별하고 표시할 수 있습니다.
환각 테스트: 훈련 전략 최적화를 통해 Tarsier2는 모델이 허위 정보를 생성할 가능성을 크게 줄였습니다.
다국어 지원: 다양한 언어의 비디오 설명 생성을 지원합니다.
Tarsier 활용 시나리오:
콘텐츠 제작: Tarsier는 콘텐츠 제작자가 비디오 설명을 생성하는 데 도움을 주어 비디오의 접근성과 검색 엔진 최적화(SEO) 효과를 향상시킵니다.
교육 분야: 교육용 비디오에서 Tarsier는 상세한 콘텐츠 설명을 제공하여 학생이 학습 자료를 더 잘 이해하도록 돕습니다.
소셜 미디어: 소셜 플랫폼은 Tarsier를 활용하여 비디오 콘텐츠에 대한 자동 설명을 생성하고 사용자 경험을 향상시킬 수 있습니다.
비디오 모니터링: 보안 모니터링 분야에서 Tarsier는 비디오 스트림을 분석하고 실시간 설명을 생성하여 보안 담당자가 잠재적 위협을 신속하게 식별하도록 지원합니다.
로봇: 지정된 작업을 위한 상세한 단계별 지침을 생성합니다.
자율 주행: 차량이 도로 상황을 인식하고 의사 결정을 내리는 데 도움을 줍니다.
Tarsier 모델의 최신 버전인 Tarsier2는 특히 데이터 양과 다양성 측면에서 상당한 개선이 이루어졌습니다. 사전 학습 데이터가 1,100만에서 4,000만 개의 비디오-텍스트 쌍으로 확장되어 모델의 학습 능력이 강화되었습니다. 또한 Tarsier2는 감독 미세 조정 단계에서 세밀한 시간 정렬을 도입하여 비디오 설명의 정확성과 세부 정보 포착 능력을 더욱 향상시켰습니다. 직접 선호도 최적화(DPO) 훈련을 통해 Tarsier2는 인간의 선호도에 더 부합하는 비디오 설명을 생성할 수 있으며 환각 생성 가능성을 줄입니다.
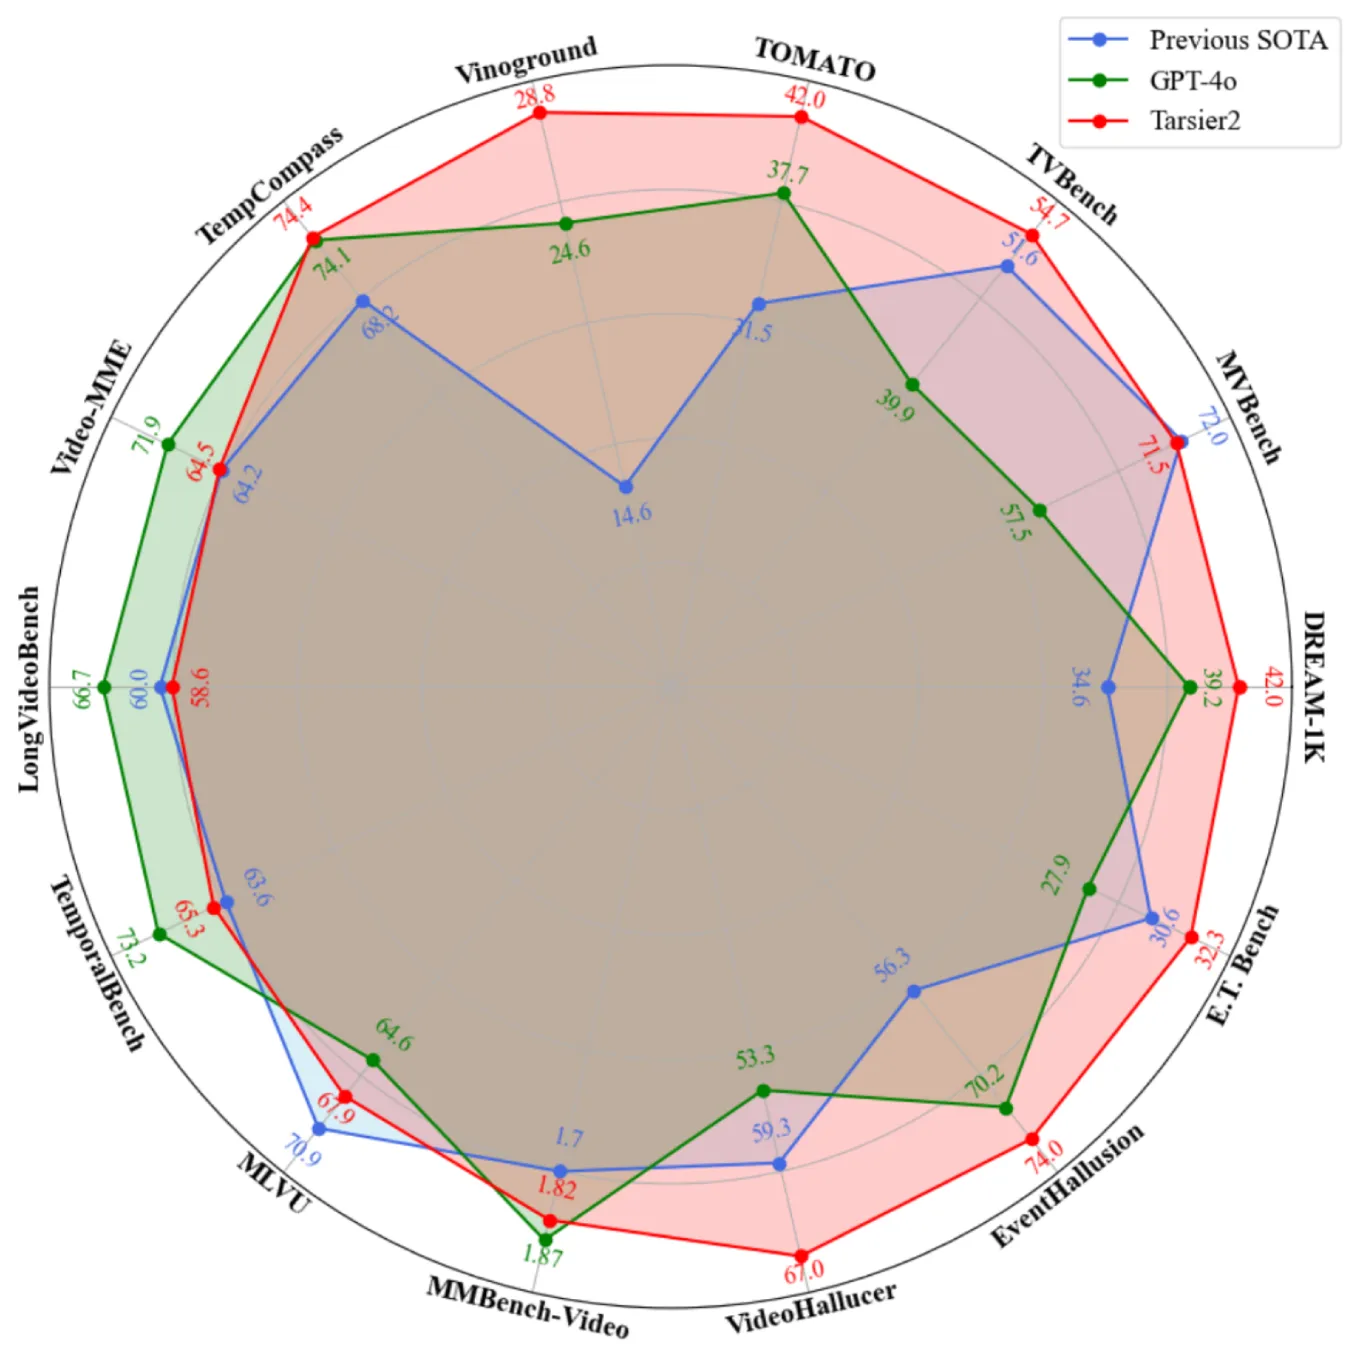
성능 평가 측면에서 Tarsier2는 DREAM-1K 벤치마크 테스트에서 뛰어난 성능을 보였으며, F1 점수가 GPT-4o보다 2.8%, Gemini-1.5-Pro보다 5.8% 높았습니다. 15개의 공개 벤치마크 테스트에서 Tarsier2는 비디오 질의응답, 비디오 위치 파악, 환각 테스트, 질의응답 등을 포함하여 새로운 최고 기록을 달성했으며, 강력한 범용 시각 언어 모델로서의 다재지다함을 입증했습니다.
비디오 설명 외에도 질의응답, grounding(위치 파악), embodied intelligence(구현 지능) 등 다양한 작업에서도 강력한 성능을 보여줍니다.
논문: https://arxiv.org/abs/2501.07888
Code: https://github.com/bytedance/tarsier
Dataset: https://huggingface.co/datasets/omni-research/DREAM-1K
Demo: https://huggingface.co/spaces/omni-research/Tarsier2-7b














