
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
ChatTTS-Forge: 올인원 TTS 도구
ChatTTS-Forge: 올인원 TTS 도구소개
ChatTTS-Forge는 TTS 생성 모델을 중심으로 개발된 프로젝트로, 사용자에게 유연한 TTS 생성 기능을 제공하며, 다양한 음색, 스타일 제어, 장문 추론 등의 기능을 지원합니다. ChatTTS-Forge는 다양한 API(애플리케이션 프로그래밍 인터페이스)를 제공하여, 개발자가 이러한 API를 직접 사용하여 손쉽게 텍스트를 음성으로 변환할 수 있도록 합니다.
ChatTTS-Forge는 TTS(텍스트 음성 변환) 생성 모델을 중심으로 개발된 프로젝트입니다. 사용자에게 유연한 TTS 생성 기능을 제공하며, 다양한 음색, 스타일 제어, 장문 추론 등의 기능을 지원합니다.
ChatTTS-Forge는 다양한 API(애플리케이션 프로그래밍 인터페이스)를 제공하여, 개발자가 이러한 API를 직접 사용하여 손쉽게 텍스트를 음성으로 변환할 수 있습니다. 또한, 사용자가 프로그래밍 없이 웹 페이지에서 직접 텍스트를 입력하고 음성을 생성할 수 있는 사용하기 쉬운 웹 인터페이스(WebUI)도 제공합니다.
ChatTTS-Forge의 주요 특징:
TTS 생성: ChatTTS, CosyVoice, FishSpeech, GPT-SoVITS 등 다양한 TTS 모델 추론을 지원하여, 사용자가 음성을 자유롭게 선택하고 전환할 수 있습니다.
음색 관리: 다양한 음색이 내장되어 있으며, 사용자 정의 음색을 업로드할 수 있습니다. 사용자는 오디오나 텍스트를 업로드하여 사용자 정의 음색을 생성하고 사용할 수 있습니다.
스타일 제어: 음성 속도, 음높이, 볼륨 조정 및 출력 품질 향상을 위한 음성 강화(Enhancer) 추가 등 다양한 스타일 제어 옵션을 제공합니다.
장문 텍스트 처리: 초장문 텍스트의 자동 분할 및 추론을 지원하여, 장문 오디오 콘텐츠 생성을 처리할 수 있습니다.
SSML 지원: XML과 유사한 SSML 구문을 사용하여 고급 TTS 합성 제어를 수행할 수 있어, 보다 상세한 음성 생성 시나리오에 적합합니다.
ASR(자동 음성 인식): Whisper 모델을 통합하여 음성-텍스트 변환 기능을 지원합니다.
ChatTTS-Forge의 기술 및 방법:
API 서버: Python으로 작성된 API 서버는 효율적인 TTS 서비스를 제공하며, 다중 동시 요청 및 사용자 정의 구성을 지원합니다.
WebUI: Gradio 기반의 사용자 인터페이스로, 사용자는 간단한 조작 인터페이스를 통해 TTS 기능을 경험할 수 있습니다.
Docker 지원: 로컬 및 서버에서의 배포 프로세스를 간소화하기 위해 Docker 컨테이너화 배포 옵션을 제공합니다.
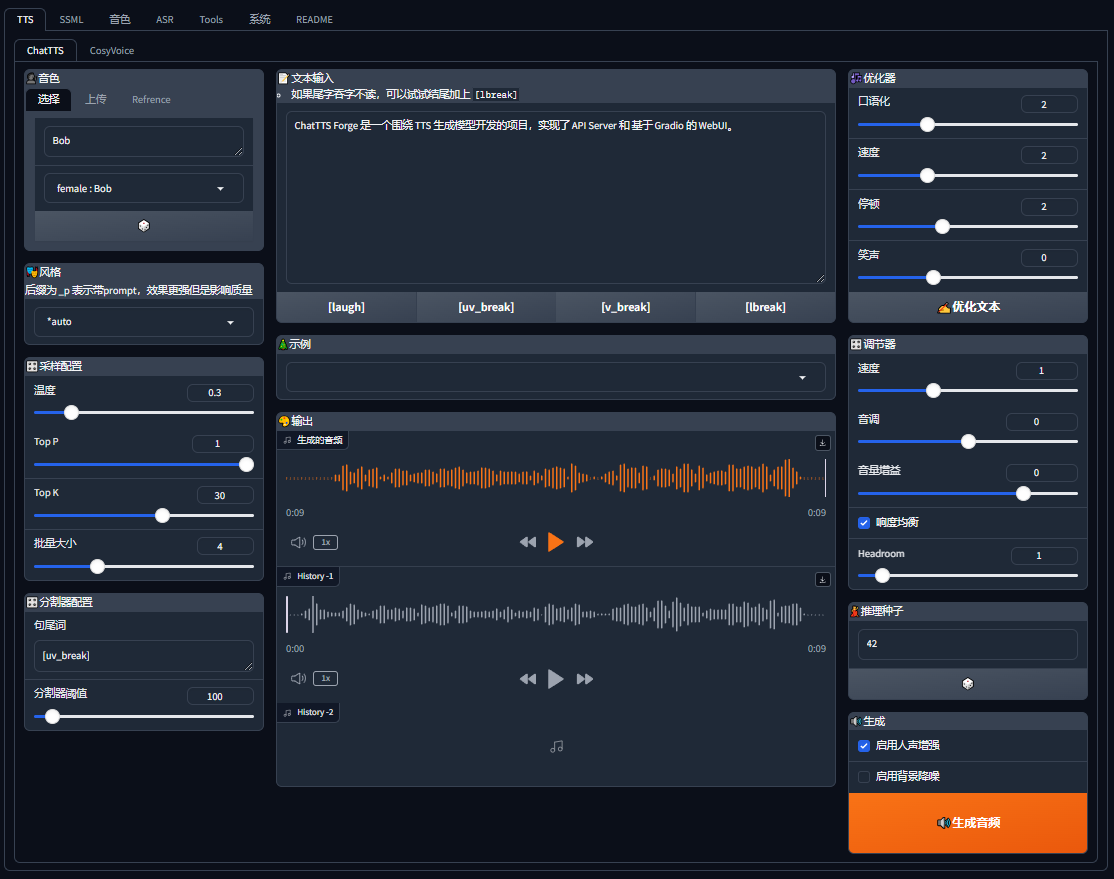
ChatTTS-Forge WebUI의 특징:
TTS(텍스트 음성 변환): WebUI를 통해 사용자는 다양한 TTS 모델을 사용하여 텍스트를 입력하고 음성을 생성할 수 있습니다.
음색 전환: 다양한 사전 설정 음색 전환을 지원하여, 사용자가 다른 음색을 선택하여 음성을 생성할 수 있습니다.
사용자 정의 음성 업로드: 사용자가 자신의 음성 파일을 업로드하여 실시간으로 개인화된 음성을 생성할 수 있습니다.
스타일 제어: 특정 요구 사항을 충족하는 음성을 생성하기 위해 음성 속도, 음높이, 볼륨 등 매개변수를 포함한 음성 스타일을 조정할 수 있습니다.
장문 텍스트 처리: 매우 긴 텍스트 처리를 지원하며, 긴 텍스트를 자동으로 작은 단위로 분할하여 순차적으로 음성을 생성하므로 장문 오디오 콘텐츠 생성에 적합합니다.
일괄 처리: 사용자는 일괄 처리 크기를 설정하여 장문 텍스트의 추론 속도를 높일 수 있습니다.
리파이너(Refiner): 이 도구를 사용하면 생성된 음성을 최적화하기 위해 텍스트를 미세 조정할 수 있으며, 무한 길이의 텍스트를 처리하는 데 특히 유용합니다.
음성 향상: 생성된 음성의 품질을 높이고 더 자연스럽게 들리도록 하기 위해 향상 모델을 통합합니다.
생성 기록: 최근 3회 생성 결과를 저장하여, 사용자가 다양한 설정에서의 음성 효과를 쉽게 비교할 수 있도록 합니다.
다중 모델 지원: WebUI는 ChatTTS, CosyVoice, FishSpeech, GPT-SoVITS 등 다양한 TTS 모델을 지원하여, 사용자가 자신의 요구에 맞는 모델을 선택할 수 있습니다.
SSML 지원: XML과 유사한 SSML 구문을 사용하여 음성 합성 프로세스를 제어할 수 있어, 더 복잡한 제어가 필요한 시나리오에 적합합니다.
팟캐스트 도구: 블로그 스크립트로부터 장문, 다중 캐릭터의 오디오 콘텐츠를 생성하는 데 도움을 줍니다.
자막 생성: 자막 파일로부터 SSML 스크립트를 생성하여 다양한 음성 콘텐츠를 만듭니다.
GitHub: https://github.com/lenML/ChatTTS-Forge
온라인 체험: https://huggingface.co/spaces/lenML/ChatTTS-Forge














