
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Emote Portrait Alive: 정적인 이미지가 노래하는 영상으로 살아난다
Emote Portrait Alive: 정적인 이미지가 노래하는 영상으로 살아난다소개
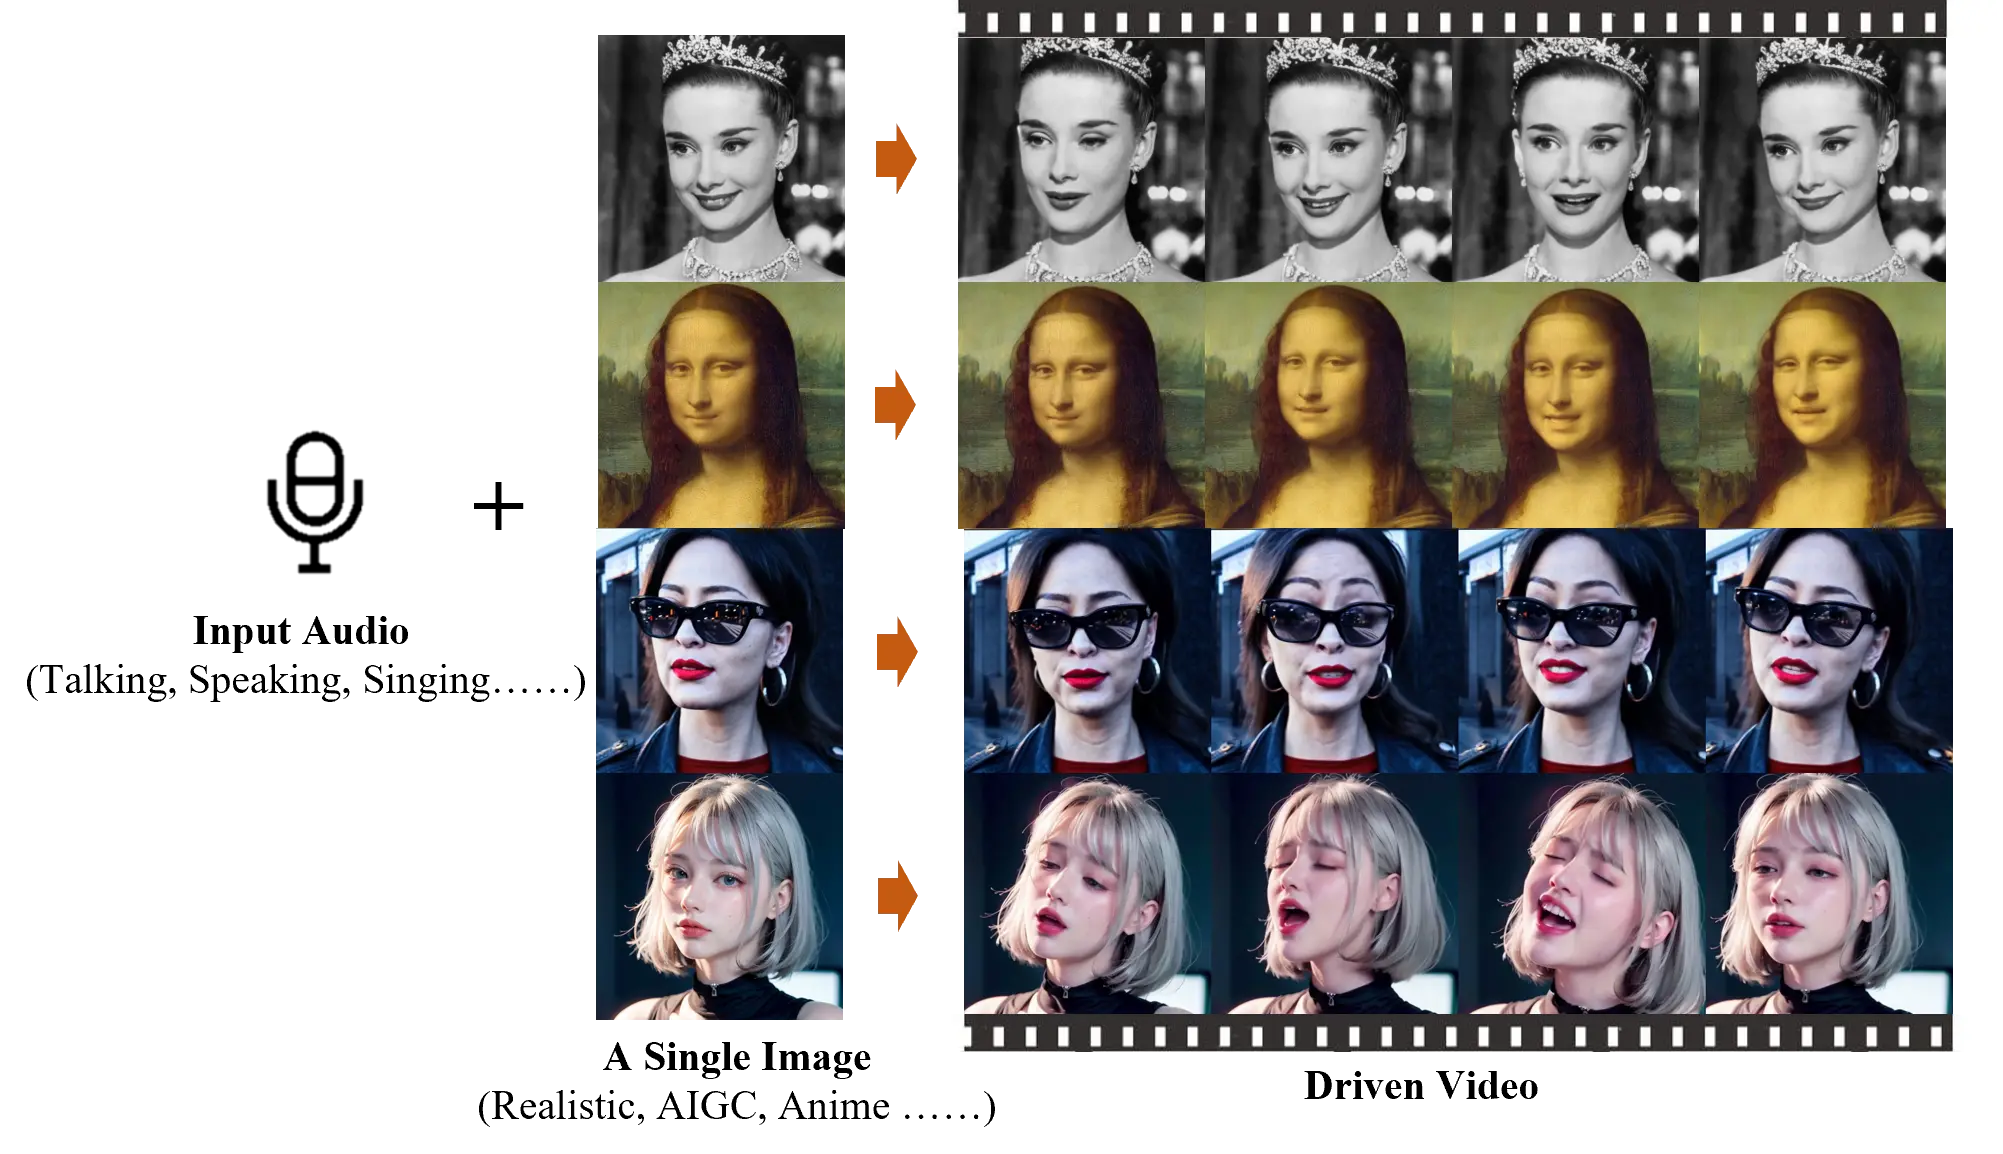
Emote Portrait Alive는 알리바바(Alibaba)에서 발표한 EMO로, 오디오 기반의 AI 포트레이트 비디오 생성 프레임워크입니다. 단일 참조 이미지와 음성 오디오(말하기 및 노래하기 등)를 입력하면 Emote Portrait Alive는 풍부한 표정과 다양한 머리 자세를 가진 음성 포트레이트 비디오를 생성할 수 있어, 사진 속人物이 오디오 내용에 따라 자연스럽게 입을 움직여 말하거나 노래하며, 매우 사실적인 표정과 머리 자세를 보여줍니다. 동시에 입력된 비디오의 길이에 따라 임의의 길이의 비디오를 생성할 수 있습니다.
Emote Portrait Alive 기능 및 특징:
오디오 기반의 비디오 생성: EMO는 입력된 오디오(말하기 또는 노래하기 등)를 기반으로 사전 녹화된 비디오 클립이나 3D 얼굴 모델에 의존하지 않고 직접 비디오를 생성할 수 있습니다.
높은 표현력과 사실성: 생성된 비디오는 높은 표현력을 가지며, 미묘한 미세 표정을 포함한 인간의 얼굴 표정细微한 차이와 오디오 리듬에 맞는 머리 움직임을 포착하고 재현할 수 있습니다.
원활한 프레임 전환: 비디오 프레임 간의 전환이 자연스럽고 매끄럽도록 보장하여 얼굴 왜곡이나 프레임 간抖动의 문제를 방지함으로써 비디오의 전체적인 품질을 향상시킵니다.
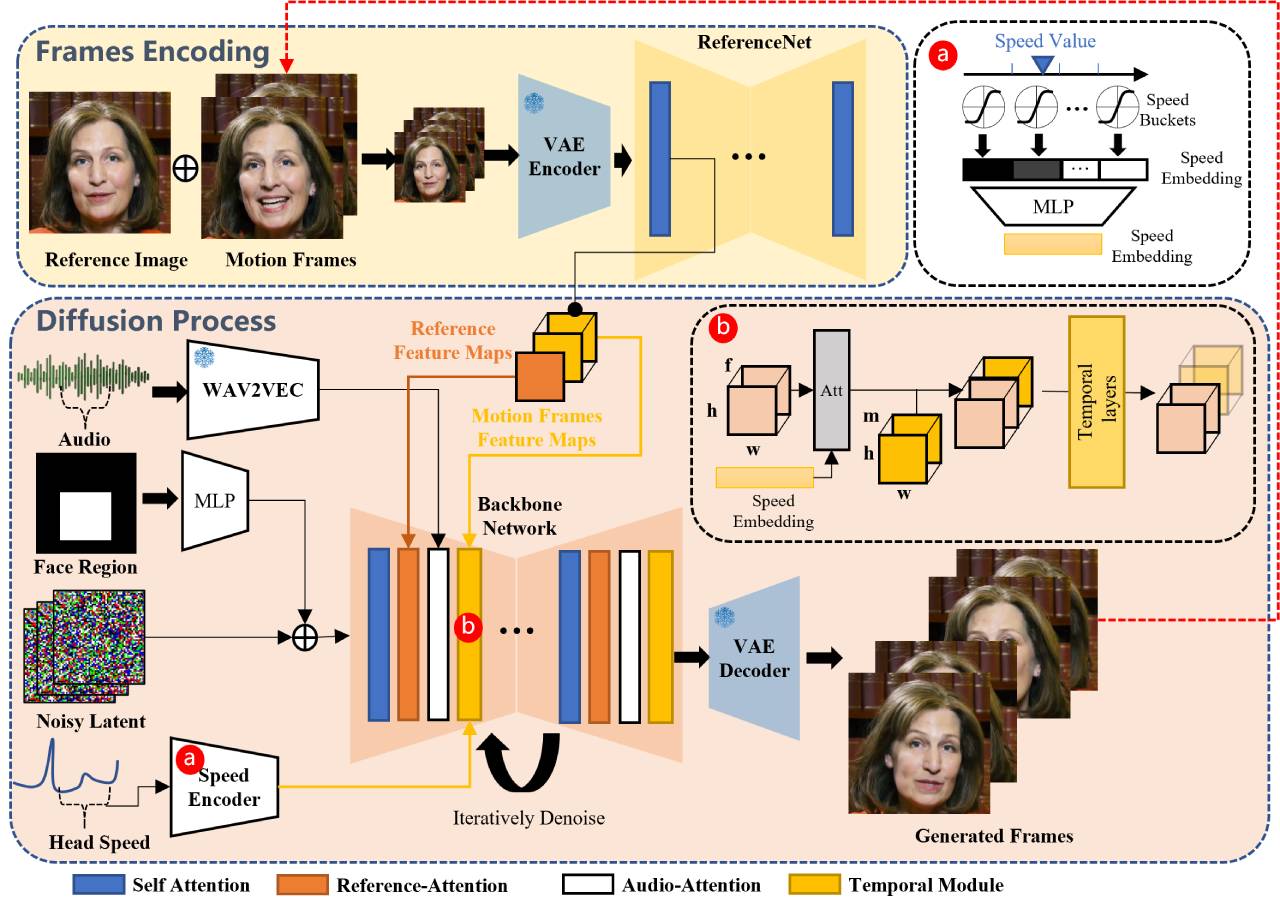
정체성 유지: FrameEncoding 모듈을 통해 EMO는 비디오 생성 과정에서角色 정체성의 일관성을 유지하여角色的 외관이 입력된 참조 이미지와 일치하도록 보장합니다.
안정적인 제어 메커니즘: 속도 컨트롤러와 얼굴 영역 컨트롤러 등 안정적인 제어 메커니즘을 채택하여 비디오 생성 과정의 안정성을 높이고 비디오崩溃 등의 문제를 방지합니다.
유연한 비디오 길이: 입력 오디오의 길이에 따라 임의의 길이의 비디오를 생성할 수 있어 사용자에게 유연한 창작 공간을 제공합니다.
다국어 및 다장르 지원: 훈련 데이터 세트는 중국어와 영어, 사실주의, 애니메이션 및 3D 스타일을 포함한 여러 언어와 장르를 포괄하여 EMO가 다양한 문화 및 예술 스타일에 적응할 수 있도록 합니다.
Emote Portrait Alive 적용 시나리오:
노래 비디오 생성: 인물 사진 한 장과 노래 오디오를 입력하면 EMO는 오디오와 동기화되고 표현력이 풍부한 노래 비디오를 생성할 수 있습니다.
말하기 비디오 생성: 노래에만 국한되지 않고 말하기 오디오도 처리하여 음성과 동기화된 말하기 비디오를 생성할 수 있습니다.
다국어 지원: 여러 언어의 오디오 입력을 지원하여 다양한 언어环境下의 인물 포트레이트 비디오를 생성할 수 있습니다.
장르 횡단 적용: 애니메이션, 3D 모델 등 다양한 스타일의 포트레이트 이미지를 오디오와 결합하여 특정 스타일의 비디오 콘텐츠를 생성할 수 있습니다.
Emote Portrait Alive는 노래 오디오 입력 처리에 국한되지 않고, 다양한 언어의 음성 오디오도 수용할 수 있습니다. 또한 Emote Portrait Alive는 과거의 오래된 사진, 회화, 3D 모델 및 AI로 생성된 콘텐츠를 비디오로 제작하여 사실적인 동작과 현실감을 불어넣어 줄 수 있습니다.














