
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
CosyVoice: 자연스러운 사람 같은 음성
CosyVoice: 자연스러운 사람 같은 음성소개
CosyVoice는 음성 양자화 인코딩을 기반으로 한 음성 생성 대형 모델로, 텍스트 이해와 음성 생성을 깊이 있게 융합하는 새로운 유형의 음성 합성 기술입니다. 음성을 이산적으로 인코딩하고 대형 모델 기술에 기반하여 자연스럽고 매끄러운 음성 생성 경험을 구현합니다. 전통적인 음성 생성 기술과 비교했을 때, CosyVoice는다양한 텍스트 콘텐츠를 정확하게 해석하고 구현하여 마치 실제 사람과 같은 자연스러운 음성으로 변환할 수 있습니다.
3~10초의 원본 오디오만 제공하면 CosyVoice는 음색을 모방하여 생성할 수 있으며, 운율, 감정 등 세부 사항까지 구현하고 크로스 언어 음성 생성도 가능합니다.
CosyVoice 프로젝트 공식 웹사이트:https://www.modelscope.cn/studios/iic/CosyVoice-300M
CosyVoice 소스코드 주소:https://github.com/FunAudioLLM/CosyVoice
CosyVoice API 주소:https://help.aliyun.com/zh/model-studio/developer-reference/cosvoice-large-model-for-speech-synthesis/?spm=a2c4g.11186623.0.0.56f01751Ke29mh
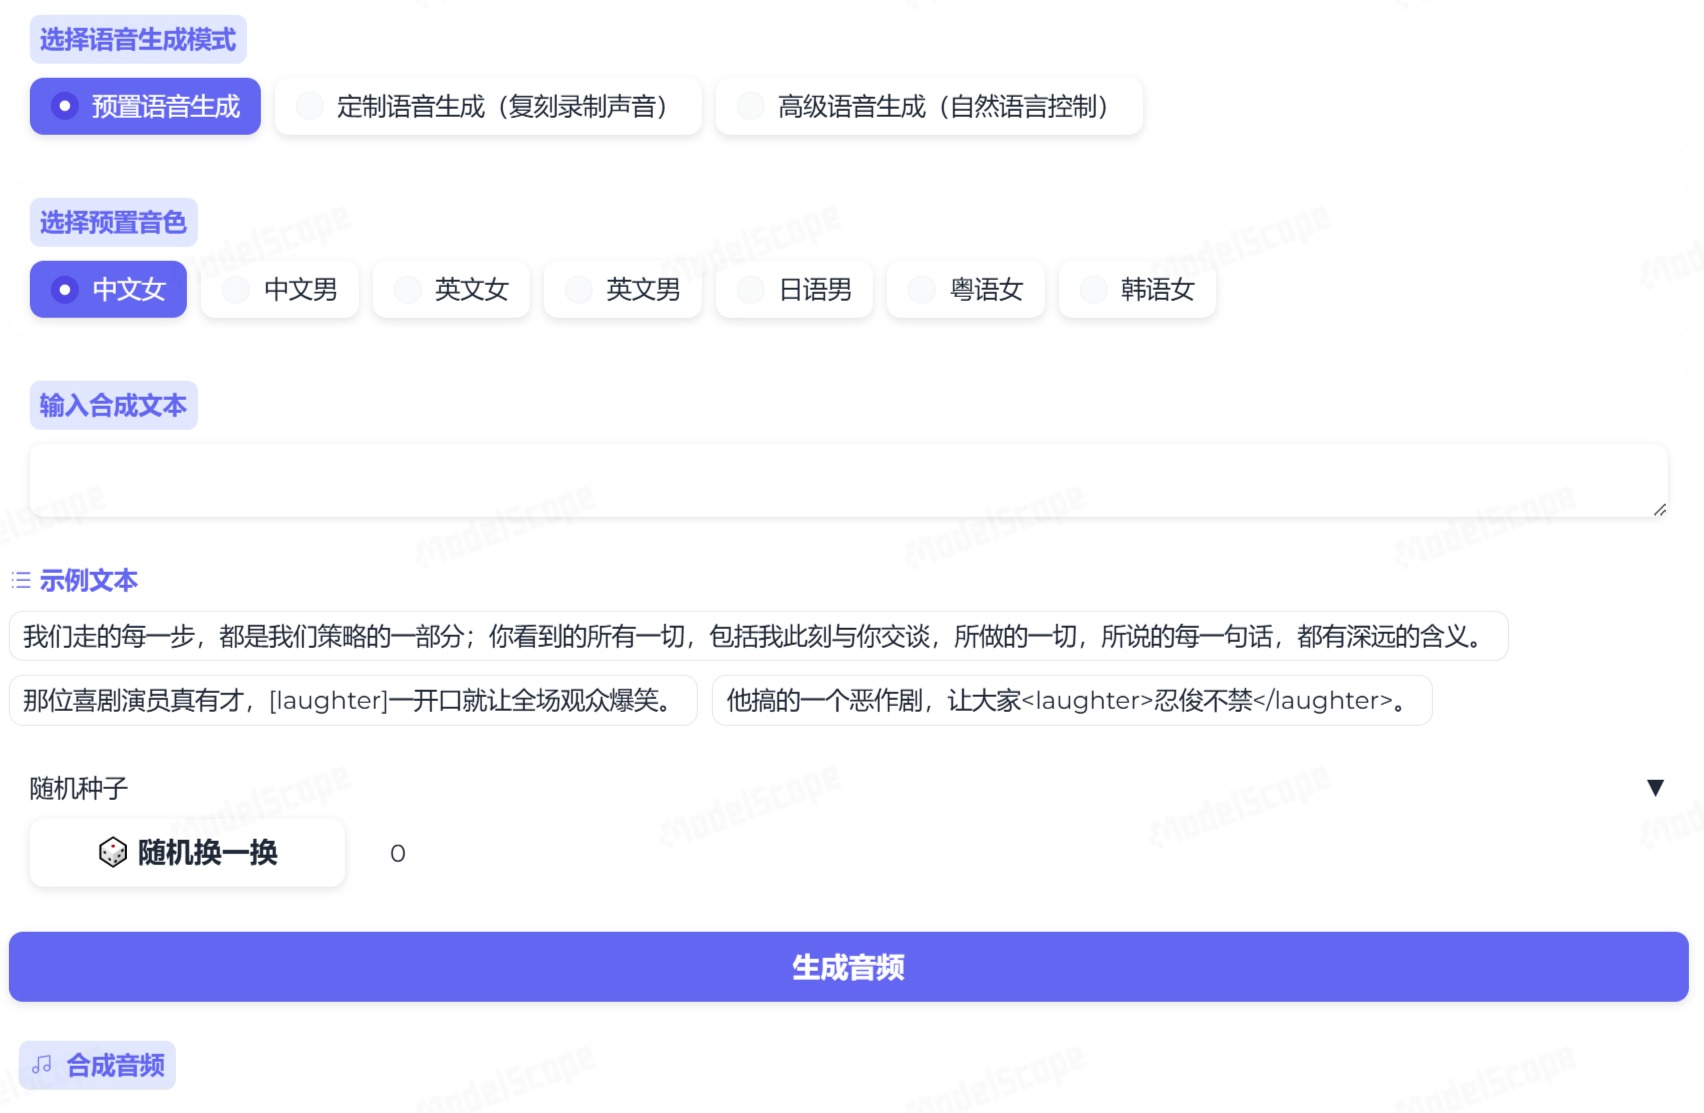
CosyVoice 기능 특징:
고도의 인간 모방: 알리 통의(通义) 음성 랩이 자체 개발한 CosyVoice 생성형 신경망 음성 대형 모델 알고리즘을 채택하여, 생성된 음성이 억양, 운율, 감정 표현 등에서 초인간 모방 수준에 도달합니다.
다국어 지원: CosyVoice는 중국어, 영어, 일본어, 광둥어, 한국어 5개 언어 생성을 지원하며, 자연스러운 음성 생성에 집중하고 다국어, 음색 및 감정 제어를 지원하여 전통적인 음성 생성 모델보다 현저히 뛰어난 효과를 보여줍니다.
다양한 음색 선택: 성별, 연령, 방언 및 다양한 특징적 음성을 포함하여 풍부하고 고품질의 음성 라이브러리 자원을 제공하여, 다양한 시나리오에서 사용자의 개인화된 요구를 충족합니다. 뉴스 방송의 장중하고 엄숙한 톤이든, 이야기讲述의 풍부한 감정이든, 모두 손쉽게 소화할 수 있습니다.
실시간 고효율 합성: 시스템은 뛰어난 응답 속도와 스트리밍 음성 합성 처리 능력을 갖추고 있어, 장문 문서든 짧은 명령문이든 빠르고 정확한 실시간 음성 합성을 구현할 수 있습니다.
감정 및 운율 제어: CosyVoice는 풍부한 언어 음성 이벤트 및 다감정의 고인간 모방 음성 생성을 지원합니다. 예를 들어 웃음, 감정사(语气词) 등, 그리고 다른 감정 표현의 고인간 모방 음성 생성을 지원합니다.
음성 클론: 3~10초의 원본 오디오만 제공하면 CosyVoice는 음색을 모방하여 생성할 수 있으며, 운율, 감정 등 세부 사항까지 구현하고 크로스 언어 음성 생성도 가능합니다.
CosyVoice 활용 분야:
CosyVoice는 스마트 고객 서비스, 오디오북, 차량 내비게이션, 교육辅导 등 다양한 활용 시나리오에 적용됩니다.
스마트 기기/로봇이 방송하는 음성 콘텐츠, 예를 들어 스마트 고객 서비스 로봇, 스마트 스피커, 디지털 휴먼, 음성 비서 등.
음영상 제작에서 텍스트를 음성으로 변환하여 방송해야 하는 시나리오, 예를 들어 소설 낭독, 뉴스 방송, 영상 해설, 대본더빙 등.
CosyVoice는 음성 상호작용의 가능성을 크게 넓혔으며, 사용자 경험을 향상시키는 동시에 기업의 지능화 전환을 위한 강력한 지원을 제공합니다.
최근 큰 인기를 끌고 있는 ChatTTS와 비교하면, CosyVoice의 합성 오디오는 콘텐츠 일관성이 더 높으며, 생성된 음성의 감정과 운율에 대해 세밀한 제어를 수행하여 감정 표현력이 현저히 향상되었고, 환각으로 인한 추가 다자(多字) 현상이 거의 발생하지 않습니다. CosyVoice는 합성 텍스트의 의미 정보를 잘 모델링하여, 콘텐츠 일관성과 화자 유사성 면에서 인간을 초월합니다.














