
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
ToucanTTS: 7,000개 이상의 언어를 지원하는 대규모 다국어 모델
ToucanTTS: 7,000개 이상의 언어를 지원하는 대규모 다국어 모델소개
ToucanTTS는 최첨단 음성 합성을 위한 도구 키트로, 슈투트가르트대학교 자연어처리연구소(IMS)에서 개발한 초완전 텍스트 음성 변환(Text-to-Speech, TTS) 모델입니다. ToucanTTS는 7,000개 이상의 언어를 지원하는 대규모 다국어 모델입니다.
ToucanTTS는 다국어를 지원할 뿐만 아니라 다중 화자 음성 합성 기능도 갖추고 있어, 다양한 화자의 리듬, 강세, 억양을 모방할 수 있습니다.
또한 음성 디자인, 스타일 클로닝, 다국어 음성 합성, 수동 편집 시 낭독 등 다양한 응용 분야의 인터랙티브 데모를 제공하여, 그 다재다능함과 강력한 성능을 보여줍니다.
ToucanTTS 기능:
다국어 지원: ToucanTTS는 7,000개 이상의 언어 음성을 합성할 수 있어, 사용 가능한 가장 다국적인 TTS 모델입니다. 이렇게 폭넓은 언어 지원은 광범위한 국제 사용자에게 호소합니다.
다중 화자 음성 합성: ToucanTTS는 다중 화자 음성 합성을 지원하여, 사용자가 다양한 화자의 리듬, 강세, 억양을 모방할 수 있게 합니다. 스타일 다양성과 음성 맞춤화가 필요한 응용 프로그램에 특히 유용합니다.
인간-기계 협업 편집: ToucanTTS는 사용자가 특정 요구 사항을 충족하도록 합성 음성을 맞춤 설정할 수 있게 하며, 이는 문학 연구와 시 낭독 과제에 특히 유용합니다.
아키텍처: ToucanTTS는 FastSpeech 2 아키텍처를 기반으로 구축되었으며, PortaSpeech에서 영감을 받아 개선되었습니다. 정규화 흐름 기반 PostNet과 연결주의 시간 분류(CTC) 및 스펙트로그램 재구성을 통해 훈련된 독립 정렬기를 포함하여, 고품질의 자연스러운 음성 합성을 실현합니다.
조음 표현: ToucanTTS의 고유한 기능 중 하나는 음소의 조음 표현을 입력으로 사용하는 것입니다. 다국어 데이터를 활용함으로써 저자원 언어의 음성 합성 품질과 가용성을 향상시켰습니다.
인터랙티브 데모: ToucanTTS는 음성 디자인, 스타일 클로닝, 다국어 음성 합성, 수동 편집 시 낭독 등 다양한 응용 분야에 대한 인터랙티브 데모를 제공합니다. 이러한 데모는 이 도구 키트의 다재다능함과 견고성을 보여줍니다.
훈련 및 추론: 이 도구 키트는 의존성 설치, 저장소 구성, 사전 훈련된 모델 다운로드 및 훈련 파이프라인 실행에 대한 포괄적인 지침을 제공합니다. 사전 훈련된 모델에서 미세 조정하는 것과 처음부터 훈련하는 것을 모두 지원합니다.
ToucanTTS 특징:
다국어 및 다중 화자 지원: 대규모 다국어 사전 훈련 모델을 통해 7,000개 이상의 언어를 아우르는 다국어 음성 합성을 지원합니다. 다중 화자 음성 합성을 구현하고 화자 간 리듬, 강세, 억양과 같은 운율적 요소를 복제합니다.
인간-기계 협업 편집: 시 낭송 및 문학 연구 등에 사용되는 합성 음성에 대한 인간-기계 협업 편집을 허용합니다.
인터랙티브 데모: 대규모 다국어 음성 합성, 화자 간 스타일 클로닝, 음성 디자인 및 수동 편집 시 낭송의 인터랙티브 데모를 제공합니다.
아키텍처 및 구성 요소: 주로 FastSpeech 2 아키텍처를 기반으로 하며, PortaSpeech에서 영감을 받은 정규화 흐름 기반 PostNet과 같은 일부 수정 사항이 포함되어 있습니다. CTC로 훈련된 독립 정렬기와 다양한 응용 분야의 스펙트로그램 재구성을 포함합니다. 다국어 모델, 정렬기, 임베딩 함수, 보코더, 임베딩 GAN의 사전 훈련된 모델을 제공합니다.
사용 용이성: 전적으로 Python 및 PyTorch로 구축되었으며, 강력하면서도 초보자에게 적합하도록 설계되었습니다.
조음 표현: IMS Toucan 시스템은 음소의 조음 표현을 입력으로 사용하여 다국어 데이터가 저자원 언어에도 혜택을 줄 수 있게 합니다.
ToucanTTS 응용 분야:
다국어 응용 프로그램의 음성 합성: ToucanTTS는 7,000개 이상의 언어를 지원하여, 글로벌 고객 서비스 플랫폼, 교육 도구, 비원어민 지원 기술 등 다국어 응용 프로그램 제작에 매우 유리합니다.
음성 디자인 및 맞춤화: 다중 화자 음성 합성 기능을 통해 가상 비서, 오디오북, 개인화된 마케팅 메시지 등 다양한 응용 프로그램에 사용 가능한 맞춤 음성을 생성할 수 있습니다.
인간-기계 협업 편집: 이 기능은 특정 문체적 요구 사항을 충족하기 위해 음성 출력에 대한 정밀한 제어가 필요한 문학 연구 및 시 낭독 과제에서 특히 유용합니다.
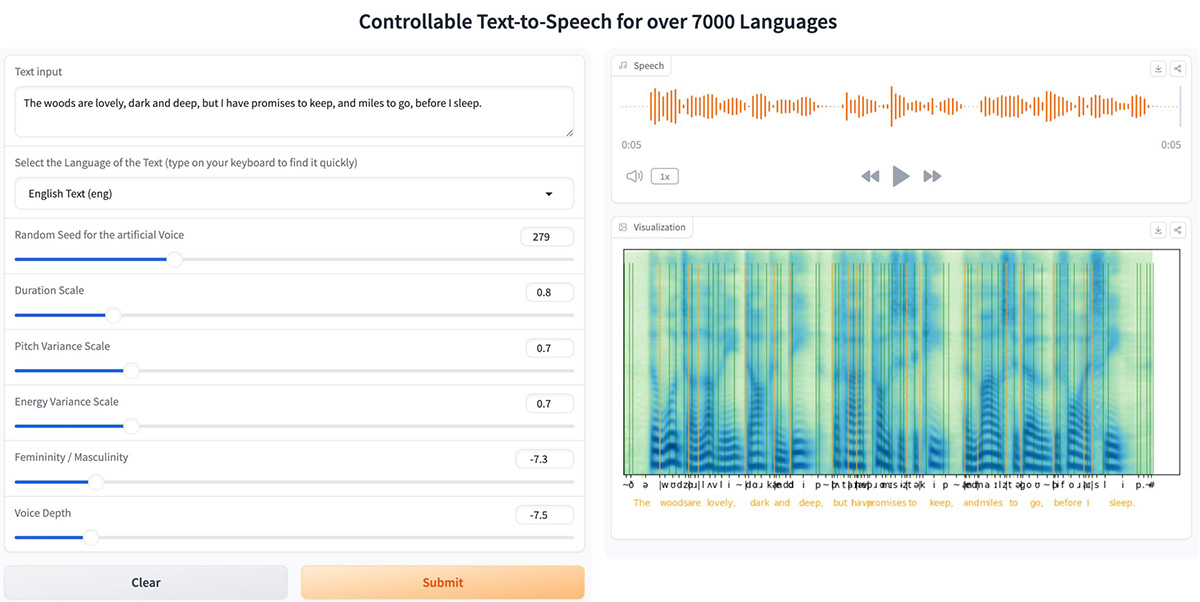
ToucanTTS 사용 방법:
단 몇 가지 간단한 단계만 거치면 ToucanTTS를 시작할 수 있습니다.
1. GitHub에서 다운로드
GitHub에서 코드를 다운로드합니다. git clone https://github.com/2noise/ToucanTTS로 ToucanTTS를 다운로드합니다.
2. 의존성 설치
시작하기 전에 필요한 패키지가 설치되어 있는지 확인하세요. torch와 ToucanTTS가 필요합니다. 아직 설치되지 않은 경우 pip를 사용하여 설치할 수 있습니다.
3. 필요한 라이브러리 가져오기
스크립트에 필요한 라이브러리를 가져옵니다. torch, ToucanTTS, 그리고 IPython.display의 Audio가 필요합니다.
4. ToucanTTS 초기화 및 ToucanTTS 클래스의 인스턴스를 생성하고 사전 훈련된 모델을 로드합니다.
5. 텍스트 준비 및 음성으로 변환할 텍스트를 정의합니다. <YOUR TEXT HERE>를 원하는 텍스트로 바꿉니다.
6. infer 메서드를 사용하여 텍스트에서 음성을 생성합니다. use_decoder=True로 설정하여 디코더를 활성화합니다.
7. 오디오 재생
IPython.display의 Audio 클래스를 사용하여 생성된 오디오를 재생합니다. 샘플링 레이트를 24,000 Hz로 설정하고 자동 재생을 활성화합니다.
8. 스크립트 완료
ToucanTTS의 GitHub 링크: https://github.com/DigitalPhonetics/IMS-Toucan
온라인 데모 링크: https://huggingface.co/spaces/Flux9665/MassivelyMultilingualTTS
데이터셋 링크: https://huggingface.co/datasets/Flux9665/BibleMMS














