
 대본 기획 도우미▸
 AI 앱
 AI 뉴스

VASA-1: 사진을 영상으로 변환하는 기술
VASA-1: 사진을 영상으로 변환하는 기술소개
단일 초상화 사진 + 음성 오디오 = 정밀한 입술 싱크, 사실적인 얼굴 동작, 자연스러운 머리 움직임을 가진 실시간 생성 초현실적인 말하는 얼굴 비디오. VASA-1은 마이크로소프트 아시아 연구원에서 개발한 최첨단 인공지능 기술로, 단 하나의 정적 이미지와 음성 오디오 한 조각을 사실적인 대화 얼굴 애니메이션으로 변환할 수 있습니다. 이 기술은 정밀한 오디오와 입술 동작 동기화 및 풍부한 얼굴 미세 표정과 자연스러운 머리 동작을 포착하여 풍부한 표정과 역동적인 얼굴 표정을 가진 비디오를 생성합니다.
VASA-1은 단일 정적 이미지와 오디오 파일을 결합하여 역동적인 얼굴 표정과 머리 동작을 가진 비디오를 생성할 수 있어, 이미지 속人物(인물)이 마치 "살아 움직이는" 것처럼 만듭니다. 이 기술은 ai로 생성된 인물 이미지뿐만 아니라 실제 사진, 예를 들어 미국 대통령의 모습도 사용하여 움직이고 말하게 할 수 있습니다.
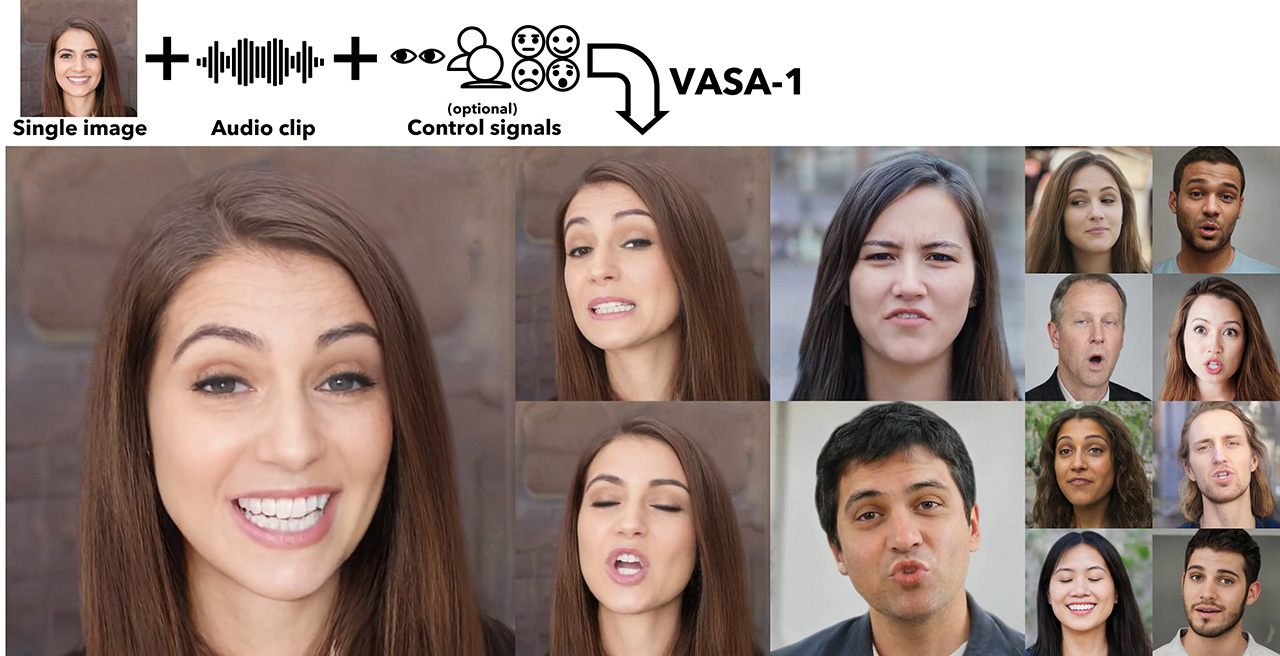
VASA-1 주요 기능 특징:
사실적인 입술 싱크:VASA-1은 입력 음성 오디오와 정확하게 동기화되는 입술 동작을 생성하여 매우 사실적인 말하는 효과를 제공합니다.
디커플링(분리) 능력:VASA-1은 입술 움직임, 표정, 시선 방향 등 얼굴의 역동적인 특징을 독립적으로 제어할 수 있는 능력을 가지고 있습니다.
보안 및 모니터링:VASA-1 기술은 보안 및 모니터링 분야에도 적용될 수 있습니다.
얼굴 잠재 공간 구성:역동적인 얼굴 표정과 머리 동작을 생성하기 위해 얼굴 잠재 공간을 구축합니다.
높은 이미지 생성 품질과 효율적인 실행 속도:VASA-1은 높은 이미지 생성 품질과 효율적인 실행 속도를 갖춘 사실적인 실시간 말하는 얼굴을 구현합니다.
3D 기술을 활용한 얼굴 표정 특징 보조 마킹:마이크로소프트는 또한 3D 기술을 활용하여 얼굴 표정 특징을 보조적으로 마킹하고 추가적인 손실 함수를 설계했으며, 이를 통해 VASA-1은 고품질 얼굴 비디오를 생성할 뿐만 아니라 얼굴 3D 구조를 효과적으로 포착하고 재현할 수 있습니다.
VASA-1 기술은 최첨단 딥러닝 아키텍처와 다양한 첨단 기술의 활용을 통해 입술 싱크, 풍부한 얼굴 표정, 디커플링 능력, 보안 및 모니터링 애플리케이션, 높은 이미지 생성 품질과 효율적인 실행 속도, 효과적인 얼굴 3D 구조 포착 및 재현 등을 포함한 매우 사실적인 오디오 기반 대화 얼굴 애니메이션을 구현합니다.
VASA-1은 정적 이미지 또는 그림과 오디오 파일을 결합하여 최종적으로 사실적인 비디오를 생성하는 혁신적인 AI 도구이며, 이 과정에는 거의 인위적인 흔적이 없어 생성된 비디오가 매우 자연스럽게 보입니다. 연구자들은 다른 모든 모델과 마찬가지로 VASA-1이 현재 헤어와 같은 비강체 요소를 적절하게 처리하지 못한다고 인정했지만, 전체적인 효과는 다른同类(동류) 모델보다 훨씬 우수합니다.
VASA-1의 강력한 능력은 또한 잠재적인 위험을 수반하며, 특히 실제 인물을 사실적으로 모방하여 진위를 분별하기 어려운 딥페이크 비디오를 생성하는 데 악용될 가능성이 있습니다. 마이크로소프트 아시아 연구원은 VASA-1을 공개하기 전에 신중한 입장을 취해왔으며, 기술이 악용되지 않도록 어떠한 온라인 데모, API, 제품 또는 관련 구현 세부 사항도 공개하지 않았으며, 악의적인 행위자가 VASA-1을 부적절한 활동에 이용하는 것을 방지하기 위한 방법을 적극적으로 연구하고 있습니다.











