
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Etna: 텍스트-동영상 AIGC 모델
Etna: 텍스트-동영상 AIGC 모델소개
Etna 모델은 7Volcanoes Technology(七火山科技)에서 개발한 고급 텍스트-투-비디오 모델 소프트웨어로, 자연어 처리, 생성적 적대 신경망 및 컴퓨터 비전 기술 분야에서 깊은 연구와 응용을 진행하고 있습니다.
Etna 모델은 최신 신경망 아키텍처를 채택하여 Transformer 모델의 의미 이해 능력과 Diffusion 모델의 콘텐츠 생성 전략을 교묘하게 융합함으로써 텍스트에서 비디오로의 효율적인 변환을 구현합니다. 이 모델은 길이 8~15초의 비디오 생성을 지원하며, 초당 60프레임에 달하는 매우 뛰어난 비디오 부드러움을 제공합니다.
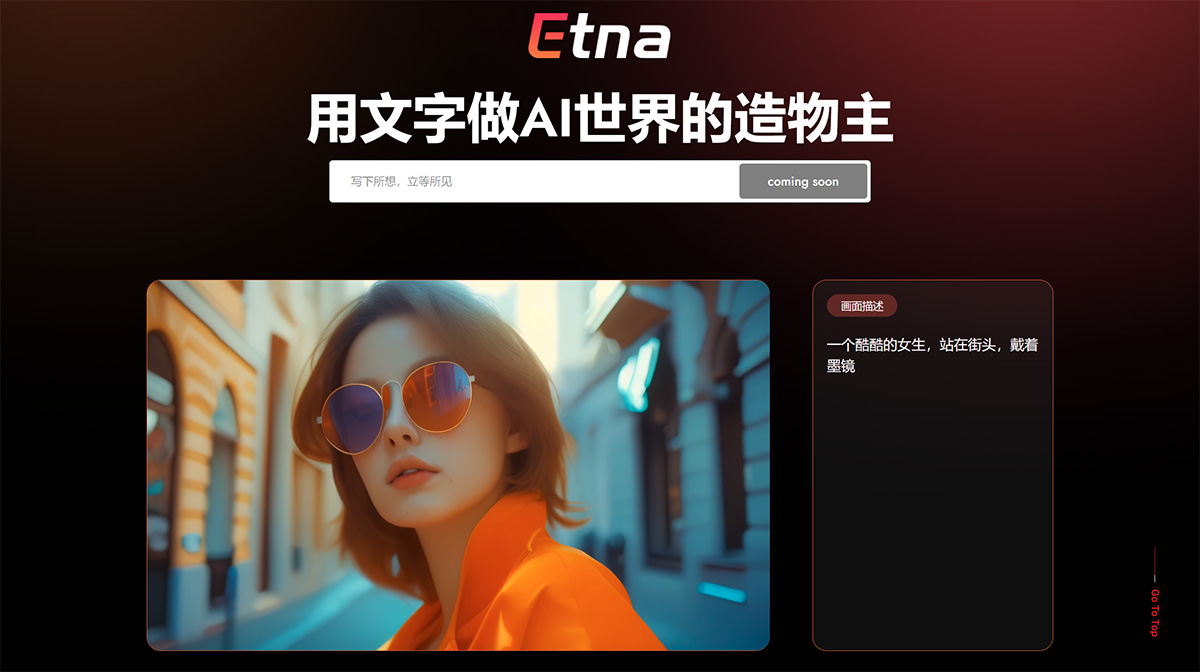
Etna 모델의 기술적 특징:
최신 신경망 아키텍처 사용
Transformer 모델의 의미 이해 능력과 Diffusion 모델의 콘텐츠 생성 전략 융합
텍스트에서 비디오로의 효율적인 변환 지원
Etna 모델의 활용 시나리오:
Etna 모델의 활용 시나리오는 매우 광범위하며, 비디오 콘텐츠 제작, 게임 개발, 예술 및 엔터테인먼트, 교육 및 훈련 분야를 포함하되 이에 국한되지 않습니다.
비디오 콘텐츠 제작: 영화, 애니메이션, 광고 및 소셜 미디어 플랫폼
게임 개발: 인게임 애니메이션 및 장면 생성
예술 및 엔터테인먼트: 독특한 비주얼 아트 작품 창작
교육 및 훈련: 교육용 비디오 제작을 통해 학습兴趣와 효과 향상
이러한 활용 시나리오는 다양한 분야에서 Etna 모델의 광범위한 응용 잠재력과 혁신 능력을 보여줍니다.
Etna 모델 FAQ:
Etna는 무엇을 할 수 있나요?
7Volcanoes Technology(七火山科技)의 Etna 모델은 텍스트-투-비디오 AIGC 모델로, 간략한 텍스트 설명을 기반으로 해당 비디오 콘텐츠를 생성할 수 있습니다.
Etna는 어떤 기술 아키텍처를 채택하나요?
Etna 모델은 현재 메인 백본 네트워크로 Diffusion 아키텍처를 채택하고 있으며, 동시에 더 큰 데이터셋에서 Sora와 유사한 Diffusion+Transformer 아키텍처에 대한 실험 및 적응을 진행하고 있습니다.
Etna의 기술 원리는 무엇인가요?
Etna 모델은 언어 모델과 이미지 모델에 시공간 합성곱 및 어텐션 레이어를 삽입하여 비디오 데이터를 처리할 수 있으며, 즉 이미지 시퀀스 내의 시간적 연속성을 고려합니다. 이는 Etna가 일정 수준의 시공간 이해 능력을 갖추고 있어 시간적 차원을 가진 비디오 콘텐츠를 이해하고 생성할 수 있음을 의미합니다.
Etna는 어떻게 모델을 훈련하나요?
Etna 모델은 대규모 비디오 데이터셋에서 충분한 훈련을 거치며, 이 과정에는 대규모 LDS(Large-Scale Distributed System) 훈련, 복잡한 HPO(하이퍼파라미터 최적화) 및 DPO(Direct Preference Optimization) 미세 조정을 포함한 첨단 딥러닝 기술 전략이採用되어 모델의 강력한 성능과 생성 능력을 보장합니다.
Etna 모델은 7Volcanoes Technology(七火山科技)의 AI 비디오 기술 분야에서 중요한 혁신 성과로서, 최신 신경망 아키텍처와 기술 전략을 결합하여 텍스트에서 고품질 비디오로의 효율적인 변환을 구현했으며, 광범위한 활용 시나리오와 상업적 잠재력을 보여줍니다.












