
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
CogVideo: 텍스트 설명으로 영상 생성
CogVideo: 텍스트 설명으로 영상 생성소개
CogVideo는 현재 가장 큰 범용 분야 텍스트-투-비디오 생성 사전 학습 모델로, 94억 개의 파라미터를 포함하고 있습니다. CogVideo는 사전 학습된 텍스트-이미지 생성 모델(CogView2)을 텍스트-투-비디오 생성 모델에 효과적으로 활용하며, 다중 프레임 레이트 계층적 학습 전략을 사용합니다.
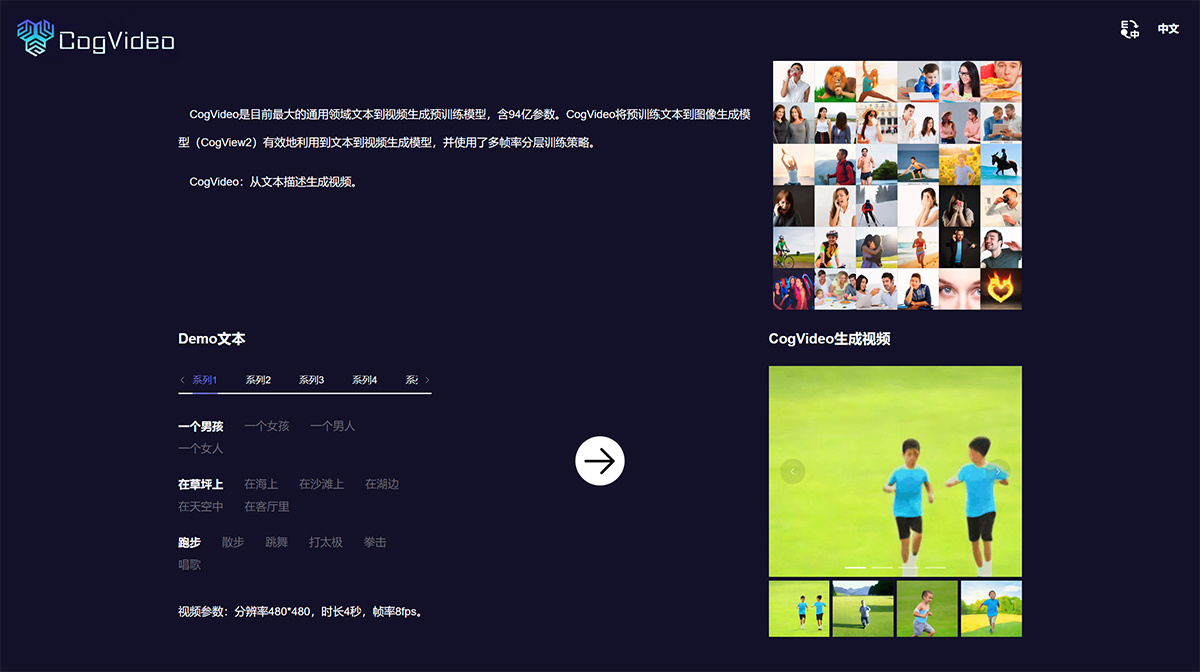
CogVideo는 칭화대학교와 BAai 탕제(Tang Jie) 팀이 제안한 오픈소스 사전 학습 텍스트-비디오 생성 모델로, GitHub에서 광범위한 관심을 받고 있습니다. 이 모델의 핵심 기술은 딥러닝 알고리즘과 모델 아키텍처를 기반으로 하며, 텍스트 설명을 생생하고 사실적인 비디오 콘텐츠로 변환할 수 있습니다.
CogVideo는 다중 프레임 레이트 계층적 학습 전략을 채택하여, 사전 학습된 텍스트-이미지 생성 모델 CogView를 계승함으로써 텍스트에서 비디오로의 효율적인 변환을 실현했습니다. 또한 CogVideo는 고급 동적 장면 구축 기능을 갖추고 있어, 사용자가 제공하는 상세한 텍스트 설명에 따라 3D 환경 및 애니메이션을 생성할 수 있으며, 동시에 텍스트-이미지 사전 학습을 텍스트-비디오 생성에 효율적으로 미세 조정하여 비용이 많이 드는 완전한 사전 학습을 처음부터 다시 수행하는 것을 피합니다.
CogVideo의 학습은 주로 다중 프레임 계층적 생성 프레임워크를 기반으로 하며, 먼저 CogView2를 통해 입력 텍스트로부터 여러 프레임의 이미지를 생성한 다음, 프레임 보간을 통해 프레임 레이트를 높여 전체 비디오 시퀀스를 생성합니다. 이러한 학습 전략은 CogVideo에 생성 과정에서의 변화 강도를 제어할 수 있는 능력을 부여하여, 텍스트와 비디오 의미를 더 잘 정렬하는 데 도움이 됩니다. 이 모델은 94억 개의 파라미터를 사용하며, 현재 가장 큰 범용 분야 텍스트-비디오 생성 사전 학습 모델 중 하나입니다.
CogVideo는 중국어 입력을 지원할 뿐만 아니라, 연구자와 개발자가 사용하고 커스터마이징할 수 있도록 상세한 문서와 튜토리얼을 제공합니다. 오픈소스이며 사용하기 쉬운 특성으로 인해, 멀티모달 비디오 이해 분야에서 중요한 응용 가치를 가지고 있습니다. 또한 CogVideo의 등장은 비디오 생성 분야의 AI 기술이 크게 발전했음을 의미하며, 미래 창작에 획기적인想象 공간(상상 공간)을 제공합니다.
종합적으로, CogVideo는 강력한 텍스트-비디오 생성 모델로서 사전 학습 모델을 효과적으로 활용하여 고품질 비디오를 생성할 수 있습니다. 하지만 비디오 생성 과정에서 텍스트-비디오 데이터셋의 희소성과 약한 상관관계로 인해 복잡한 동작 의미에 대한 모델 이해가 어렵다는 등의 몇 가지 도전 과제에 직면해 있으며, 이는 추가적인 연구와 개선이 필요합니다.















