
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
DiffusionGPT: LLM 기반 텍스트-이미지 생성 시스템
DiffusionGPT: LLM 기반 텍스트-이미지 생성 시스템소개
DiffusionGPT는 바이트댄스(ByteDance)가 개발한 LLM 기반 텍스트-이미지 통합 생성 시스템으로, 다양한 입력 프롬프트에 대해 고품질 이미지를 생성하도록 특화 설계되었습니다. 주요 목표는 입력 프롬프트를 분석하고 최적의 결과를 생성할 수 있는 모델을 결정하는 것이며, 이 모델은 높은 일반화 능력, 높은 효율성, 편리한 사용성을 특징으로 합니다.
DiffusionGPT의 강력한 점은 여러领域的 전문가 이미지 생성 모델을 통합한다는 것입니다(注:原文中的 “领域的专家图像生成模型” 在韩语中调整为更自然的表达 “여러 분야의 전문 이미지 생성 모델을 통합”). 그런 다음 LLM을 사용하여 이러한 이미지 생성 모델들을 연결하고, LLM이 다양한 텍스트 프롬프트를 처리하고 이해하도록 합니다. 마지막으로 이해한 정보를 바탕으로 가장 적합한 이미지 모델을 선택하여 이미지를 생성합니다. 이렇게 하면 GPT-4처럼 채팅을 통해 그림을 그릴 수 있습니다...
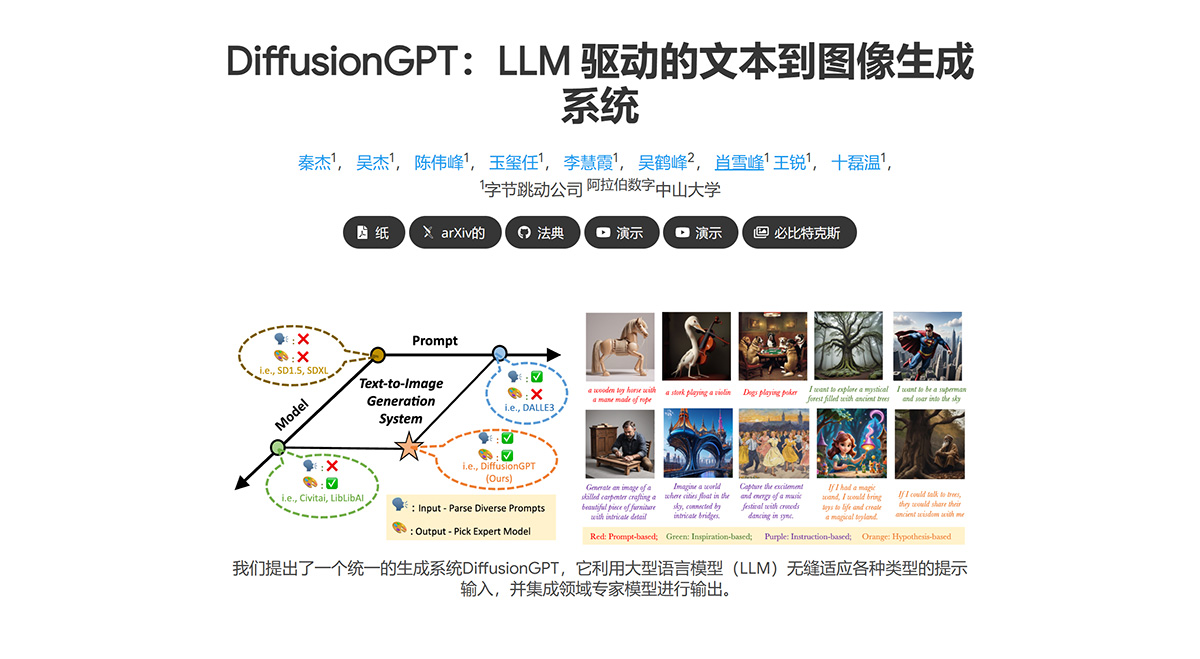
DiffusionGPT의 주요 특징:
1. 다양한 텍스트 프롬프트 처리: DiffusionGPT는 구체적인 지시, 추상적인 영감, 복잡한 가정 등 다양한 유형의 텍스트 프롬프트를 이해하고 처리할 수 있습니다.
2. 여러 분야 전문가 모델 통합: 이 시스템은 다양한 분야의 이미지 확산 모델을 통합하며, 각 모델은 특정 분야에서 전문적인 이미지 생성 능력을 보유하고 있습니다. 이러한 모델들은 자연 경관, 인물 초상화, 예술 작품 등 특정 분야 이미지 생성에 집중합니다.
이는 시스템이 일반적인 이미지를 생성할 수 있을 뿐만 아니라, 특정 스타일이나 유형의 이미지와 같이 더 구체적이고 복잡한 이미지 생성 작업도 처리할 수 있음을 의미합니다. 예를 들어 특정 예술가의 스타일, 만화 스타일 또는 사진 기법을 모방할 수 있습니다.
3. 대규모 언어 모델 기반 구동: DiffusionGPT는 대규모 언어 모델(LLM)을 사용하여 사용자가 입력한 텍스트 프롬프트를 분석하고 이해합니다. 이 과정은 다른 LLM 기반 시스템(예: GPT-4)이 텍스트를 처리하는 방식과 유사하지만, 이미지 생성에 사용되는 지시와 설명을 이해하는 데 특별히 적용됩니다.
4. 적합한 이미지 모델의 지능적 선택: 텍스트 프롬프트에 대한 이해를 바탕으로, DiffusionGPT는 이미지 생성에 가장 적합한 모델을 지능적으로 선택할 수 있습니다. 여기에는 올바른 모델을 선택하는 것뿐만 아니라 사용자의 요구를 가장 잘 충족하도록 생성 매개변수를 조정하는 것도 포함됩니다.
5. 고품질 이미지 출력: 텍스트 프롬프트와 최적 생성 모델을 정확하게 매칭함으로써, DiffusionGPT는 사용자의 요구와高度 일치하는 고품질 이미지를 생성할 수 있습니다(注:原文中的 “高度吻合” 在韩语语境下保留原意,采用 “고도로 부합” 或类似表述).
6. 사용자 피드백 및 장점 데이터베이스: 사용자 피드백 및 장점 데이터베이스를 결합하여, 시스템은 사용자 선호도에 따라 모델 선택을 조정하고 이미지 생성의 관련성과 품질을 향상시킬 수 있습니다.
예시: 시스템 초기 사용 단계에서 사용자는 생성된 이미지에 대해 “이 이미지의 색상이 너무 어둡다”와 같은 피드백을 제공할 수 있습니다. DiffusionGPT는 이러한 피드백을 활용하여 모델 선택을 조정함으로써 향후 이미지 생성이 사용자의 선호도에 더 잘 부합하도록 합니다.
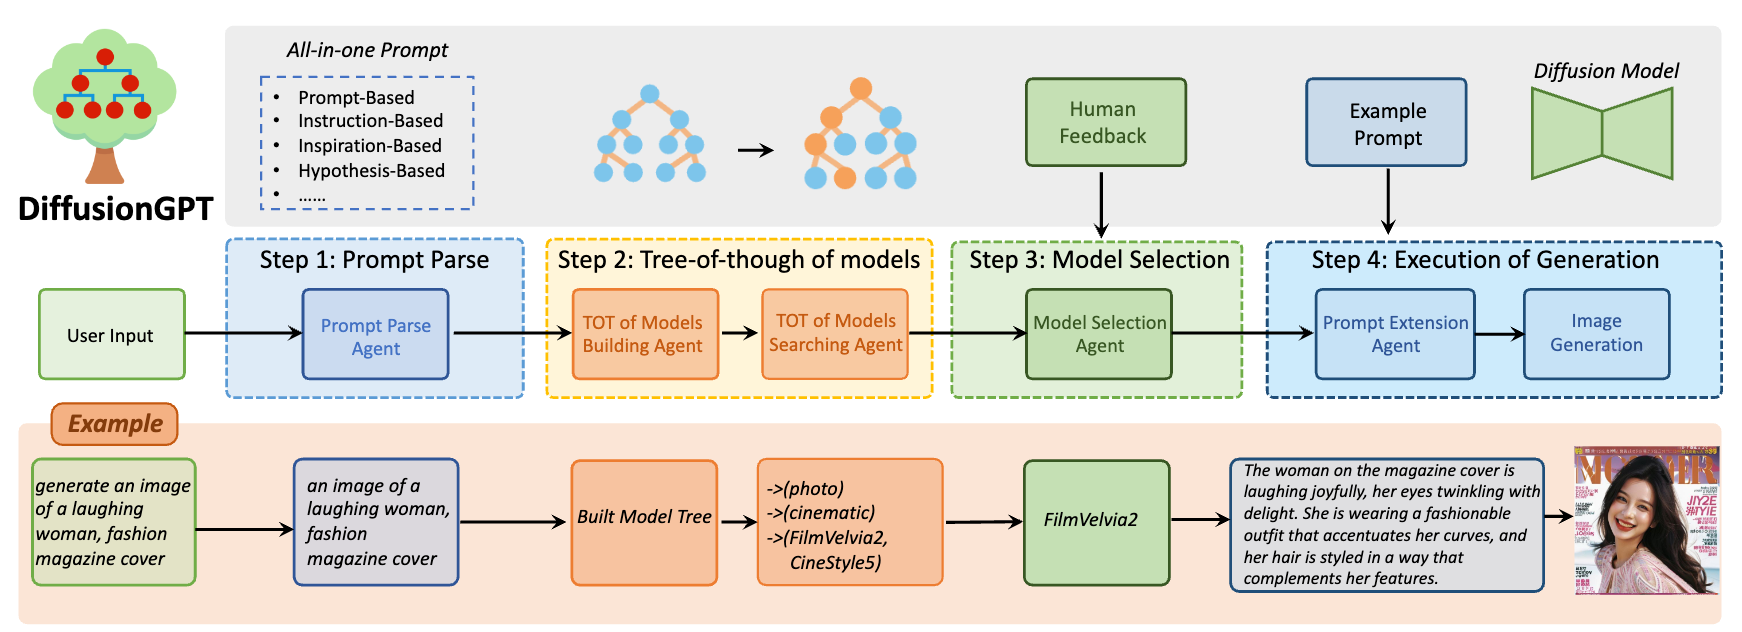
DiffusionGPT의 주요 작동 원리:
1. 입력 분석: 사용자가 설명, 지시 또는 영감과 같은 텍스트 프롬프트를 제공합니다.
대규모 언어 모델(LLM)은 이러한 텍스트 프롬프트를 분석하여 그 의미와 요구 사항을 이해하는 역할을 담당합니다.
2. 사고 트리(Tree-of-Thought) 구축: 서로 다른 이미지 생성 작업에 따라, 시스템은 여러 이미지 생성 모델을 구성하는 구조인 “사고 트리”를 구축합니다.
사고 트리는 사전 지식과 사용자 피드백을 기반으로 하며, 여러 분야의 전문가 수준 모델을 포괄합니다.
3. 모델 선택: LLM 분석 결과에 따라, 시스템은 사고 트리를 통해 현재 텍스트 프롬프트에 가장 적합한 이미지 생성 모델을 결정합니다. 선택 과정에서 장점 데이터베이스에 저장된 사용자의 선호도와 과거 피드백도 고려될 수 있습니다.
4. 이미지 생성: 적합한 모델이 선택되면, 해당 모델은 이미지 생성에 사용됩니다. 생성된 이미지는 입력된 텍스트 프롬프트와 밀접하게 관련되며 사용자의 의도와 선호도를 반영합니다.
5. 결과 출력: 최종 생성된 이미지는 사용자에게 제시됩니다.
이러한 이미지는 구체적으로 묘사된 장면, 컨셉 아트 작품 또는 특정 스타일에 부합하는 이미지를 포함하되 이에 국한되지 않고 다양합니다.
6. 사용자 피드백 최적화 과정:
생성된 이미지에 대한 사용자 피드백은 장점 데이터베이스를 풍부하게 하는 데 사용되며, 이를 통해 시스템이 사용자 선호도를 더 잘 이해하고 후속 모델 선택 및 이미지 생성을 최적화합니다.
DiffusionGPT는 인간과 장면 등 범주의 이미지를 생성할 때 높은 사실감과 디테일을 보여줍니다.기준 모델(예: SD1.5)과 비교했을 때, DiffusionGPT가 생성한 이미지는 시각적 충실도와 디테일 포착 측면에서 현저한 향상을 보입니다.DiffusionGPT는 이미지 보상 및 미학 점수 측면에서 전통적인 Stable Diffusion 모델보다 우수한 성능을 보입니다.이미지 생성 품질의 정량적 평가를 수행할 때, DiffusionGPT는 높은 점수를 보여주며, 이는 생성된 이미지가 품질과 미학적으로 더 선호됨을 의미합니다.














