
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Audio2Photoreal: 오디오로 사실적인 가상 인물 생성
Audio2Photoreal: 오디오로 사실적인 가상 인물 생성소개
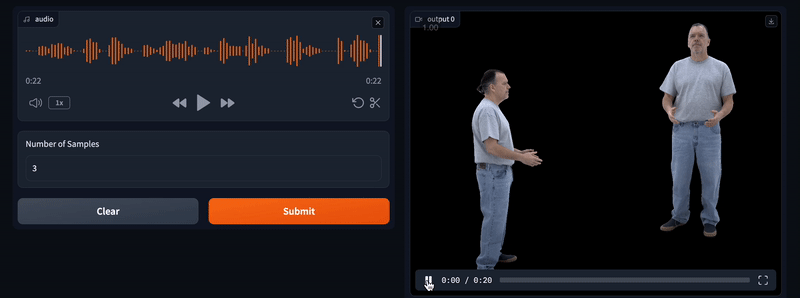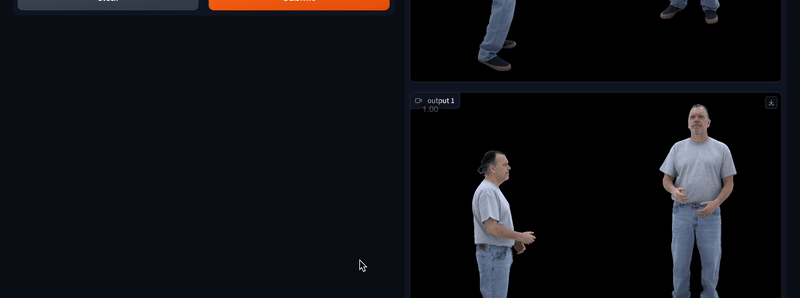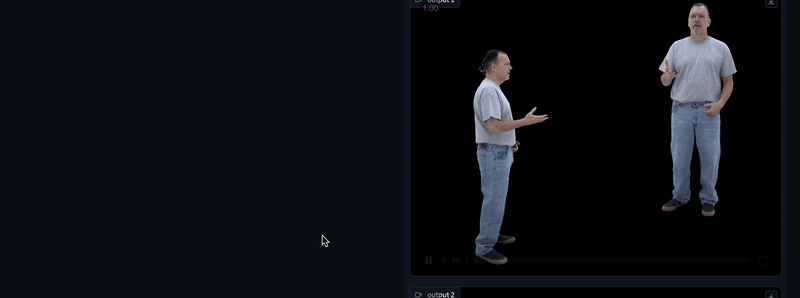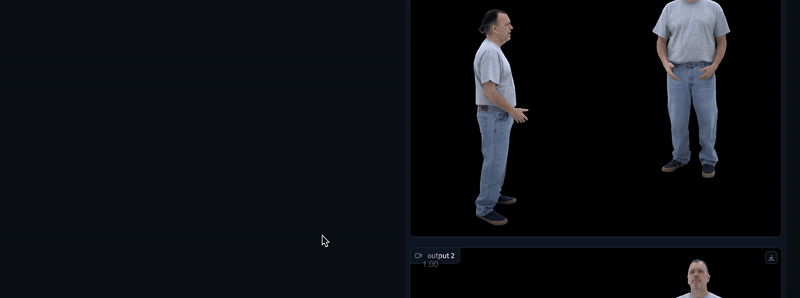
Meta ai가 최근에 엄청난 기술을 발표했습니다: Audio2PhotoReal, 오디오로부터全身(realistic) 가상 인물 이미지를 생성하는 기술입니다. 이 기술은 여러 사람이 진행하는 대화의 음성으로부터 해당 대화에 맞는 사실적인 표정, 완전한 신체 동작, 제스처를 생성할 수 있습니다.
이렇게 생성된 가상 인물은 시각적으로 매우 사실적일 뿐만 아니라, 가리키기, 손목 떨림, 어깨를 으쓱하기, 미소 짓기, 비웃기 등 대화 속의 제스처와 표정 디테일까지 정확하게 반영할 수 있습니다.
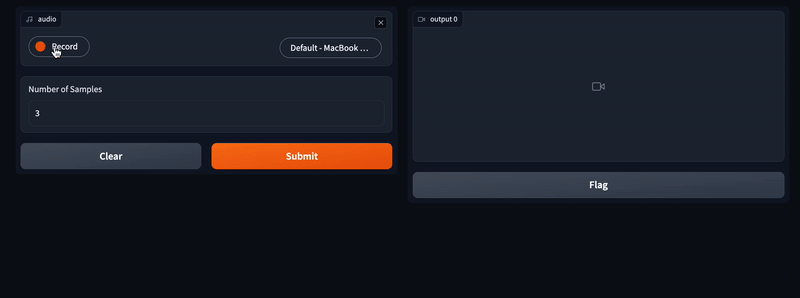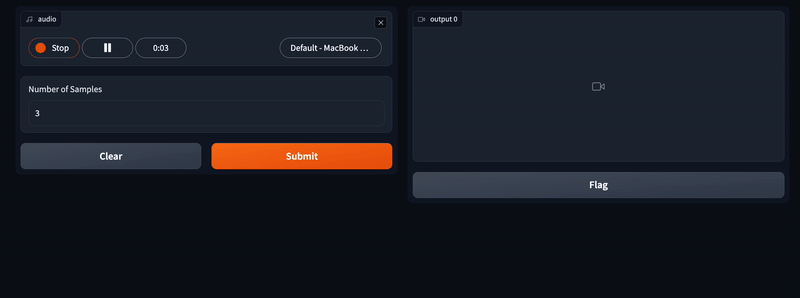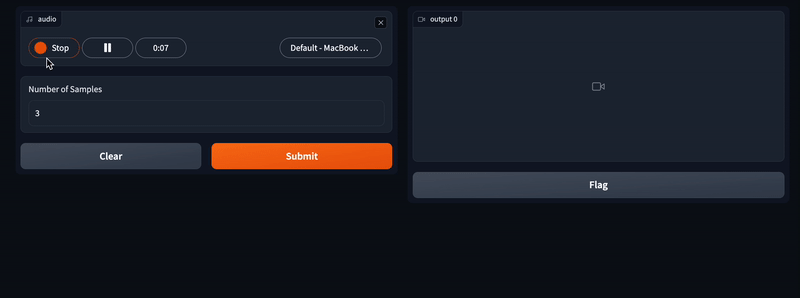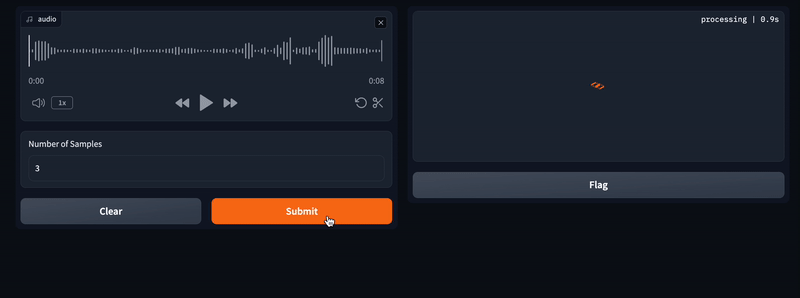
Audio2PhotoReal 작동 원리:
Audio2PhotoReal은 벡터 양자화의 샘플 다양성과 확산(diffusion)을 통해 얻은 고주파 디테일의 장점을 결합하여 보다 동적이고 표현력이 풍부한 동작을 생성합니다.
1. 데이터셋 캡처: 먼저 사실적인 재구성을 가능하게 하는 풍부한 1대1 대화 데이터셋을 캡처합니다.
2. 동작 모델 구축: 프로젝트는 얼굴 동작 모델, 가이드 포즈 예측기, 신체 동작 모델을 포함하는 복합 동작 모델을 구축합니다.
3. 얼굴 동작 생성: 사전 학습된 입술 회귀 모델(regressor)을 사용하여 오디오를 처리하고, 얼굴 동작과 관련된 특징을 추출합니다.
조건부 확산 모델(conditional diffusion model)을 활용하여 이러한 특징으로부터 얼굴 동작을 생성합니다.
4. 신체 동작 생성: 오디오를 입력으로 하여 초당 1프레임의 벡터 양자화(VQ) 가이드 포즈를 자기회귀적으로 출력합니다. 오디오와 가이드 포즈를 함께 확산 모델에 입력하여 초당 30프레임 속도로 고주파 신체 동작을 생성합니다.
5. 가상 인물 렌더링: 생성된 얼굴과 신체 동작을 학습된 가상 인물 렌더러에 전달하여 사실적인 가상 인물을 생성합니다.
6. 결과展示: 최종적으로 오디오로부터 생성된 전신 사실적 가상 인물이展示되며, 이 가상 인물은 대화 속의 미묘한 표정과 제스처 동작을 표현할 수 있습니다.
Audio2Photoreal 프로젝트 주소:https://github.com/facebookresearch/audio2photoreal/
Audio2Photoreal 논문 주소:https://arxiv.org/pdf/2401.01885.pdf














