
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
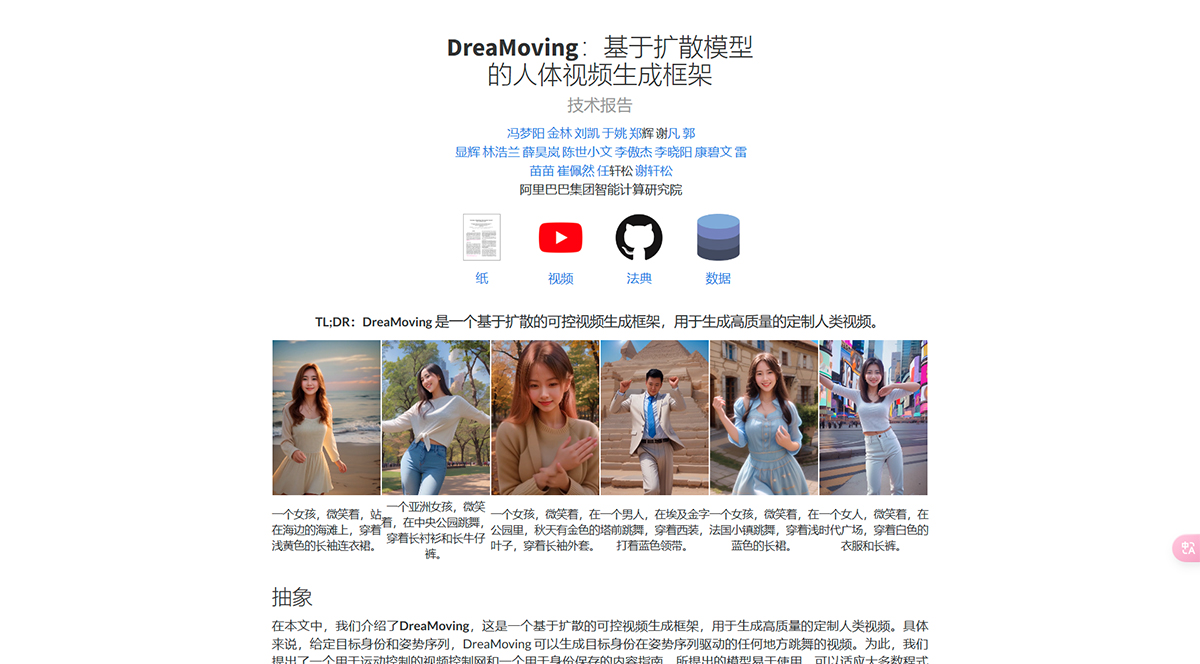
DreaMoving: 확산 모델 기반 휴먼 비디오 생성 프레임워크
DreaMoving: 확산 모델 기반 휴먼 비디오 생성 프레임워크소개
DreaMoving은 확산 기반의 제어 가능한 비디오 생성 프레임워크로, 고품질의 맞춤형 인간 댄스 비디오를 생성하는 데 사용됩니다. 구체적으로, 목표 정체성과 포즈 시퀀스가 주어지면 DreaMoving은 포즈 시퀀스에 의해 구동되는 목표 정체성이 어디에서든 춤을 추는 비디오를 생성할 수 있습니다. 이를 위해 우리는 모션 제어를 위한 비디오 제어 네트워크와 정체성 보존을 위한 콘텐츠 가이더를 제안합니다. 제안된 모델은 사용하기 쉬우며, 다양한 결과를 생성하기 위해 대부분의 스타일화된 확산 모델에 적용될 수 있습니다.
DreaMoving 프로젝트 주소:https://dreamoving.github.io/dreamoving
DreaMoving 개요:
Video ControlNet은 각 U-Net 블록 이후에 모션 블록을 주입하는 이미지 ControlNet입니다. Video ControlNet은 제어 시퀀스(포즈 또는 깊이)를 추가적인 시간적 잔차로 처리합니다. Denoising U-Net은 비디오 생성을 위한 모션 블록이 있는 파생된 Stable-Diffusion U-Net입니다. 콘텐츠 가이더는 교차 주의를 위해 입력 텍스트 프롬프트와 외관 표현(예: 얼굴(의상은 선택사항))을 콘텐츠 임베딩으로 전달합니다.
결과:
DreaMoving은 가이드 시퀀스와 간단한 콘텐츠 설명(예: 입력으로 텍스트 및 참조 이미지)이 주어지면 고품질이고 고충실도의 비디오를 생성할 수 있습니다. 구체적으로, DreaMoving은 얼굴 참조 이미지를 통한 정체성 제어, 포즈 시퀀스를 통한 정확한 모션 조작, 그리고 지정된 텍스트 프롬프트에 의해 유도되는 포괄적인 비디오 외관 제어를 보여줍니다.














