
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Qwen-Image: Alibaba Tongyi Qianwen 팀의 오픈소스 이미지·포스터 생성 모델
小编 ·

Qwen-Image: Alibaba Tongyi Qianwen 팀의 오픈소스 이미지·포스터 생성 모델
Qwen-Image는 알리 통의천문(Tongyi Qianwen) 팀이 2025년 8월 5일에 오픈소스로 공개한 이미지 생성 기초 모델로, 파라미터 규모가 200억이며 MMDiT 아키텍처를 채택하고 있습니다. 복잡한 텍스트 렌더링과 정밀한 이미지 편집에서 뛰어난 성능을 보이며, 특히 정확하고 정교한 중국어 대량 생성에 능숙하고 중국어 프롬프트도 지원하여, LongText-Bench, ChineseWord 등 중국어 특화 테스트에서 다수의 모델을 선도하고 있습니다.
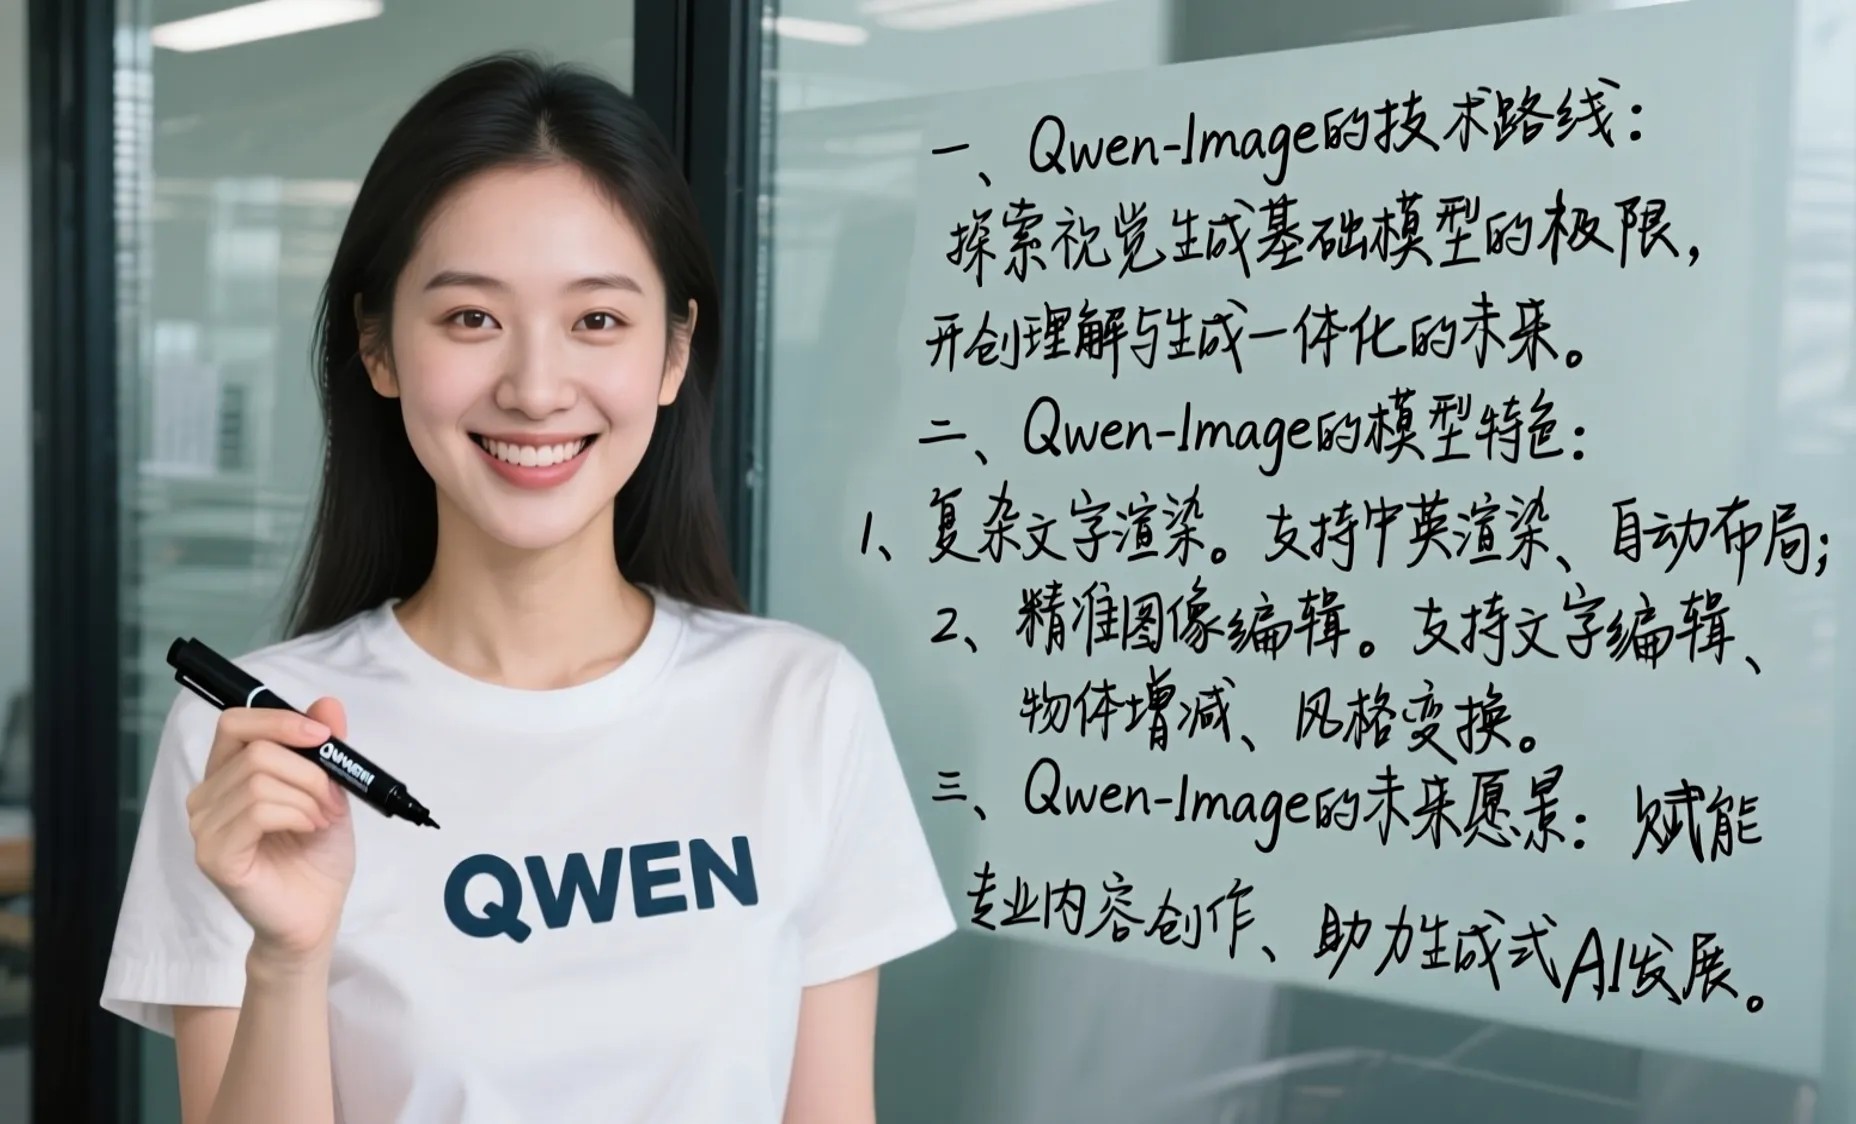
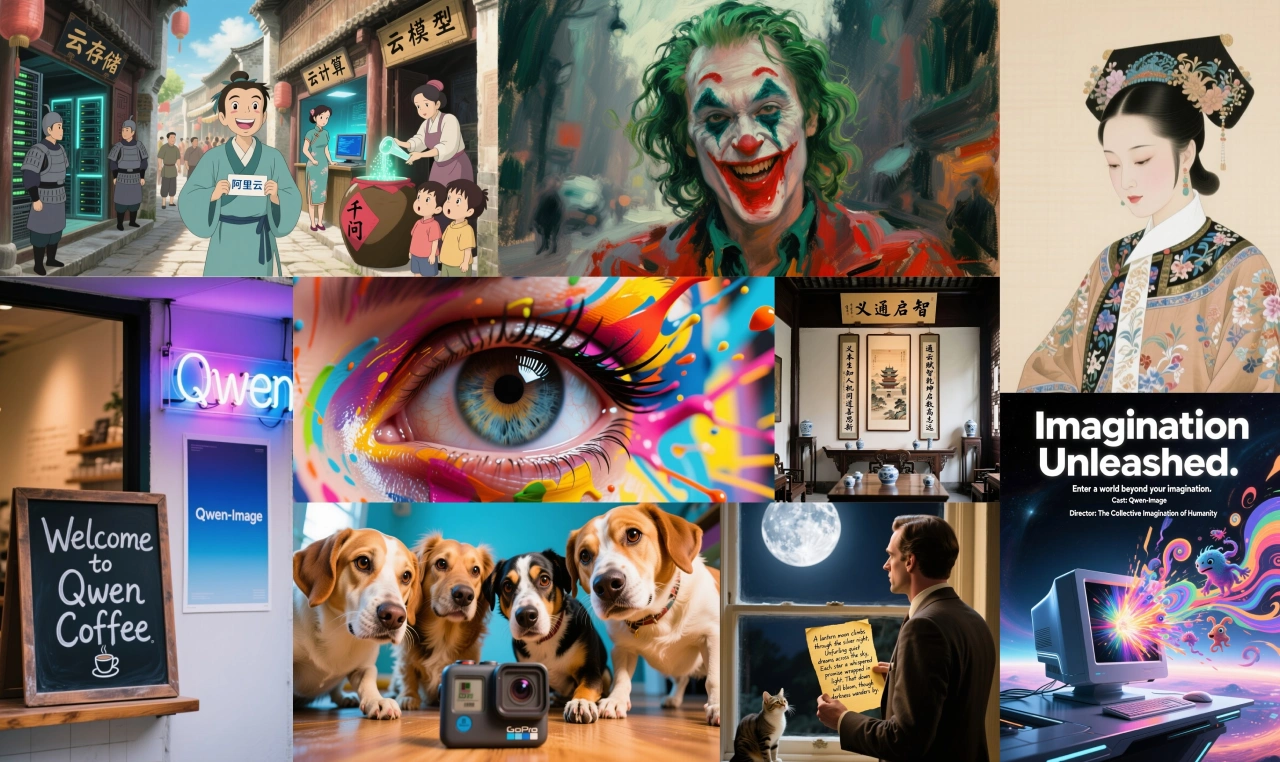
이 모델은 중국어와 영어를 모두 지원하며, 다양한 폰트, 초장문 단락, 복잡한 이미지와 텍스트 레이아웃을 처리할 수 있고, 포스터, ppt 등 다양한 장면의 이미지를 생성할 수 있을 뿐만 아니라 스타일 전이, 물체 추가 및 삭제, 자세 조정 등 이미지 편집도 가능합니다. 광고 디자인, 영상 제작, 게임 개발, 교육 훈련 등 여러 산업에 활용될 수 있습니다. 사용자는 QwenChat(chat.qwen.ai)에서 이미지 생성 기능을 선택하여 체험할 수 있으며, 포스터, PPT 페이지, 상품 홍보 이미지 등을 생성할 수도 있고, 이미지에 대해 다양한 편집을 수행할 수도 있어 디자이너에게 강력한 도구를 제공합니다.
주요 특징
텍스트 렌더링 능력이 뛰어남: 다중 행 레이아웃, 단락 수준 텍스트 생성 및 디테일 표현을 지원하며, 중국어와 영어 모두 고충실도로 출력됩니다. LongText-Bench, ChineseWord, TextCraft 등 테스트에서 뛰어난 성능을 보이며, 중국어 텍스트 렌더링은 기존 최첨단 모델보다 훨씬 우수합니다. 다양한 언어와 스타일의 문자를 생성할 수 있고, 붓글씨를 쓰거나 텍스트와 이미지가 포함된 PPT 페이지를 바로 생성할 수도 있습니다.
이미지 편집 일관성이 우수함: 강화된 다중 작업 훈련을 통해 편집 시 시각적 및 의미적连贯성을 유지할 수 있으며, 스타일 전이, 추가/삭제/수정, 디테일 강화, 텍스트 편집, 인물 자세 조정 등 작업을 지원합니다.
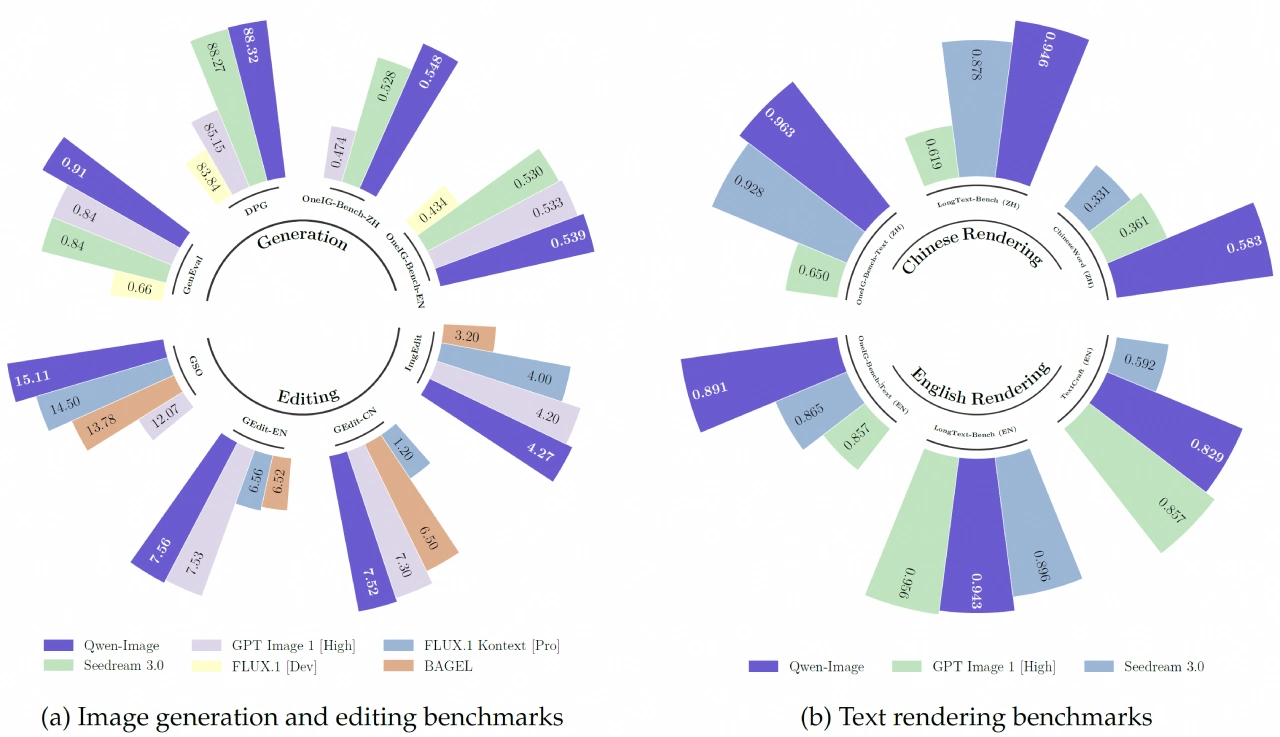
크로스 벤치마크 성능이 우수함: 범용 이미지 생성의 GenEval, DPG, OneIG-Bench, 그리고 이미지 편집의 GEdit, ImgEdit, GSO 등 여러 공개 테스트에서 최상의 성능을 달성했습니다.
핵심 구성 요소
Qwen2.5-VL 다중 모달 대규모 언어 모델: 조건부 인코더로서 텍스트에서 특징을 추출하고, 시스템 프롬프트에 따라 물체와 배경의 색상, 수량, 문자 등을 자세히 묘사하여 이미지 생성의 근거를 제공하고, 생성된 콘텐츠를 더精细하게 만듭니다.
Wan-2.1 비디오 생성 모델의 분산 오토인코더(VAE): 이미지 토크나이저와 같은 역할을 하며, 입력 이미지를 압축된 잠재 표현으로 만들고 추론 시 다시 디코딩하여 복원합니다. 팀은 인코더를 동결하고 디코더만 미세 조정하여 이미지 디테일을 더突出시켰습니다.
다중 모달 확산 Transformer(MMDiT): 백본 확산 모델로서, 텍스트 가이드 하에 노이즈와 이미지 잠재 표현의 관계를 처리하며, 다중 모달 확장 가능 RoPE 방법을 도입하여 이미지와 텍스트 정보를 구별하는 데 도움을 주며, 고해상도 이미지를 생성할 수 있을 뿐만 아니라 문자도 정확하게 생성할 수 있습니다.
Qwen-Image 기술 아키텍처
MMDiT 아키텍처: 다중 모달 확산 트랜스포머를 사용하여 텍스트와 이미지의 심층 융합을 실현합니다.
단일 인코더-이중 디코더 VAE: 이미지를 압축된 잠재 표현으로 압축하고, 생성 후 다시 픽셀로 디코딩하는 역할을 합니다. 재건 손실과 지각 손실의 균형을 조정함으로써 이미지 디테일을 충실하게 복원할 수 있습니다.
다중 모달 확장 가능 회전 위치 인코딩(MSRoPE): 텍스트 정보를 이미지 그리드의 "대각선"에 인코딩하여, 텍스트의 독립성을 유지하면서 이미지 해상도 확장의 장점을 활용할 수 있게 합니다.
훈련 전략
다단계, 점진적 사전 훈련을 채택함: 저해상도에서 고해상도로, 범용 콘텐츠에서 전문 콘텐츠로, 대규모 데이터에서 정제된 데이터로 점진적으로 훈련합니다.
훈련 후반부에 지도 미세 조정(SFT)과 강화 학습(RL)을 사용함: 인공적으로 선별된 고품질 데이터로 미세 조정하며, DPO 등의 기술을 통해 모델이 인간의 선호도를 학습하도록 합니다.
활용 시나리오
광고 디자인: 브랜드 스타일에 따라 고품질 이미지를 빠르게 생성하며, 스타일 변환과 디테일 최적화를 지원하여 디자이너가 다양한 효과를 빠르게 시도하여 고객 요구를 충족시키는 데 도움을 줍니다.
영상 제작: 사전 컨셉 아트, 장면 프리비주얼 및 캐릭터 디자인에 사용되어 제작 주기를 단축하고 비용을 절감합니다.
이커머스 비주얼: 판매자가 제품 전시 이미지, 가상 피팅 이미지 및 마케팅 자료를 빠르게 생성하여 사용자 경험과 구매율을 높일 수 있습니다.
포스터 제작: 텍스트와 디자인 요구 사항에 따라 임팩트 있고 예술적인 포스터(예: 영화, 행사 포스터)를 생성하며, 다양한 스타일과 주제에适配됩니다.
PPT 제작: 기업급 PPT 페이지를 생성하며, 스타라이트 블루 주조색을 채택하고, 흐르는 테크 라인 및 미세한 빛 입자 효과를搭配하여, 화면이 전문적이고 현대적이며, 다양한 스타일과 레이아웃을 지원합니다.
성능表现
범용 이미지 생성: GenEval, DPG, OneIG-Bench 등 테스트에서 우수한 성능을 보입니다.
이미지 편집: GEdit, ImgEdit, GSO 등 전문 테스트에서 최고의 성능을 보입니다.
텍스트 렌더링: LongText-Bench, ChineseWord, TextCraft 등 테스트에서 뛰어난 능력을 보이며, 특히 중국어 텍스트 렌더링은 기존 최첨단 모델을 훨씬 능가합니다.
Qwen-Image 장점
중국어 지원이 더 뛰어남: 중국어를 특별히 최적화하여 렌더링 효과가 DALL-E보다 훨씬 우수합니다.
완전 무료: 유료 구독이 필요 없으며, 로컬 배포도 가능합니다.
오픈소스 투명성: 코드가 공개되어 사용자 정의 수정이 가능합니다.
더 강력한 편집 기능: 더 다양한 이미지 편집 작업을 지원합니다.
사용 제한 없음: API 호출 횟수 제한을 받지 않습니다.
Qwen-Image 사용 방법
환경 준비: 최신 버전의 diffusers를 설치합니다.
기초 코드:
from diffusers import DiffusionPipeline
import torch
model_name = "Qwen/Qwen-Image"
if torch.cuda.is_available():
    torch_dtype = torch.bfloat16
    device = "cuda"
else:
    torch_dtype = torch.float32
    device = "cpu"
pipe = DiffusionPipeline.from_pretrained(model_name, torch_dtype=torch_dtype)
pipe = pipe.to(device)
prompt = '''一个穿着"QWEN"标志T恤的中国美女正拿着黑色马克笔面向镜头微笑。她身后的玻璃板上手写体写着"欢迎使用Qwen-Image,一款强大的图像基础模型"'''
aspect_ratios = {
    "1:1": (1328, 1328),
    "16:9": (1664, 928),
    "9:16": (928, 1664),
    "4:3": (1472, 1140),
    "3:4": (1140, 1472)
}
width, height = aspect_ratios["16:9"]
image = pipe(
    prompt=prompt + "超清,4K,电影级构图",
    width=width,
    height=height,
    num_inference_steps=50,
    true_cfg_scale=4.0,
    generator=torch.Generator(device=device).manual_seed(42)
).images[0]
image.save("qwen_image_example.png")
GB 이상显存),CPU モードでの生成速度は遅いものの、利用可能です。
✅Qwen-Image 공식 소개: https://qwenlm.github.io/zh/blog/qwen-image/
✅Qwen-Image 모델: https://huggingface.co/Qwen/Qwen-Image
✅온라인 사용: https://chat.qwen.ai/ (입력창 아래의 이미지 생성 선택)









