
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
MOSS-TTSD: 오픈소스 이중 언어 대화 음성 합성 모델
小编 ·

MOSS-TTSD: 오픈소스 이중 언어 대화 음성 합성 모델
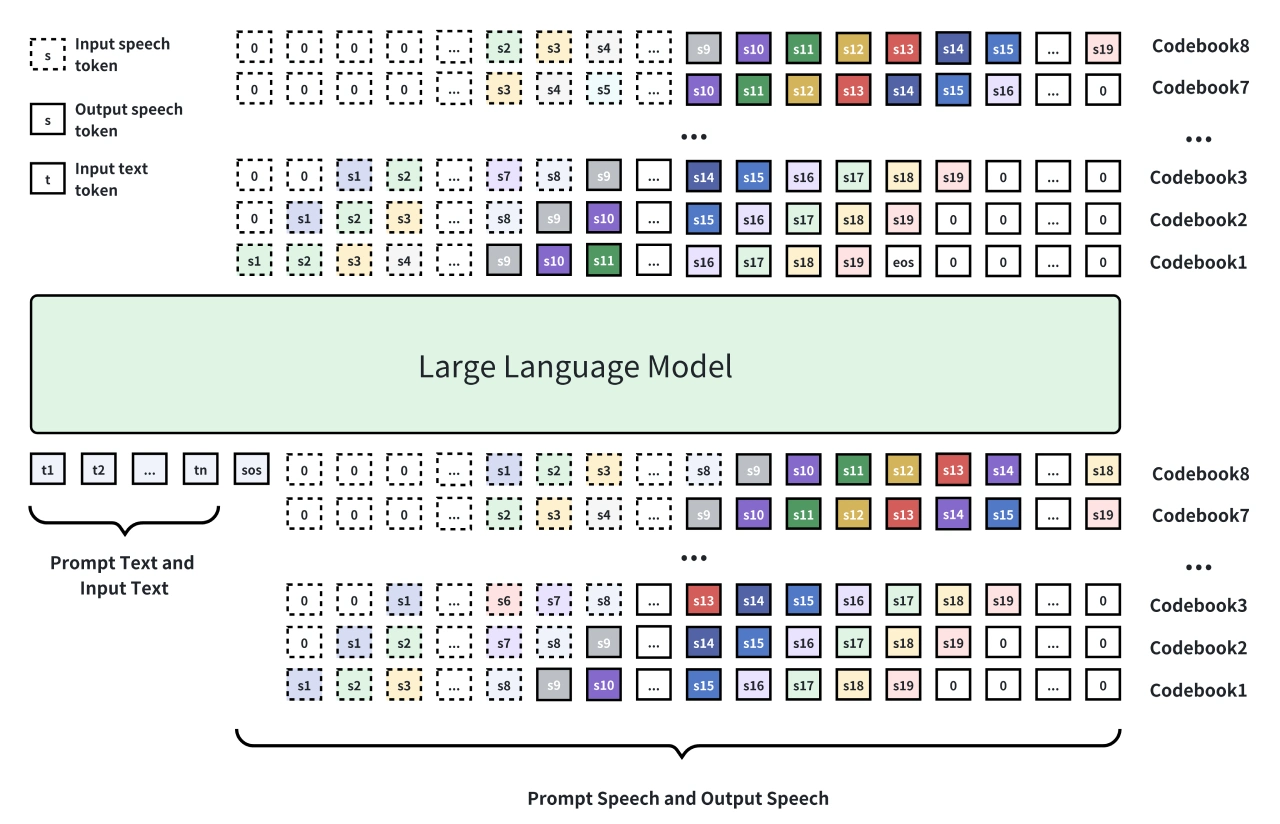
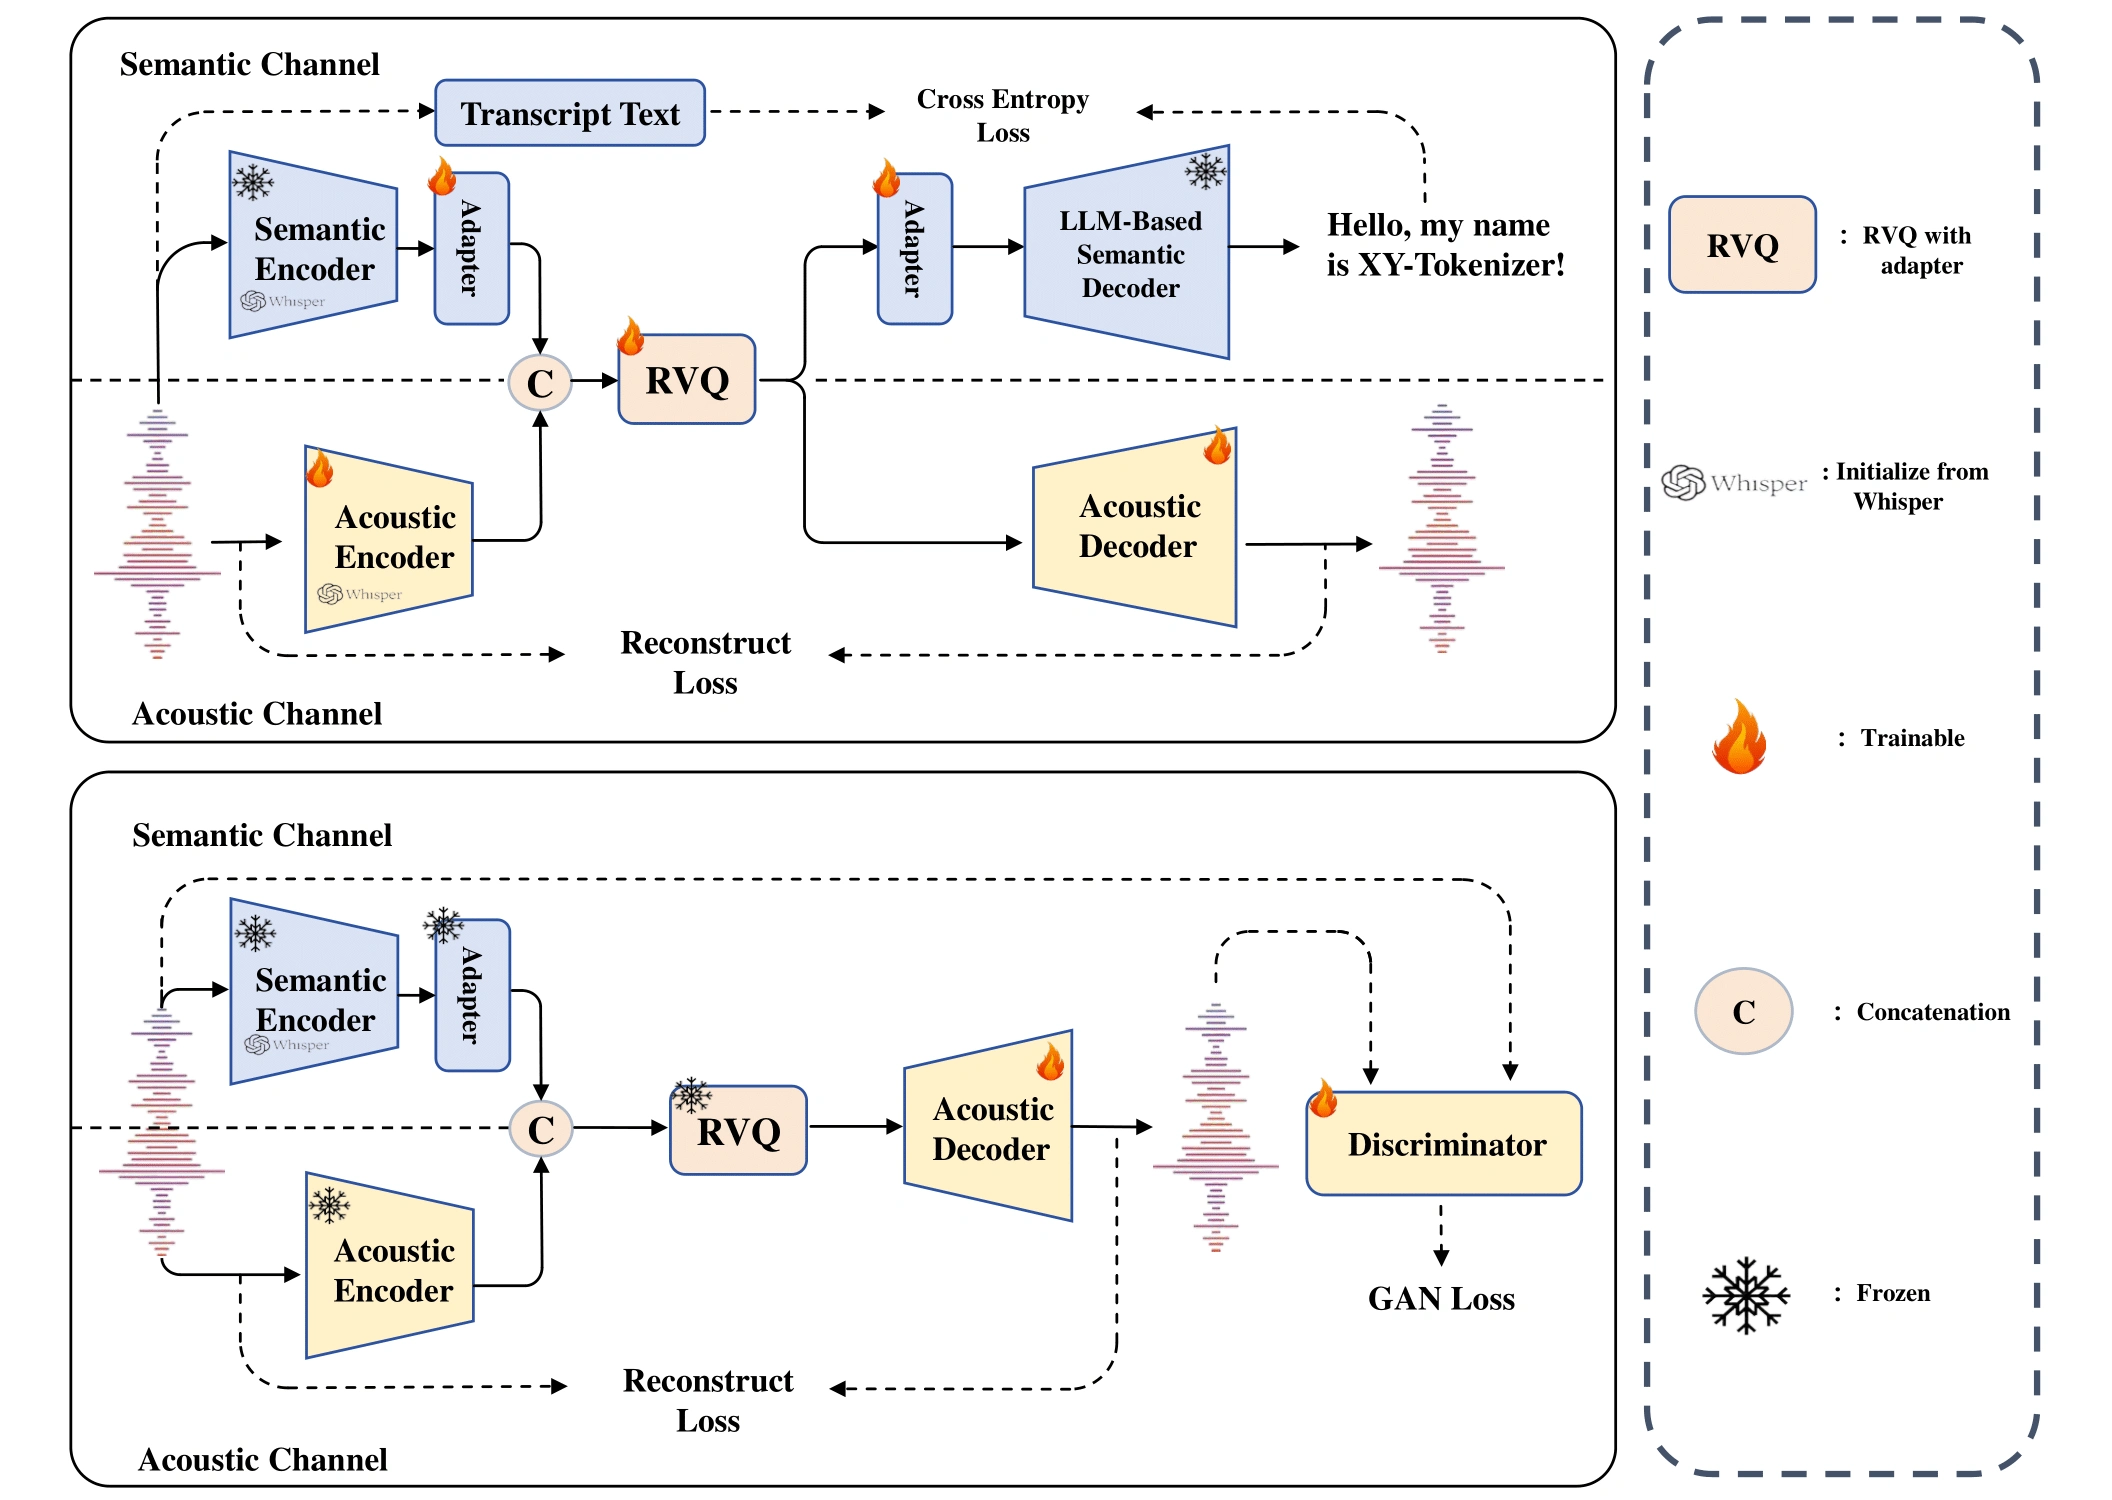
MOSS-TTSD는 칭화대학교 음성 및 언어 연구실이 텐센트 ai Lab 등 기관과 공동 개발한 오픈소스 이중 언어 대화 음성 합성 모델입니다. 중국어와 영어를 지원하며, 두 화자의 대본을 자연스럽고 표현력이 풍부한 대화 음성으로 변환할 수 있습니다. 이 모델은 Qwen3-1.7B-base 모델을 기반으로 추가 학습되었으며, 이산화된 음성 시퀀스 모델링을 사용하고, XY-Tokenizer를 통해 음성을 1kbps로 압축하면서 의미 정보와 음향 정보를 모두 보존합니다.
MOSS-TTSD 모델은 중국어와 영어 이중 언어를 지원하며, 여러 화자의 음색을 제로샷으로 복제할 수 있고, 최대 960초 길이의 음성을 생성할 수 있어 AI 팟캐스트, 영화·드라마 더빙, 긴 인터뷰 등의 시나리오에 적합합니다. 모델 가중치, 추론 코드, API 인터페이스가 모두 오픈소스로 공개되어 있으며, 무료 상업적 이용도 지원합니다.
주요 특징
✅ 높은 표현력의 대화 음성: 통합 시맨틱-음향 신경 오디오 코덱, 사전 학습된 대규모 언어 모델, 그리고 수백만 시간의 TTS 데이터와 40만 시간의 합성 및 실제 대화 음성 데이터를 기반으로 구축되어, 자연스러운 대화 운율과 강한 표현력을 가진 사람과 유사한 대화 음성을 생성할 수 있습니다.
✅ 듀얼 스피커 음성 복제: 제로샷 듀얼 스피커 음성 복제를 지원하며, 대본에 따라 화자를 정확하게 전환하여 대화 음성을 생성합니다.
✅ 중국어·영어 이중 언어 지원: 중국어와 영어 두 가지 언어로 높은 표현력의 음성을 생성할 수 있습니다.
✅ 장시간 음성 생성: 저비트레이트 코덱과 학습 프레임워크 최적화를 통해 장시간 음성 생성에 특화되어 학습되었습니다.
✅ 완전 오픈소스 및 상업적 이용 가능: MOSS-TTSD와 향후 업데이트는 완전 오픈소스로 공개되며, 무료 상업적 이용을 지원합니다.
MOSS-TTSD 기술 원리
✅ 모델 아키텍처: Qwen3-1.7B-base 모델을 기반으로 미세 조정되었으며, 이산화된 음성 모델링을 채택했습니다. 8층 RVQ(잔차 벡터 양자화)를 통해 음성 신호를 이산 토큰 시퀀스로 변환하고, 자가회귀 방식에 Delay Pattern을 결합하여 생성한 뒤, 마지막으로 디코더가 음성으로 복원합니다.
✅ 핵심 혁신: XY-Tokenizer는 2단계 멀티태스크 학습 프로세스를 갖추고 있습니다. 1단계에서는 자동 음성 인식(ASR)과 음성 재구성 작업을 동시에 학습하여 시맨틱 정보와 거친 수준의 음향 정보를 융합하고, 2단계에서는 인코더와 양자화기를 고정하고 디코더만 학습시켜 재구성 손실과 GAN 손실을 추가함으로써 세부 표현력을 강화합니다.
✅ 데이터 규모 및 사전 학습: 약 100만 시간의 단일 화자 음성 데이터와 40만 시간의 대화 음성 데이터로 학습되었으며, 데이터는 엄격하게 선별되고 주석 처리되었고, 중국어와 영어 TTS 사전 학습도 수행되었습니다.
활용 시나리오
✅ AI 팟캐스트 제작: MOSS-TTSD는 텍스트를 다수 화자의 대화 팟캐스트 오디오로 자동 변환할 수 있으며, 제로샷 음성 복제와 장시간 음성 생성을 지원하여 제작 비용을 절감할 수 있습니다.
✅ 영화·드라마 더빙 및 애니메이션: 영화, 드라마, 애니메이션을 위한 자연스러운 대화 음성을 생성하며, 다국어 전환을 지원하여 더빙 효율을 높입니다.
✅ 긴 인터뷰 및 회의 기록: 인터뷰나 회의 텍스트를 음성으로 변환하여 대화의 운율과 감정을 보존하므로, 보관 및 공유에 편리합니다.
장점과 특징
✅ 오픈소스 및 상업 친화적: MOSS-TTSD 모델 가중치, 추론 코드, API 인터페이스가 모두 오픈소스로 공개되어 있어 사용자는 무료로 상업적으로 이용할 수 있습니다.
✅ 자연스러움과 표현력: 음성의 자연스러움과 표현력은 업계 최고 수준에 도달합니다.
✅ 음성 이벤트 제어 지원: 예를 들어 웃음 소리와 같은 비언어적 음성을 포함하여 음성에 더 큰 표현력을 부여합니다.
오픈소스 주소:https://github.com/OpenMOSS/MOSS-TTSD
MOSS-TTSD 공식 웹사이트:https://www.open-moss.com/cn/









