
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
MultiTalk: 메이투안이 오픈소스로 공개한 오디오 기반 다인원 대화 영상 생성 도구
小编 ·

MultiTalk: 메이투안이 오픈소스로 공개한 오디오 기반 다인원 대화 영상 생성 도구
MultiTalk는 메이투안(美团) 시각 인공지능 팀이 오픈 소스로 공개한 오디오 기반 다인 대화 동영상 생성 도구입니다. 여러 사람의 오디오, 참조 이미지, 텍스트 프롬프트를 바탕으로 입 모양이 동기화되고 자연스러운 몸동작을 하는 디지털 휴먼 대화 영상을 생성하며, 그 효과가 매우 뛰어납니다. 사용자는 오디오, 참조 이미지, 프롬프트를 업로드하기만 하면 입 모양이 일치하는 대화 영상을 만들 수 있으며, 노래하는 장면이나 만화 캐릭터도 생성할 수 있습니다.
이 프로젝트에는 여러 가지 실용적인 특징이 있습니다. 오디오 기반 입 모양 동기화가 매우 정교하며, 프롬프트를 통해 가상 캐릭터의 동작을 제어할 수 있고, 다양한 해상도의 영상을 출력할 수 있으며, 최대 15초 길이의 대화 장면을 생성할 수 있습니다. 또한 텍스트 음성 변환(TTS) 기능을 통합했고, 생성 효율을 높이기 위한 다양한 최적화를 진행했으며, 저显存 모드와 다중 GPU 추론을 지원하여 단일 RTX 4090 그래픽 카드에서도 실행할 수 있습니다.
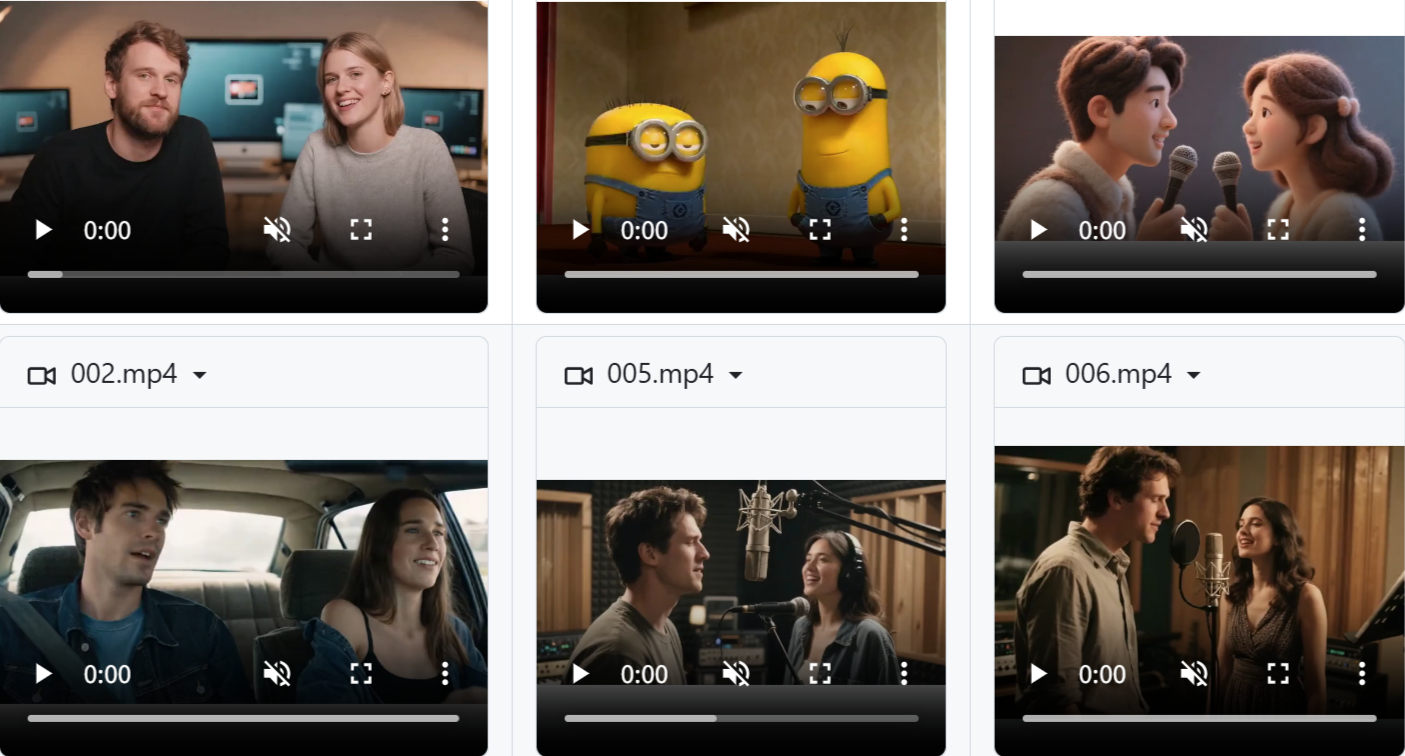
기능 특징
✅오디오 기반 구동: 여러 사람의 오디오를 입력하면 자연스러운 입 모양 동기화와 몸동작을 생성합니다.
✅단일 사진 입력: 참조 이미지 한 장만으로 다인 상호작용 영상을 생성할 수 있습니다.
✅복잡한 동작 준수: 복잡한 텍스트 프롬프트를 지원하여 설명에 부합하는 동작과 장면을 생성합니다.
✅다국어 지원: 다국어 오디오를 처리하여 정밀한 입술 동기화를 구현합니다.
✅긴 동영상 생성: 자기회귀 방식으로连贯한 긴 영상을 생성합니다.
✅고효율 학습 전략: 2단계 학습, 부분 파라미터 학습, 다중 작업 학습을 통해 모델 성능을 향상시킵니다.
✅L-RoPE 기술: 라벨 회전 위치 인코딩을 통해 다중 스트림 오디오와人物的 정밀한 바인딩을 구현합니다.
✅고품질 출력: 생성된 영상은 자연스럽고 부드러우며, 시각적으로 거의 아티팩트가 없습니다.
기술 하이라이트
✅최초의 L-RoPE 기술: 라벨 회전 위치 인코딩으로 다중 오디오 스트림과人物的错位 문제를 해결하여 오디오와 인물을 정밀하게 매칭합니다.
✅오디오 기반 영상 생성: 여러 사람의 오디오, 참조 이미지, 텍스트 프롬프트를 입력하면 입 모양이 동기화되고 몸동작이 자연스러운 인터랙티브 영상을 생성합니다.
✅부분 파라미터 학습 + 다중 작업 학습 전략: 복잡한 동작 명령 따르기 능력을 유지하는 동시에 동적인 인물의自适应 위치를 구현합니다.
✅다양한 장면 지원: 영화·TV 제작, 라이브 커머스 등 다양한 장면에 활용할 수 있습니다.
기술 프레임워크
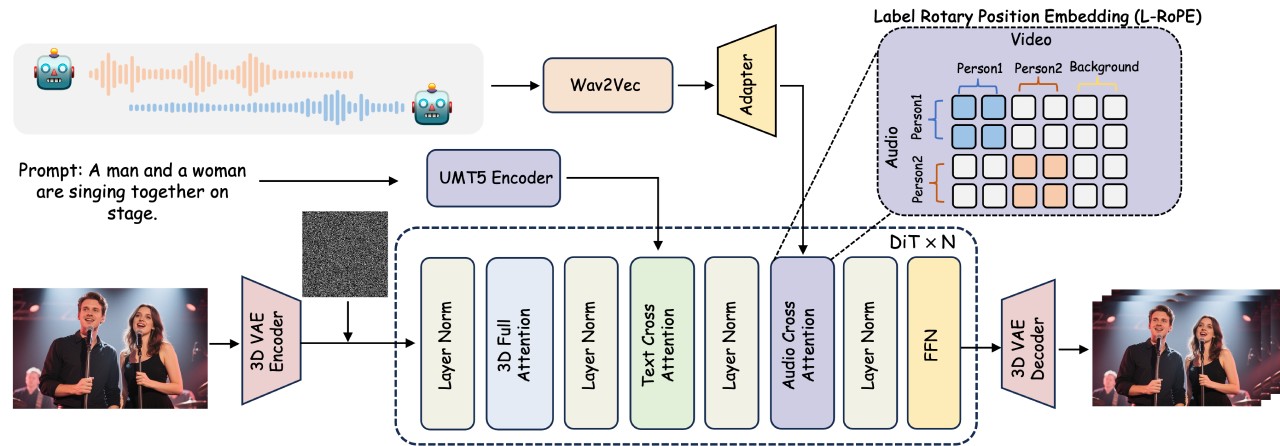
✅기반 모델 구조: DiT 영상 확산 모델을 핵심으로 하고, 3D 변분 오토인코더를 통합하여 영상 데이터를 효율적으로 처리합니다.
✅단일 인물 오디오 통합: 각 DiT 블록의 텍스트 교차 어텐션 레이어 뒤에 오디오 교차 어텐션 메커니즘을 추가하고, Wav2Vec으로 오디오 특징을 추출하며, 오디오 어댑터를 통해 영상과 오디오의 시간적 세분성 불일치 문제를 해결합니다.
✅다중 인물 오디오 처리: L-RoPE 기술로 다중 스트림 오디오와 여러 인물의 정밀한 바인딩을 구현하여 "齐声说话"(다인 동시 발화) 문제를 방지합니다.
학습 전략
✅2단계 학습: 먼저 단일 인물 영상 생성 능력을 학습하고, 그 다음 다인물 상호작용 및 바인딩을 학습합니다.
✅부분 파라미터 학습: 오디오 교차 어텐션 레이어와 오디오 어댑터의 네트워크 파라미터만 업데이트하고, 다른 기반 모델 파라미터는 고정합니다.
✅다중 작업 학습: 오디오+이미지→영상, 이미지→영상 두 가지 학습 방식을 결합하여 모델의 명령 준수 능력을 강화합니다.
성능表现
✅정량 평가: 머리 및 신체 동작 생성 과제에서 여러 최첨단 방법과 비교했을 때, 입술 동기화(Sync-C, Sync-D)와 영상 품질(FID, FVD)에서 뛰어난 성능을 보입니다.
✅정성 평가: 복잡한 상호작용 장면을 처리하는 데 효과적이며, 복잡한 텍스트 프롬프트에 정밀하게 반응하는 영상을 생성할 수 있고, 시각적 아티팩트가 적으며 화면이 자연스럽고 사실적입니다.
✅긴 영상 생성: 자기회귀 방식으로 이전에 생성된 영상의 마지막 부분을 조건으로 사용하여 새로운 영상 클립을 생성함으로써 시간적 일관성과 확장성을 보장합니다.
적용 시나리오
영화·TV 제작: 가상 캐릭터 상호작용, 애니메이션 더빙, 특수 효과 합성, 단편 영상 제작
라이브 커머스: 가상 진행자 상호작용, 제품展示 해설, 다국어 라이브 방송
교육 분야: 가상 교사 상호작용, 언어 학습, 역사 재현
게임 개발: 가상 캐릭터 대화, NPC 상호작용, 다인 온라인 게임
광고 마케팅: 가상 브랜드 대사, 제품推广, 소셜 미디어 광고
가상 소셜: 가상 소셜 플랫폼 상호작용, 가상 회의
엔터테인먼트·크리에이티브: 뮤직 비디오, 가상 콘서트, 크리에이티브 단편
공공 서비스: 뉴스 방송, 공공 서비스 홍보
기업 교육: 가상 교육 시나리오, 상황模拟
국제 교류: 다국어 대화, 문화 교류
프로젝트 주소
프로젝트 홈페이지:https://meigen-ai.github.io/multi-talk/
오픈 소스 코드:https://github.com/MeiGen-AI/MultiTalk
논문:https://arxiv.org/abs/2505.22647









