
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
ColQwen-Omni: 오픈소스 멀티모달 RAG 모델
小编 ·

ColQwen-Omni: 오픈소스 멀티모달 RAG 모델
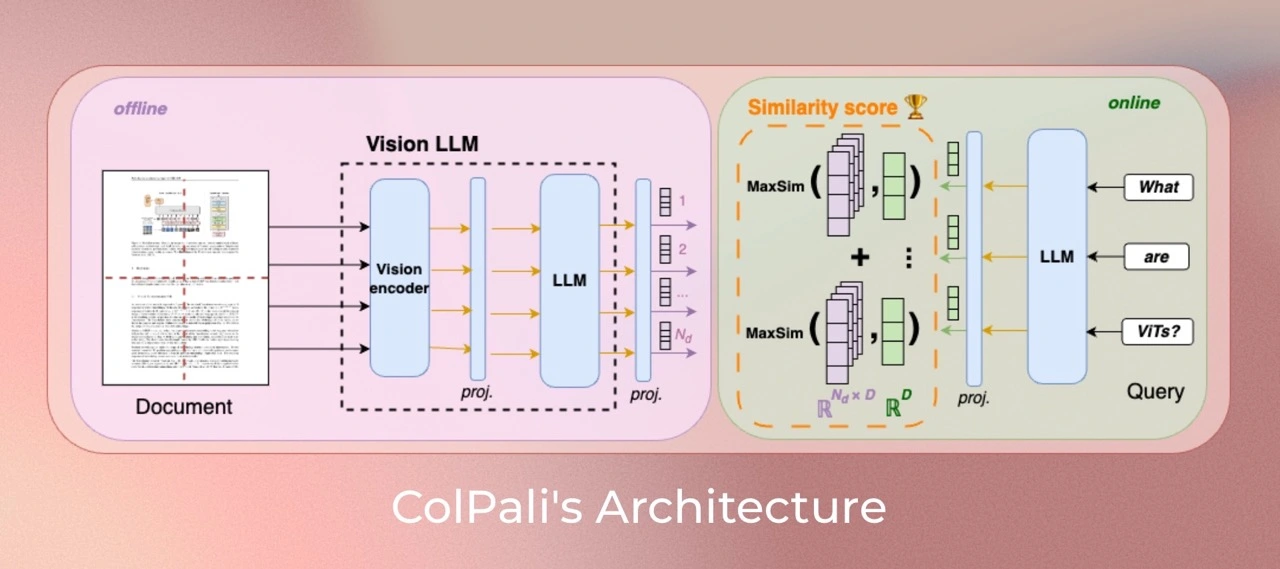
ColQwen-Omni은 ColQwen2와 Qwen2-VL을 기반으로 구축된 오픈소스 다중 모달 RAG 모델로, ColBERT 검색 패러다임을 오디오 모달로 확장한 최초의 오픈소스 모델입니다.
크로스 모달 검색을 지원하며 텍스트, 오디오, 이미지 등 다양한 모달 데이터를 처리할 수 있습니다. 훈련 데이터셋은 127,460개의 쿼리-페이지 쌍으로 구성되어 있으며, 63%는 공개 학술 데이터셋 훈련 세트, 37%는 합성 데이터셋으로, 제로샷 오디오 검색 능력을 갖추고 있습니다.
핵심亮点
크로스 모달 검색: 텍스트로 오디오 검색, 오디오로 이미지 검색 등을 지원하며, 모든 모달 데이터가 동일한 벡터 공간에서 검색됩니다.
오디오/비디오 직접 처리: 전사 과정 없이 오디오 및 비디오 원시 데이터를 직접 처리하여 감정, 어조 및 시각적 디테일을 보존합니다.
초고속 검색: 30분 분량의 오디오를 10초 내에 처리하며, 단편 비디오는 각 구간당 10초 이내, 단일 쿼리는 100밀리초 이내에 처리됩니다.
TMRoPE 동기화: 시간 정렬 다중 모달 임베딩으로 비디오/오디오 프레임을 정밀하게 정렬합니다.
경량 고효율: 30억 개의 파라미터로 Colab의 무료 GPU에서도 실행할 수 있습니다.
ColQwen-Omni 기술 세부 사항
훈련 전략: colpali-engine==0.3.11을 사용하여 훈련되었으며, Qwen2.5-Omni-3B-Instruct를 기반으로 구축되고 ColBERT 스타일의 다중 벡터 표현 전략을 채택했습니다.
훈련 데이터: 127,460개의 쿼리-페이지 쌍을 포함하고 있으며, 공개 학술 데이터셋과 합성 데이터셋을 망라합니다.
동적 해상도 처리: 동적 이미지 해상도 입력을 지원하며, 이미지를 축소하거나 자르지 않고 원본 가로세로 비율을 유지합니다.
제로샷 오디오 검색 능력: 훈련 데이터에는 이미지-텍스트 쌍만 포함되어 있지만, 모델은 여전히 오디오 콘텐츠를 검색할 수 있습니다.
적용 시나리오
오디오/비디오 검색: 텍스트로 TED 강연 검색, 오디오로 YouTube 표지 이미지 검색 등.
문서 질의응답: PDF/이미지 질의응답으로 OCR 없이 레이아웃과 차트를 분석할 수 있습니다.
교육 연구: 강의 비디오/강의 자료 검색 및 크로스 모달 분석 수행.
엔터테인먼트 분석: 단편 비디오/팟캐스트 콘텐츠 검색으로 감정과 환경음을 보존합니다.
프라이버시에 민감한 시나리오: Colab에서 로컬로 실행 가능하며 데이터를 업로드할 필요가 없습니다.
핵심 문제
ColQwen2.5-Omni의 훈련 데이터셋은 어떤 특징이 있나요?
이 모델의 훈련 데이터셋은 127,460개의 쿼리-페이지 쌍으로 이루어져 있으며, 63%는 공개 학술 데이터셋 훈련 세트, 37%는 합성 데이터셋(웹 크롤링으로 수집한 PDF 페이지 및 VLM이 생성한 의사 질문을 포함)입니다. 데이터셋은 전부 영어로 설계되어 비영어 언어에 대한 제로샷아웃 일반화 능력 연구를 용이하게 합니다. 이 중 2%의 샘플은 검증 세트로 사용되어 하이퍼파라미터 튜닝에 활용됩니다. 또한 ViDoRe와 훈련 세트에 다중 페이지 PDF 문서가 동시에 사용되지 않아 평가 오염을 방지합니다. 언어 모델 사전 훈련 말뭉치와 다중 모달 훈련에는 다국어 데이터가 포함될 수 있습니다.
이미지 처리에서 ColQwen2.5-Omni는 ColPali와 어떻게 다른가요?
ColQwen2.5-Omni는 동적 이미지 해상도를 수용하며 가로세로 비율을 변경하기 위해 이미지를 축소하지 않고, 최대 해상도에서 최대 1024개의 이미지 패치를 생성합니다. 반면 ColPali는 이미지의 가로세로 비율을 변경합니다.
ColQwen2.5-Omni를 사용하여 오디오를 검색하려면 어떻게 해야 하나요?
먼저 0.3.11 이상의 버전의 colpali-engine을 설치합니다(pip install git+https://github.com/illuin-tech/colpali 명령을 통해 설치 가능). 다음으로 관련 라이브러리를 임포트하고 모델과 프로세서를 로드합니다. 오디오 데이터셋을 처리하고 데이터 로더를 생성하여 오디오 임베딩 벡터를 만듭니다. 마지막으로 쿼리 텍스트를 입력하고, 모델을 통해 쿼리 임베딩 벡터를 생성하여 오디오 임베딩 벡터와 점수를 매기고, _topk 결과를 가져오는 검색 함수를 정의하면 해당 오디오를 표시할 수 있습니다.
프로젝트 링크
GitHub 주소:https://github.com/illuin-tech/colpali.
모델 주소:https://huggingface.co/vidore/colqwen-omni-v0.1.









