
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Kyutai TTS: 실시간 환경을 위한 오픈소스 텍스트 음성 변환 도구
小编 ·

Kyutai TTS: 실시간 환경을 위한 오픈소스 텍스트 음성 변환 도구
Kyutai TTS는 프랑스 Kyutai Labs에서 개발한 오픈소스 텍스트 음성 변환 모델로, 실시간 애플리케이션을 위해 설계되었습니다. 16억 개의 파라미터를 갖추고 있으며, 영어와 불어의 단어 오류율은 각각 2.82%와 3.29%이고, 음성 생성 지연 시간은 단 220밀리초에 불과하여 라이브 스트리밍 및 음성 비서와 같은 시나리오에 적합합니다. 스트리밍 처리 및 지연 스트림 모델링 기술을 통해 텍스트와 음성 생성이 더욱 효율적입니다.
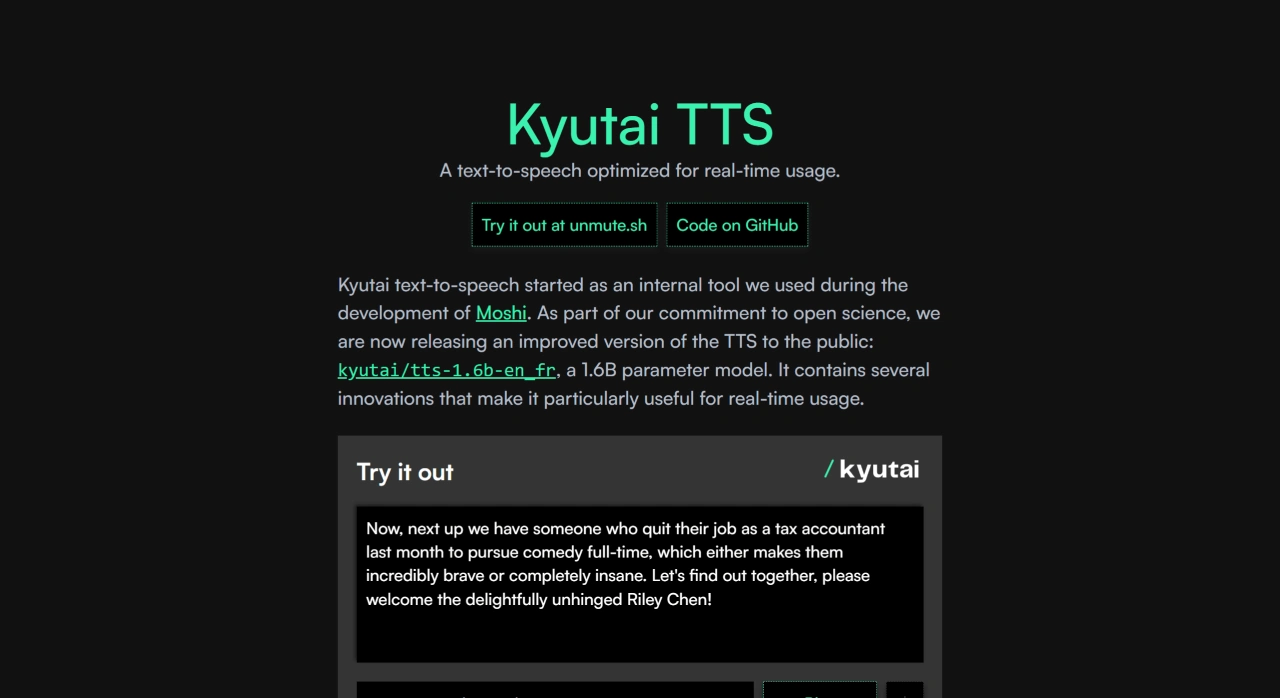
기술 특징:
스트리밍 처리 및 낮은 지연 시간: Kyutai TTS는 첫 번째 텍스트 토큰을 수신한 직후 즉시 오디오를 생성할 수 있으며, 지연 시간은 단 220밀리초입니다. NVIDIA L40S GPU에서 32개의 요청을 처리할 때 지연 시간은 약 350밀리초입니다.
고정밀 음성 출력: 영어와 불어의 단어 오류율은 각각 2.82%와 3.29%이며, 화자 유사도는 각각 77.1%와 78.7%에 달하여 자연스럽고 원본 샘플에 가까운 음성을 제공합니다.
장문 콘텐츠 생성: 긴 문서를 처리할 수 있어 기존 TTS 모델의 30초 제한을突破(돌파)합니다.
음성 클로닝: 사용자가 10초 분량의 오디오 샘플을 제공하면 모델이 화자의 음색과 억양 등을 일치시킬 수 있습니다. 합법성을 보장하기 위해 Kyutai TTS는 공개 데이터셋을 기반으로 음성 라이브러리를 제공하며, 음성 임베딩 모델을 직접 배포하지는 않습니다.
단어 타임스탬프: 생성된 오디오의 모든 단어에는 정확한 타임스탬프가 있어 실시간 자막 생성 또는 인터랙티브 애플리케이션에 용이합니다.
아키텍처 및 학습:
지연 스트림 모델링(DSM): 모델은 텍스트를 수신하는 동시에 실시간으로 음성을 생성하여 스트리밍 텍스트 입력을 지원하고 여러 요청을 동시에 처리할 수 있습니다.
학습 데이터 및 하드웨어: 250만 시간의 공개 오디오 데이터를 사용하여 학습되었으며, Whisper가 전사 텍스트를 생성했습니다. 학습 과정에는 32개의 H100 GPU가 사용되었습니다.
활용 시나리오:
실시간 인터랙션: 가상 비서, 온라인 교육 플랫폼 및 실시간 자막 생성에 적합합니다.
콘텐츠 제작: 팟캐스트, 오디오북 등 장문 콘텐츠 생성에 사용될 수 있습니다.
보조 도구: 시각 장애인을 위한 고품질 텍스트 낭독 서비스를 제공합니다.
기타 TTS와의 비교:
시장의 다른 TTS 모델과 비교했을 때, Kyutai TTS는 단어 오류율과 화자 유사도 면에서 뛰어난 성능을 보이며, 특히 실시간 인터랙션 시나리오에서 탁월한 성능을 발휘합니다.
Kyutai TTS는 CC-BY-4.0 라이선스로 오픈소스화되었으며, 소스 코드와 가중치는 GitHub 및 Hugging Face에서 확인할 수 있습니다. 개발자는 음성 데이터를 기부하여 모델의 음성 스타일과 언어 지원을 확장하는 데 기여할 수 있습니다.
프로젝트 주소: https://kyutai.org/next/tts









