
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Alibaba Ovis-U1: 멀티모달 이해·이미지 생성·편집을 하나로
小编 ·

Alibaba Ovis-U1: 멀티모달 이해·이미지 생성·편집을 하나로
2025년 6월 29일, 알리바바 국제ai팀이 멀티모달 대형 모델 Ovis-U1을 출시했습니다. Ovis 시리즈의 최신 버전으로, 기존 아키텍처를 기반으로 개발되었으며 파라미터 규모는 3억 개입니다.
이 모델은 멀티모달 이해, 이미지 생성 및 편집 기능을 통합했으며, 핵심 구성 요소에는 비주얼 토크나이저, 비주얼 임베딩 테이블 및 대형 언어 모델이 포함됩니다. 비주얼과 텍스트 임베딩의 일치도를 최적화하여 기존 멀티모달 모델의 일부 한계를 해결하고 복잡한 장면에서 더 나은 성능을 보여줍니다. 텍스트와 이미지 입력을 지원하며, 수학적 추론, 물체 인식 등 작업에서 뛰어난 효과를 보입니다. 이미지의 물체나 손글씨를 정확하게 인식할 뿐만 아니라 지시 사항에 따라 이미지를 생성하거나 수정할 수도 있습니다.
핵심 능력
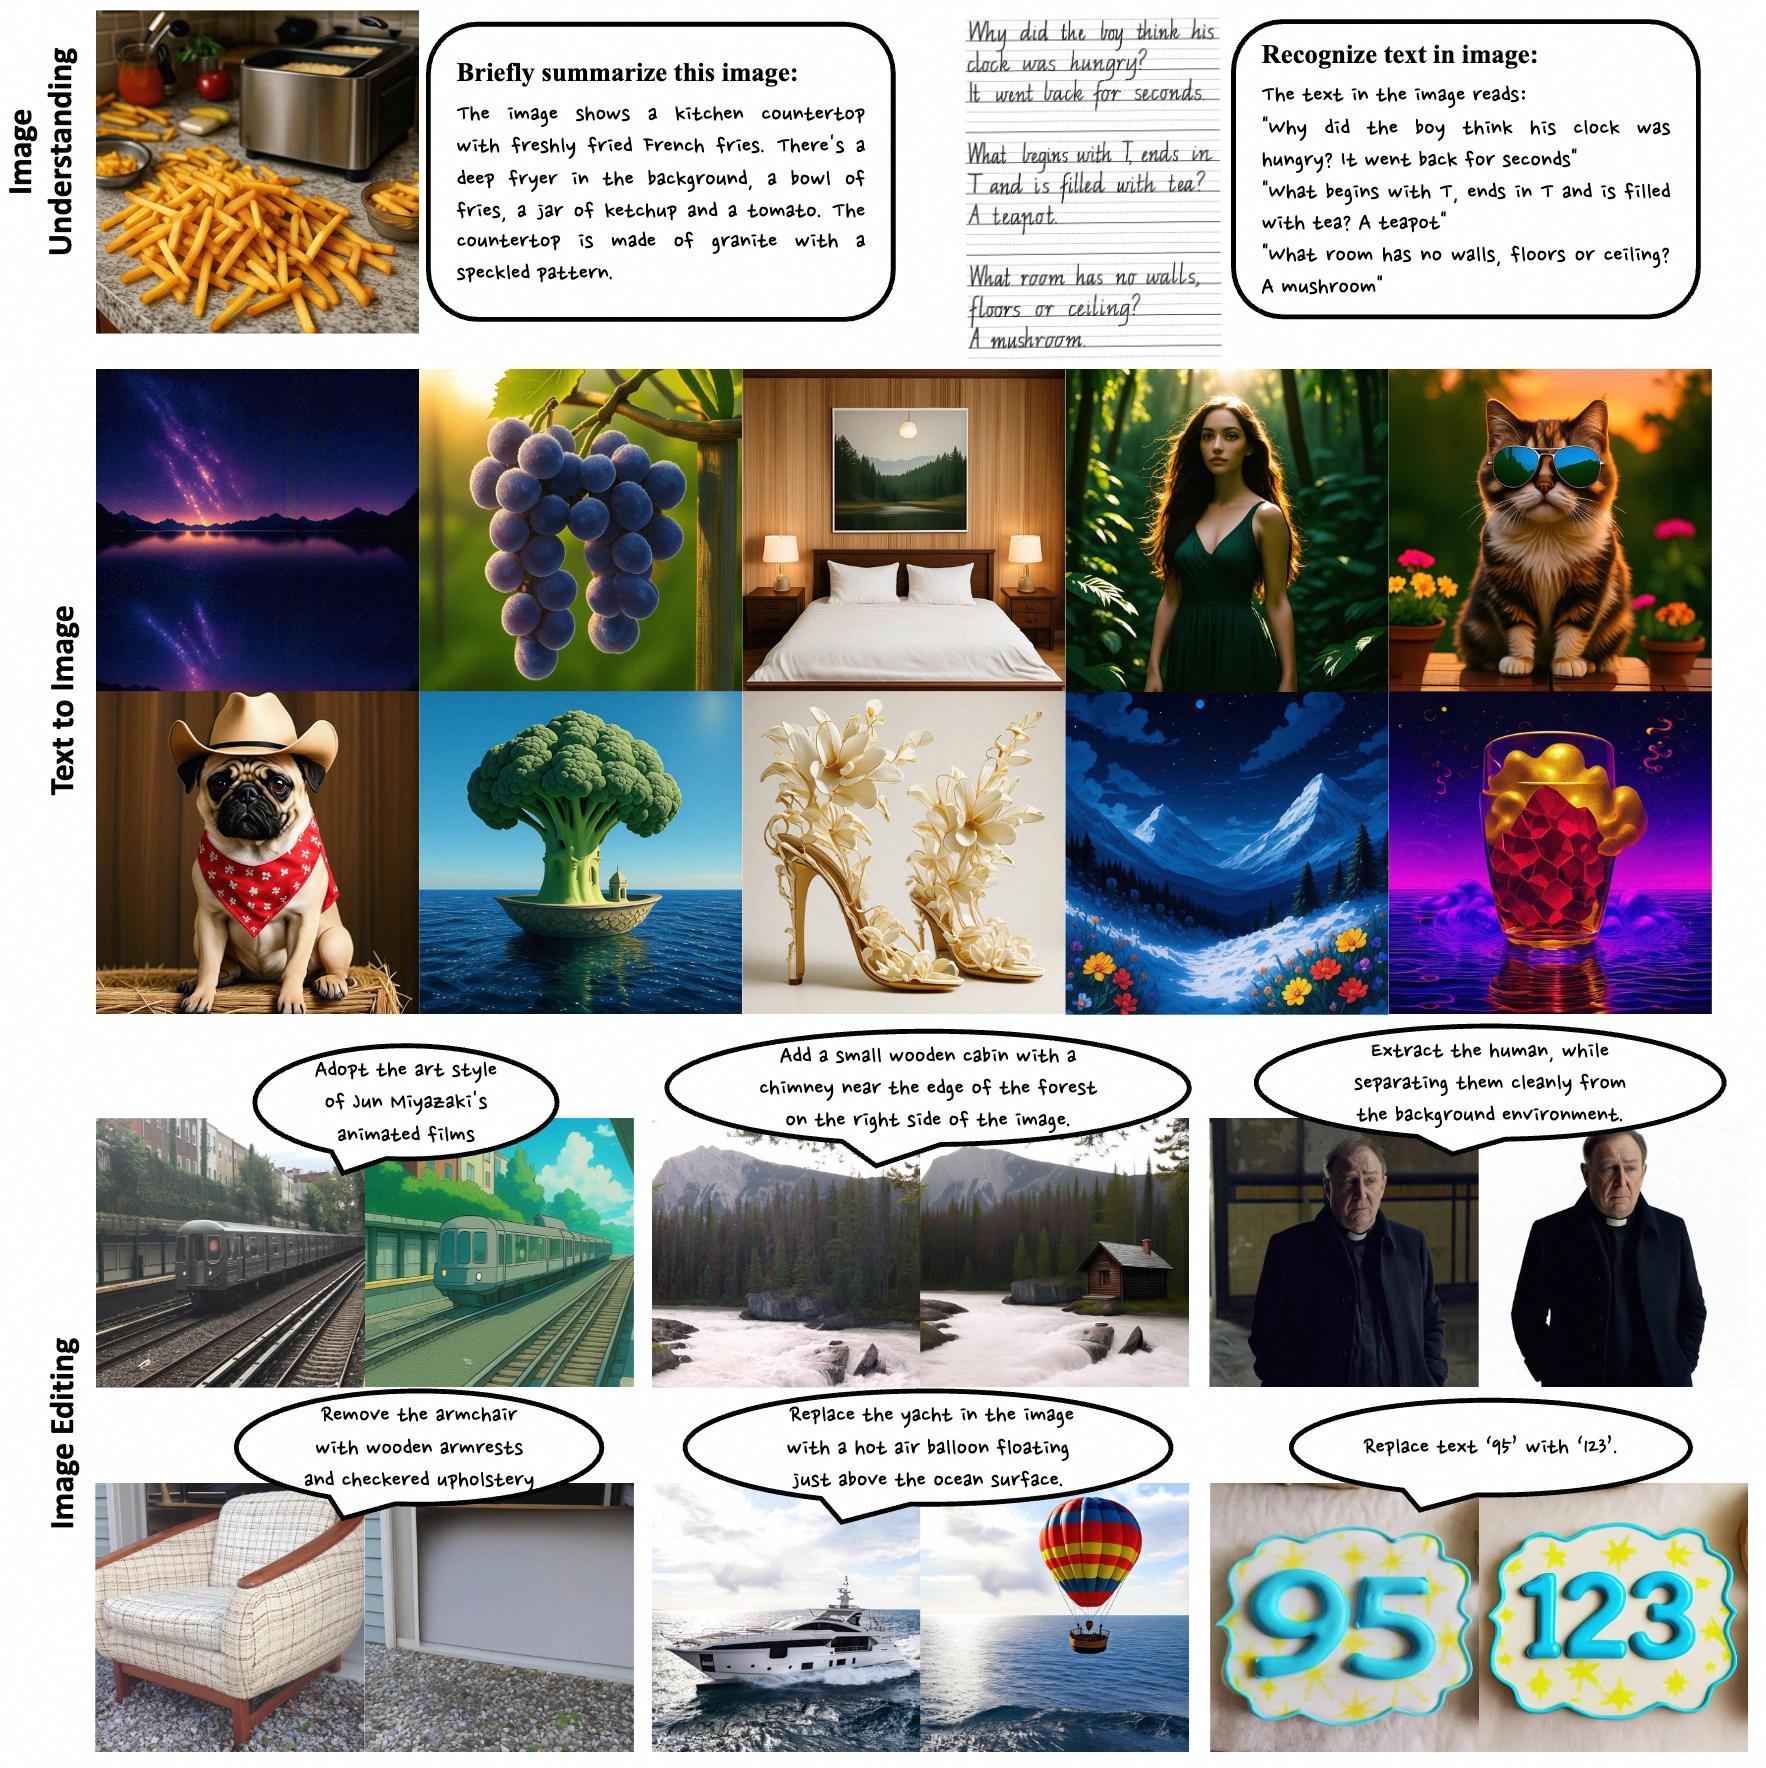
멀티모달 이해: 복잡한 시각 장면과 텍스트 내용을 분석하여 이미지와 관련된 질문에 답하고, 시각적 질의응답(VQA), 이미지 설명 생성 등 작업을 수행할 수 있습니다.
텍스트-이미지 생성: 텍스트 설명에 따라 고품질 이미지를 생성하며, 다양한 스타일과 복잡한 장면 요구 사항에 적합합니다.
이미지 편집: 텍스트 지시를 통해 이미지 요소의 추가, 조정, 교체, 삭제 등 작업을 수행하며 스타일 변환을 지원합니다.
기술 아키텍처
비주얼 디코더: 확산 기반 Transformer 아키텍처(MMDiT)를 채택하여 텍스트 임베딩을 고품질 이미지로 변환합니다.
양방향 토큰 정제기: 텍스트와 비주얼 임베딩 간의 상호작용을 강화하여 이미지 합성 및 편집 효과를 향상시킵니다.
비주얼 인코더: 사전 학습된 모델(예: Aimv2-large-patch14-448)을 기반으로 미세 조정되어 멀티모달 작업에 적응합니다.
어댑터: 비주얼 인코더와 멀티모달 대형 언어 모델(MLLM)을 연결하여 두 종류의 임베딩 데이터를 정렬합니다.
멀티모달 대형 언어 모델: 핵심 모듈로서 텍스트와 시각 정보를 처리하고 다중 작업 처리를 지원합니다.
훈련 방법
Ovis-U1은 멀티모달 이해, 이미지 생성 및 편집 작업을 동기식으로 훈련하여 지식을 공유하고 일반화 능력을 향상시킵니다. 훈련은 6단계에 걸쳐 각 작업의 성능을 점진적으로 최적화합니다.
데이터 구성
멀티모달 이해 데이터: COYO, Wukong, Laion 등 공개 데이터셋 및 내부 개발 데이터에서 가져옵니다.
이미지 생성 데이터: Laion5B, JourneyDB 데이터셋 및 사전 학습된 모델에서 생성된 상세 설명을 기반으로 합니다.
이미지 편집 데이터: 참조 이미지 기반 생성, 픽셀 단위 제어 등 작업의 데이터를 포함합니다.
성능 최적화
이미지 편집에서 텍스트와 이미지 가이드 계수(CFG)를 조정하여 지시 사항 실행을 정밀하게 제어합니다. OpenCompass, GenEval 등 벤치마크 테스트를 채택하여 모델 능력을 종합적으로 평가합니다.
응용 시나리오
콘텐츠 제작: 아티스트 및 비디오 편집자의创意 기획을 지원합니다.
광고 마케팅: 제품과 대상 고객 설명에 따라 광고 이미지와 포스터를 생성합니다.
게임 개발: 게임 장면, 캐릭터 및 소품 이미지를 생성합니다.
건축 설계: 건축 컨셉 도면 및 실내 배치方案을 출력합니다.
과학 연구: 복잡한 과학 현상과 실험 장면을 시각화합니다.
Ovis 시리즈의 오픈소스 전통을 이어받아, 모델 코드, 가중치 및 훈련 데이터는 Apache2.0 라이선스를 통해 Hugging Face와 GitHub에 공개되었으며, 개발자는 빠르게 재현하고 배포할 수 있습니다.
프로젝트 주소
GitHub 저장소:https://github.com/AIDC-AI/Ovis-U1
HuggingFace 모델 라이브러리:https://huggingface.co/AIDC-AI/Ovis-U1-3B
기술 논문:https://github.com/AIDC-AI/Ovis-U1/blob/main/docs/Ovis_U1_Report.pdf
온라인 체험:https://huggingface.co/spaces/AIDC-AI/Ovis-U1-3B









