
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
DreamActor-H1: 상품을 소개하는 인물 영상을 생성, 라이브 커머스 영상 제작에 활용
小编 ·

DreamActor-H1: 상품을 소개하는 인물 영상을 생성, 라이브 커머스 영상 제작에 활용
DreamActor-H1는바이트댄스가 2025년 6월에 출시한 비디오 생성 프레임워크로, 확산 변환기(DiT) 기술을 기반으로 하며, 주로 전자상거래 및 디지털 마케팅 분야를 대상으로 하여带货(상품 판매) 비디오 생성에 사용됩니다.
이 프레임워크는 인물과 제품 이미지를 페어링하여 고품질의 인물-제품 데모 비디오를 생성할 수 있습니다. 대규모 혼합 데이터셋에서 다중 카테고리 증강 학습을 거쳐, 인물과 제품의 정체성 정보를 보존하고 물리적 법칙에 부합하는 데모 동작을 생성하는 면에서 기존 방법보다 우수하며, 개인화된 전자상거래 광고 및 인터랙티브 미디어에 적합합니다. 3D 신체 메시 템플릿과 제품 경계 상자를 활용하여 정밀한 동작 가이드를 제공하며, VAE 인코딩으로 추출된 외관 가이드, 구조화된 텍스트 인코딩의 카테고리 수준 시맨틱, 그리고 참조 어텐션, 객체 어텐션 등의 메커니즘을 결합하여 기존 프레임워크의 정체성 보존 및 공간 관계 이해难题(어려움)를 해결했습니다.
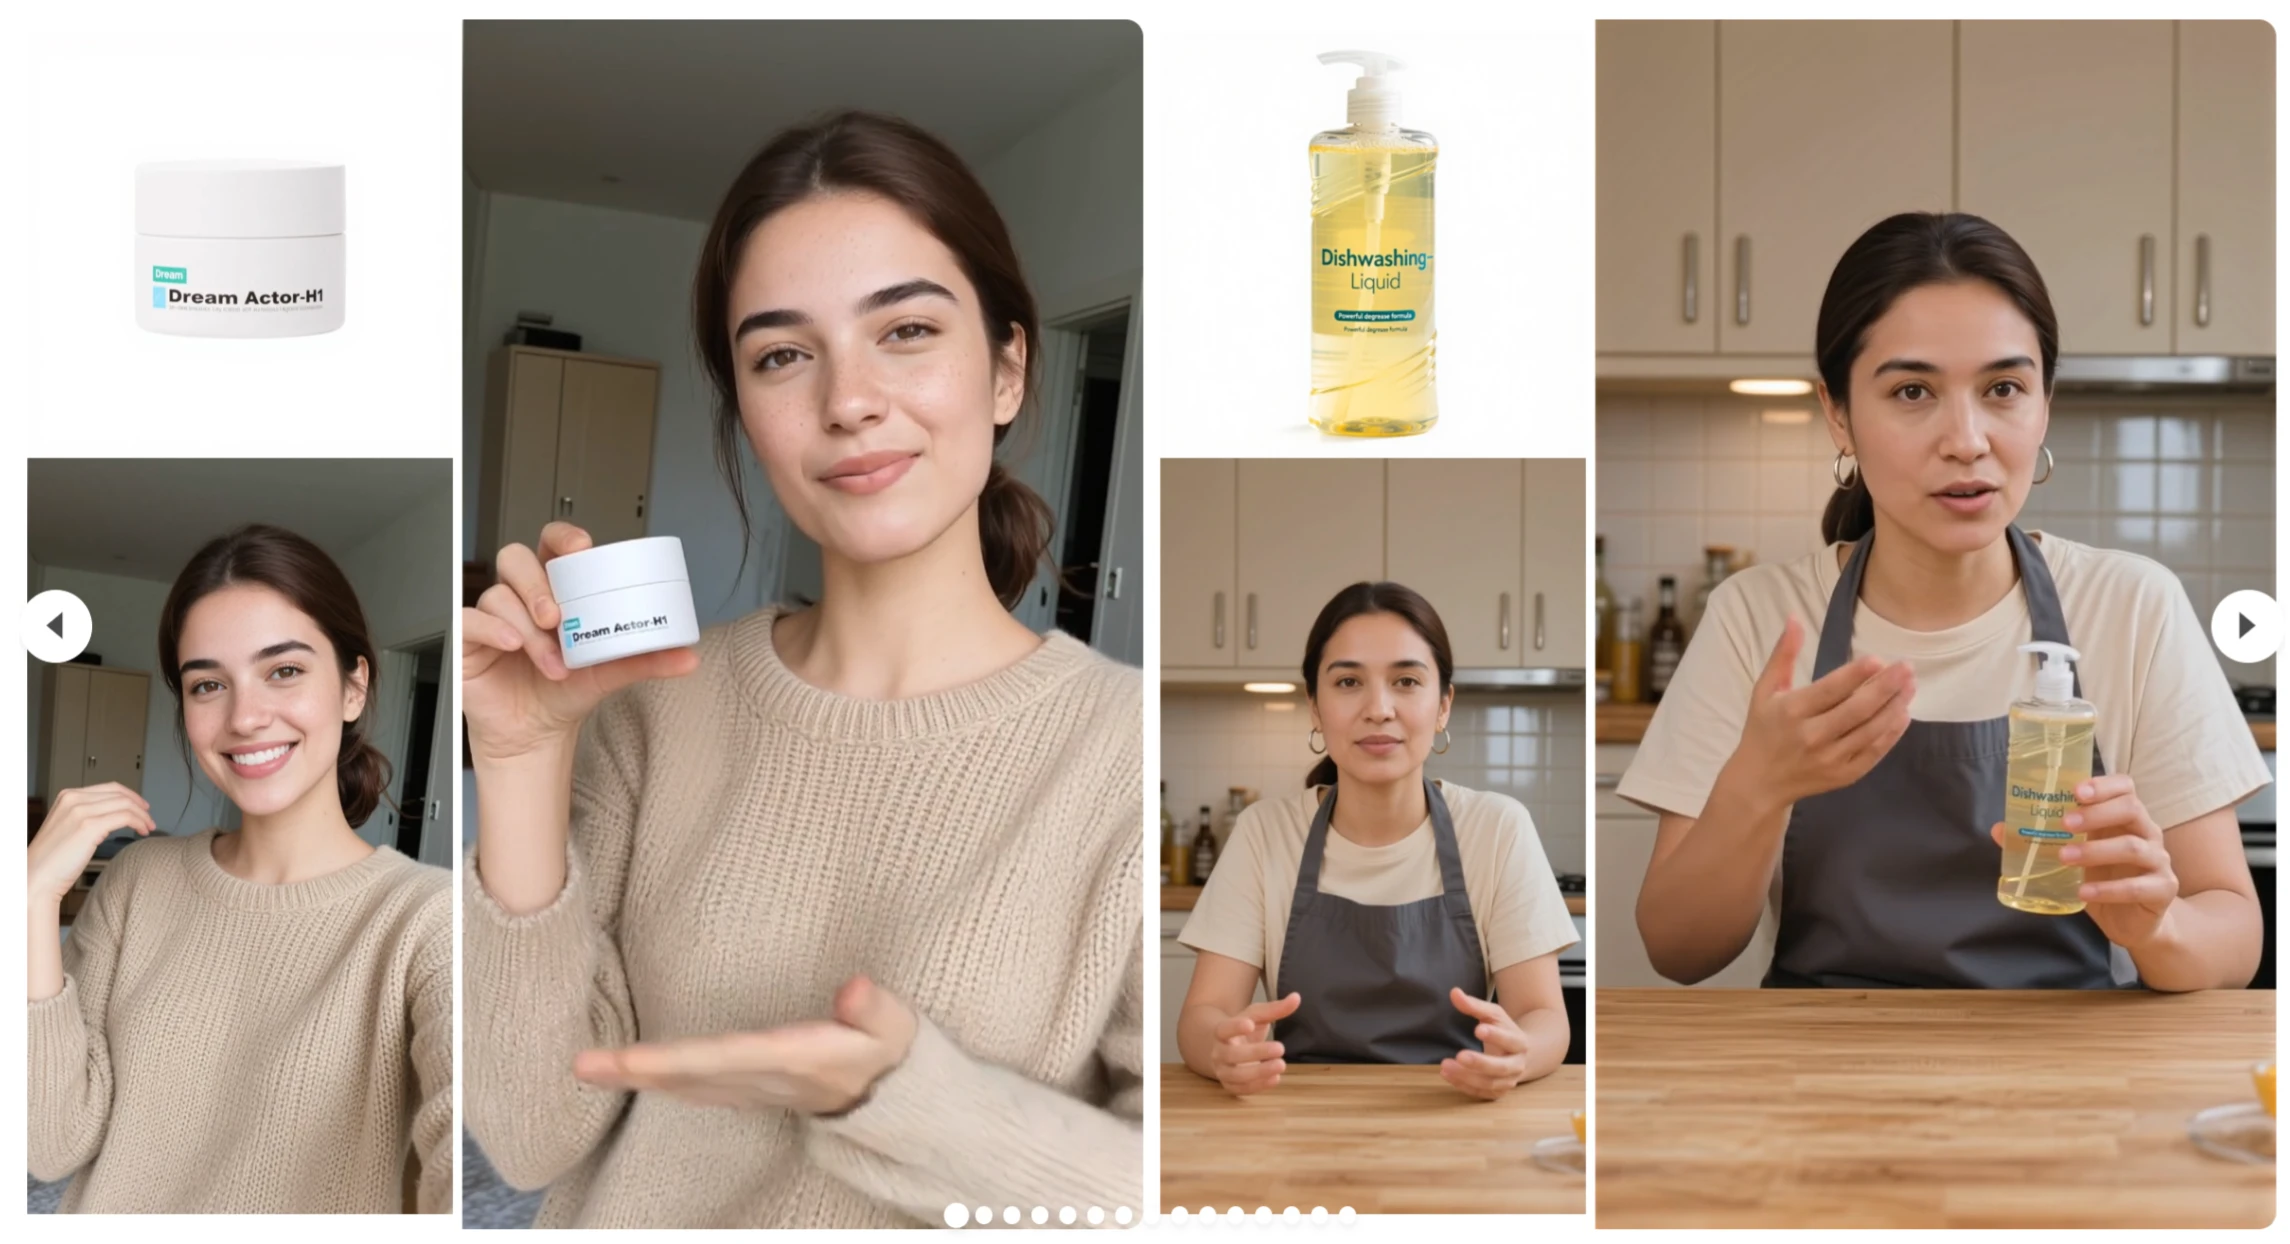
DreamActor-H1의 핵심 장점:
인물-물체 동적 정렬: 손동작과 상품 위치를 자동으로 매칭합니다. 예를 들어 "화장품 집어 들기"를 시연할 때, 손가락과 병몸체의 접촉 지점이 자연스럽게 맞물려 관통이나 어긋남이 발생하지 않습니다. 또한 3D 인체 메시 템플릿과 제품 경계 상자를 함께 사용하여 중력, 파지 각도와 같은 물리적 법칙에 부합하는 동작을 보장합니다.
다차원 디테일 충실도: 인물 정체성 일관성 유지 면에서 헤어스타일, 피부색 등의 특징을 보존하며, 상품의 경우 소재 질감, 로고 마크 등 디테일을 고도로 정밀하게 재현합니다.
시맨틱 강화 3D 일관성: "립스틱 회전展示(전시)" 같은 카테고리 수준의 텍스트 설명을 결합하여 미세한 회전 시 화면이 더 매끄럽게 처리되며, 상품의抖动(떨림)이나 변형 현상을 방지합니다.
기술 원리:
데이터 처리 단계: 비전 언어 모델링(VLM)이 "휴대폰을 들고 뒤집기"와 같은 텍스트 명령을解析(파싱)합니다. 그 다음 자세 추정을 통해 인체 골격을 생성하고, 상품 경계 상자와 결합하여 공간 관계를 구축함으로써 동작 특징을 추출합니다.
모델 아키텍처 설계: 전역 어텐션은 전체 화면의 시계열 일관성을 제어하고, 참조 어텐션은 인물 또는 상품 참조 이미지의 특징을 주입하며, 객체 어텐션은 상품의 잠재 특징을专门(전문화) 처리하여 디테일 손실을 방지합니다. 3중 어텐션 메커니즘의 확산 변환기(DiT)는 70억 파라미터의 기초 모델 Seaweed-7B를 기반으로 하며, 마스크 교차 어텐션을 통해 인물과 물체의 정보를 융합합니다.
추론 최적화: 사전 정의된 동작 템플릿 라이브러리를 동적으로 검색하고, 예를 들어 소형 상품의 경계 상자 크기를 확대하는 등 물체 상자의 스케일링 비율을 조정합니다.
DreamActor-H1의 적용 시나리오:
전자상거래 라이브 방송: 가상 진행자가 상품을手持(손에 들고) 시연하는 비디오를 자동으로 생성하여 라이브 방송 비용을 낮추고 효율성을 높일 수 있습니다.
광고 마케팅: 신발 회전展示(전시) 등 다각도의 제품 사용 애니메이션을 저비용으로 제작하여 소비자의 관심을 유도할 수 있습니다.
DreamActor-H1의 한계:
상품 제한: 현재 중소형 물품만 지원하며, 대형 가전 제품 등은 처리할 수 없습니다.
동작 템플릿 의존성: "탁 위 물건 줍기"와 같은 동작을 사전 정의해야 하며, 초기 인물 자세 매칭에 의존합니다.
동적 결함: 빠른 움직임 시 상품의 질감이 깜빡이는 현상이 나타날 수 있습니다.
DreamActor-H1을 사용한 带货 비디오 생성流程(프로세스):
소재 준비: 인물 이미지 1장과 제품 이미지 1장을 준비합니다. 인물 이미지는 정면 반신 사진을 권장하며, 해상도는 800 * 800 이상이어야 생성된 비디오에서 인물 특징이 선명하게 유지됩니다. 제품 이미지는商标(상표), 질감 등 각 디테일을 선명하게展示(전시)할 수 있어야 합니다.
텍스트 명령 입력:带货 요구 사항에 따라 "휴대폰을 들고 뒤집기", "립스틱 디테일 展示(전시)" 등 관련 카테고리 수준의 텍스트 설명을 입력하여 비디오 생성에 구체적인 동작 및 展示(전시) 요구 사항을 제공합니다.
비디오 생성: 준비된 소재와 텍스트 명령을 DreamActor-H1 시스템에 입력하면, 시스템은 다단계 협업 아키텍처와 혼합 어텐션 메커니즘을 기반으로 처리합니다. 데이터 처리 단계에서 VLM이 텍스트 명령을 파싱하고, 동작 특징 추출 모듈이 자세 추정을 통해 인체 골격을 생성하며 상품 경계 상자와 결합하여 공간 관계를 구축합니다. 모델 아키텍처에서 전역 어텐션, 참조 어텐션, 객체 어텐션이协同(협동)하여 최종적으로 고충실도의 휴먼-머신 인터랙션 데모 비디오를 생성합니다.
프로젝트 주소는 다음과 같습니다:
프로젝트 홈페이지:https://submit2025-dream.github.io/DreamActor-H1/
기술 논문:https://arxiv.org/abs/2506.10568









