
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
GUIRoboTron-Speech: 메이퇀과 저장대학교의 최초 음성 인터랙션 GUI 에이전트
小编 ·

GUIRoboTron-Speech: 메이퇀과 저장대학교의 최초 음성 인터랙션 GUI 에이전트
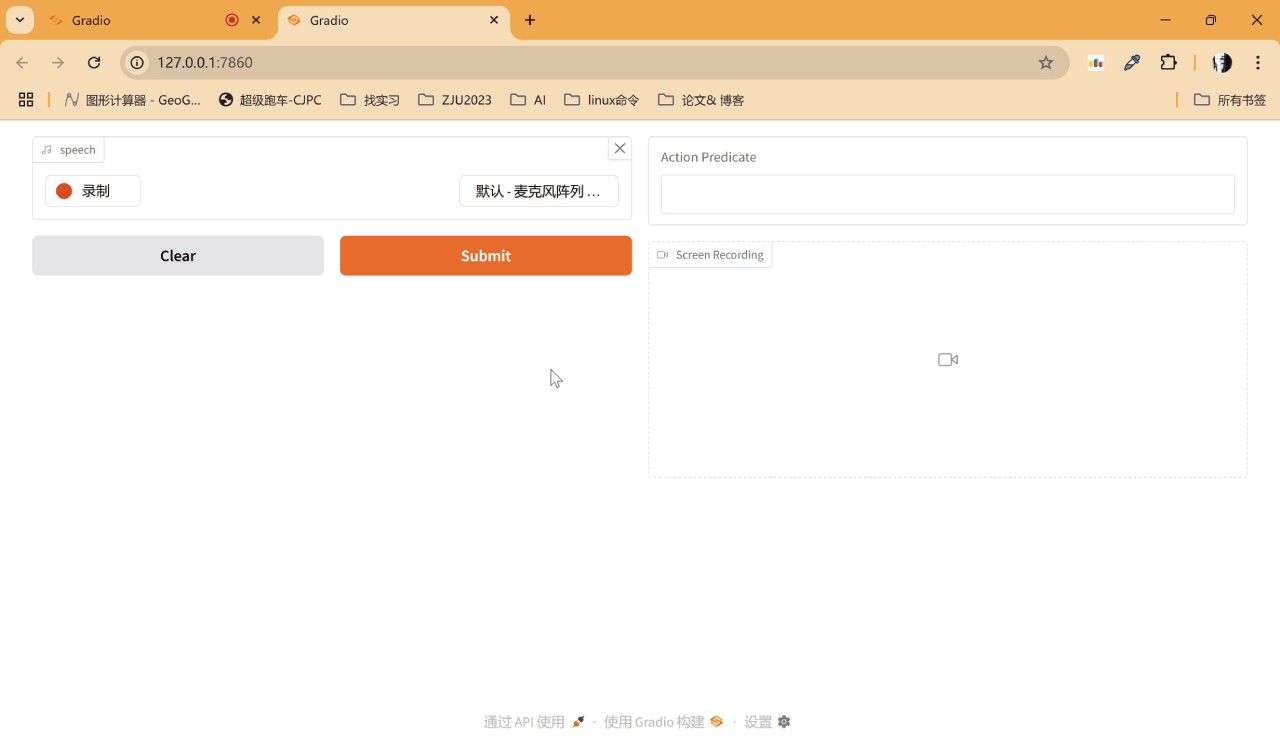
메이투안(美团)과 저장대학교(浙江大学)가 공동 개발한 GUIRoboTron-Speech는 음성 명령과 기기 화면 캡처를 활용해 직접 의사결정을 내릴 수 있는 GUI 에이전트입니다. 사용자가 음성과 기기 화면 캡처를 통해 컴퓨터를 조작할 수 있게 해주며, 전통적인 텍스트 입력의 불편함을 해소합니다.
GUIRoboTron-Speech은 전통적인 텍스트 의존 방식의 한계를 해결했습니다. 연구팀은 고품질 음성 데이터셋을 구축하고, 단계별 학습과 혼합 지시 학습 전략을 통해 이 에이전트를 성공적으로 훈련시켜 여러 작업에서 뛰어난 성능을 발휘하도록 했습니다. 연구 결과, 사용자 의도가 명확할 때 음성 명령이 텍스트 명령보다 작업 완료 성공률이 더 높았으며, 앞으로 복잡한 명령을 처리하는 능력을 지속적으로 향상시킬 계획입니다.
핵심 기능
음성 명령 기반 구동: GUIRoboTron-Speech은 음성 명령과 기기 화면 캡처를 직접 받아 작업을 예측하고 실행할 수 있습니다. 사용자가 직접 텍스트를 입력할 필요 없이 음성만으로 GUI 에이전트를 제어할 수 있습니다.
멀티모달 인터랙션: 음성과 시각이라는 두 가지 모달리티를 결합하여 음성 명령과 GUI 인터페이스 시각 요소 간의 정확한 대응 관계를 이해할 수 있습니다.
연구 개발 방법
데이터셋 생성: 음성 명령 데이터셋이 부족했기 때문에, 연구팀은 최첨단 랜덤 음색 텍스트 음성 변환(TTS) 모델을 사용하여 대규모 텍스트 명령 데이터셋을 다양한 발화 스타일과 음색의 음성 명령 데이터셋으로 변환했습니다.
점진적 학습 프레임워크: 학습은 두 단계로 나뉩니다.
Grounding 단계: 모델이 음성 명령과 GUI 시각 요소 간의 정확한 대응 관계를 학습합니다. 예를 들어 "확인 버튼 클릭"이라는 명령을 이해하고 화면 캡처에서 "확인" 버튼을 찾는 식입니다.
Planning 단계: 모델이 여러 단계로 구성된 복잡한 작업을 수행하는 법을 학습합니다. 예를 들어 "먼저 계정에 로그인한 다음 최신 이메일을 찾아 첨부 파일 열기"와 같은 논리적 추론과 작업 계획 능력을 보여줍니다.
휴리스틱 혼합 지시 학습 전략: 사전 학습된 모델의 모달리티 불균형 문제를 해결하기 위해, 연구팀은 학습 과정에서 음성과 텍스트 명령을 혼합하여 모델이 두 가지 입력을 동등하게 처리하도록 했습니다.
성능
명령 모달리티 비교: ScreenSpot 작업에서 음성 명령만으로 학습한 모델의 평균 grounding 정확도는 텍스트 명령만으로 학습한 모델보다 1.6% 낮았지만, 혼합 지시 전략을 채택한 후에는 정확도가 1.9% 향상되었습니다.
GUI 시각 Grounding: Mobile 및 Web 영역에서 GUIRoboTron-Speech은 음성 명령을 입력으로 사용할 때 텍스트 명령 기반 최첨단 방법과 동등한 성능을 보입니다.
다단계 작업 실행: AndroidControl 및 GUIOdyssey 등 다단계 작업 데이터셋에서 텍스트 명령 기반 최첨단 모델들과 대등한 성능을 보여줍니다.
장점과 의의
인터랙션 편의성 향상: 사용자가 기기를 조작할 때 텍스트를 직접 입력할 필요 없이 음성만으로 다양한 작업을 완료할 수 있어 인터랙션 편의성이 크게 향상됩니다.
응용 시나리오 확장: 이 기술은 일반 사용자의 일상적인 편의 작업뿐만 아니라 운전, 의료 등 양손을 사용해야 하는 특수한 시나리오에도 적용되어 더 안전하고 효율적인 인터랙션 방식을 제공합니다.
기술 발전 촉진: GUIRoboTron-Speech은 GUI 영역에서 음성 인터랙션 기술의 응용에 대한 새로운 아이디어와 방법을 제공하여 관련 기술 발전을 촉진했습니다.
프로젝트 링크
기술 논문:https://arxiv.org/abs/2506.11127
Github 저장소:https://github.com/GUIRoboTron/GUIRoboTron-Speech









