
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
TableRAG: 테이블 이해를 위한 검색 증강 생성 프레임워크
小编 ·

TableRAG: 테이블 이해를 위한 검색 증강 생성 프레임워크
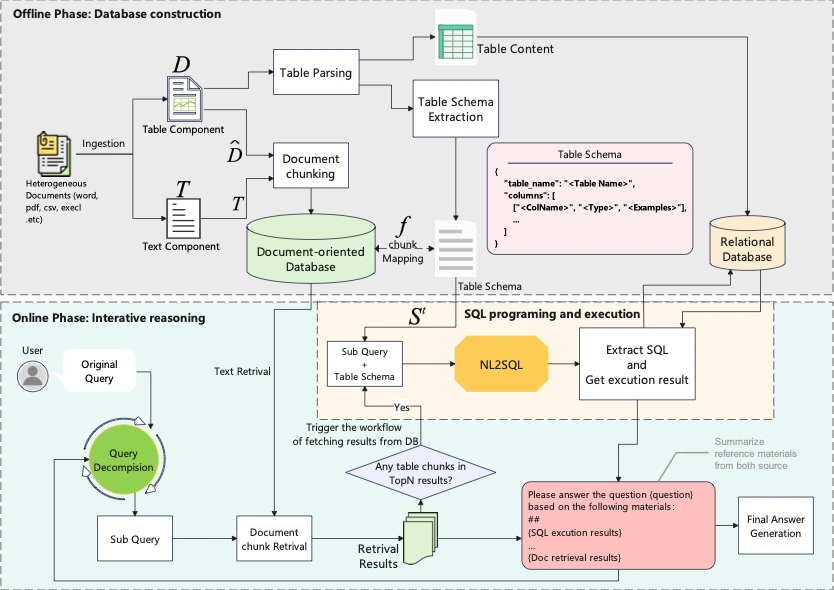
TableRAG는 이종(heterogeneous) 문서 질의응답에서 구조 정보 손실 및 글로벌 뷰 부재 문제를 해결하기 위한 프레임워크입니다. SQL 실행과 텍스트 검색을 결합하여 테이블 데이터를 통합적으로 이해하고 복잡한 작업을 수행할 수 있습니다. 이 프레임워크는 오프라인 데이터베이스 구축과 4단계 온라인 반복 추론 프로세스를 포함합니다. 새로운 벤치마크인 HeteQA와 기타 공개 벤치마크 테스트에서 TableRAG는 탁월한 성능을 보여주었으며, 기존 RAG 및 프로그래매틱(programmatic) 방법들을 능가하여 복잡한 이종 문서 추론을 처리하는 최첨단 솔루션이 되었습니다.
핵심 원리
쿼리 확장 및 검색: TableRAG는 쿼리 확장, 스키마 검색, 셀 검색을 통해 테이블 내 핵심 정보를 파악합니다. 스키마와 셀 값을 대상으로 하는 독립적인 쿼리를 생성하여 단일 쿼리로 인한 중복 정보를 피합니다.
스키마 검색: ai 언어 모델은 열 이름을 통해 핵심 열과 그 데이터 유형을 식별할 수 있으며, 전체 열을 인코딩할 필요가 없습니다. 예를 들어, "지갑의 평균 가격은 얼마인가요?"라는 질문에 대해 언어 모델은 "제품" 및 "가격"과 같은 열 이름 쿼리를 생성합니다.
셀 검색: 언어 모델이 생성한 쿼리를 기반으로 질문과 관련된 열 이름과 셀을 검색합니다. 예를 들어, "지갑"과 관련된 셀 값을 검색합니다.
빈도 인식 절단(frequency-aware truncation): 셀 인코딩 예산 B를 도입하여, 서로 다른 값의 개수가 B를 초과하면 발생 빈도가 가장 높은 상위 B개의 값만 인코딩합니다.
TableRAG주요 모듈
online_inference/main.py: TableRAG의 핵심 추론 코드로, TableRAG 클래스를 포함하며 온라인 추론의 주요 로직을 구현합니다.
offline_data_ingestion_and_query_interface/src/interface.py: Flask 프레임워크를 사용하여 SQL 쿼리 인터페이스를 제공합니다.
online_inference/tools/sql_tool.py: SQL 생성 및 실행을 위한 도구 함수를 포함하며, 재시도(retry) 메커니즘을 지원합니다.
offline_data_ingestion_and_query_interface/src/sql_alchemy_helper.py: SQLAlchemy 데이터베이스 작업을 위한 헬퍼 클래스를 제공하며, 데이터 삽입 및 쿼리를 지원합니다.
offline_data_ingestion_and_query_interface/src/service.py: TableRAG 요청 처리 핵심 로직을 담당하며, LLM으로부터 SQL 문을 가져와 실행하는 작업을 포함합니다.
online_inference/chat_utils.py: LLM 생성 결과를 가져오기 위한 도구 함수를 포함하며, 다양한 API 백엔드를 지원합니다.
offline_data_ingestion_and_query_interface/src/data_persistent.py: DataFrame 열 이름을 정제하는 데 사용되는 도구 함수입니다.
offline_data_ingestion_and_query_interface/src/handle_requests.py: 대형 모델 추론 인터페이스를 호출하며, 예외 처리와 지수 백오프(exponential backoff) 재시도 메커니즘을 포함합니다.
online_inference/tools/retriever.py: 시맨틱 검색 및 혼합 문서 검색 기능을 구현하며, 리콜(recall) 및 리랭킹(reranking)을 포함합니다.
장점
효율적인 데이터 인코딩: 스키마 검색과 셀 검색을 통해 TableRAG는 언어 모델의 입력 길이를 줄여 테이블 크기와 무관하게 만들어 인코딩 효율성을 높이고 계산 비용을 낮춥니다.
정보 손실 감소: 검색된 스키마와 셀만 언어 모델에 제공하여 전체 테이블을 처리할 때 발생하는 핵심 정보 손실을 방지합니다.
추론 능력 향상: TableRAG는 핵심 정보를 제공하여 언어 모델의 테이블 추론 능력을 강화합니다.
TableRAG활용 시나리오
데이터 분석 및 보고서 생성: 대규모 테이블 데이터를 처리해야 하는 시나리오(예: 데이터 분석, 보고서 생성, 재무 보고서 처리)에 적합합니다.
크로스 테이블 질의응답: 테이블 기반 사실 검증, 단일 홉(single-hop) 및 다중 홉(multi-hop) 테이블 질의응답 등의 작업을 처리할 수 있습니다.
실험 검증
연구자들은 Arcade 및 BIRD-SQL 데이터셋을 기반으로 백만 단위 토큰 규모의 벤치마크 테스트를 개발하여 대규모 테이블 이해 작업에서 TableRAG의 성능을 평가했습니다. 실험 결과는 TableRAG가 검색 품질과 대규모 테이블 이해 성능 면에서 기존 방법보다 우수함을 보여주었습니다.
프로젝트 링크
Github:https://github.com/yxh-y/TableRAG









