
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
VRAG-RL: 알리바바 통의팀이 발표한 시각 인식 기반 RAG 프레임워크
小编 ·

VRAG-RL: 알리바바 통의팀이 발표한 시각 인식 기반 RAG 프레임워크
VRAG-RL이란 무엇인가?
VRAG-RL은 알리바바 통의(Tongyi) 팀이 최근에 출시한 시각 인식 RAG 프레임워크 기반 모델입니다. 이 모델은 Qwen2.5-VL-3B에서 성능이 30% 향상되었으며, Qwen2.5-VL-7B에서는 20% 향상되었습니다.
VRAG-RL은 강화 학습 학습을 통해 모델이 다단계 사고 및 추론 능력을 갖추도록 하여 시각 언어 모델(VLM)에 대한 이해력과 답변 정확성을 점진적으로 강화합니다. 시각 인식 동작 공간을 정의하여 모델이 거친 수준에서 미세한 수준까지 정보 밀집 영역에 초점을 맞추고, 핵심 시각 정보를 정확하게 추출하여 VLM의 시각 정보 검색, 추론 및 이해 능력을 향상시킵니다.
또한 VRAG-RL은 멀티모달 검색 및 반복 추론 능력을 갖추고 있어, 다轮 상호작용을 통해 시각 정보에 대한 이해를 점진적으로 개선하고, 최종적으로 정확하고 포괄적인 답변을 생성합니다. 이미지 이해, 차트 분석, 복잡한 레이아웃 파싱 등 다양한 시각 작업에 적용할 수 있습니다.
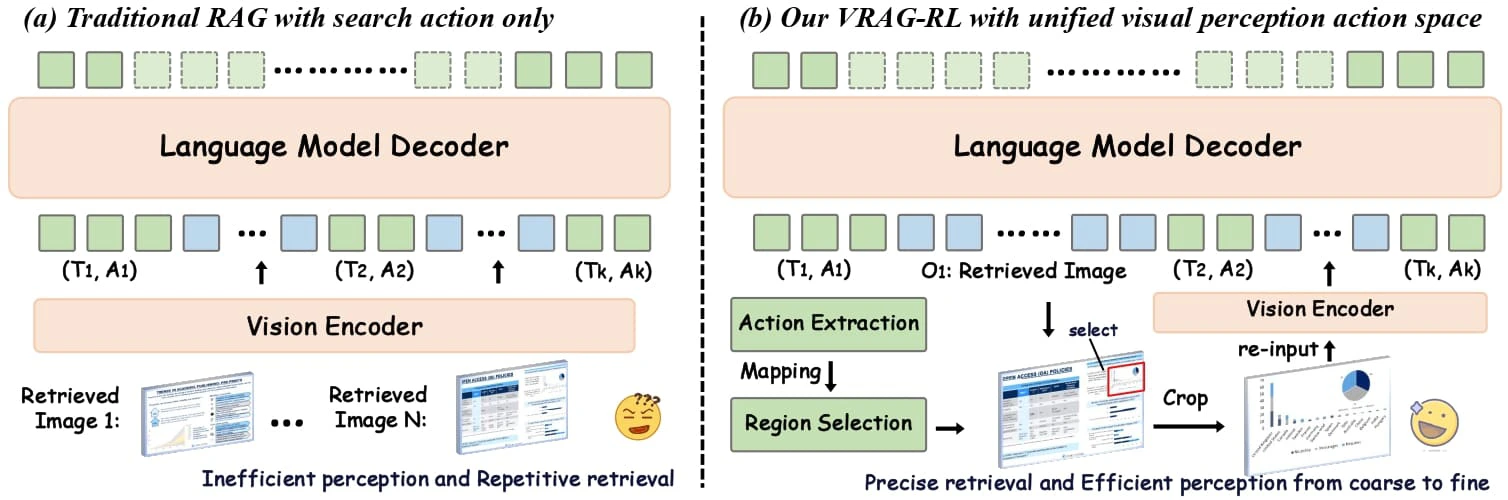
기존 RAG 방법의 한계
시각 정보 처리 능력 부족: 이미지의 정보를 효과적으로 파싱할 수 없으며, 시각 데이터에 대한 이해 및 추론 능력이 부족합니다.
고정된 프로세스로 인한 동적 추론 제한: 대부분 고정된 검색-생성 프로세스를 채택하여 복잡한 작업에서 추론 경로를 동적으로 조정하기 어려워, 모델이 시각 정보를挖掘하는 능력이 제한됩니다.
검색 효율성과 추론 깊이 부족: 복잡한 시각 작업을 처리할 때 핵심 정보를 효율적으로 찾아내지 못해 생성된 결과가 충분히 정확하지 않은 경우가 많습니다.
VRAG-RL의 핵심 혁신
시각 인식 동작 공간: 영역 선택, 크롭, 확대/축소 등 다양한 시각 인식 동작을 도입하여 모델이 거친 단계에서 미세한 단계까지 정보 밀집 영역에 점진적으로 초점을 맞추고, 핵심 시각 정보를 정확하게 추출할 수 있도록 합니다. 이러한 거친 단계에서 미세한 단계로의 인식 방식은 모델의 시각 정보 이해 능력을 향상시킬 뿐만 아니라 검색 효율성도 크게 높입니다.
강화 학습 프레임워크: 강화 학습(RL)을 통해 모델의 추론 및 검색 능력을 최적화합니다. 모델은 검색 엔진과 다轮 상호작용하며 단일 또는 다轮 추론 경로를自主적으로 샘플링하고, 샘플을 기반으로 지속적으로 최적화합니다.
종합 보상 메커니즘: 검색 효율성 보상, 모드 일관성 보상, 모델 기반 결과 보상을 포함한 종합 보상 함수를 설계했습니다. 이러한 보상 메커니즘은 최종 결과에 주목하면서 검색 과정을 최적화하여 모델이 관련 정보를 보다 효과적으로 획득하도록 합니다.
다중 전문가 샘플링 전략: 대규모 모델의 추론 능력과 전문가 모델의 정밀한 주석 능력을 결합하여 모델이 보다 효과적인 시각 인식 전략을 학습할 수 있도록 합니다.
다轮 상호작용 학습: 다轮 상호작용 학습 전략을 기반으로, 모델은 외부 환경과의 지속적 상호작용을 통해 추론 과정을 점진적으로 최적화하여 추론의 안정성과 일관성을 향상시킵니다.
VRAG-RL의 기술적 장점
성능 향상: 실험 결과에 따르면 VRAG-RL은 여러 시각 언어 벤치마크 데이터셋에서 기존 방법을 크게 능가하는 성능을 달성했습니다. 작업 유형은 단일 홉에서 다중 홉 추론, 순수 텍스트 이해에서 차트 인식 및 복잡한 레이아웃 파싱에 이르기까지 다양한 시각이 풍부한 시나리오를 포괄합니다.
다轮 상호작용 지원: 추론 단계에서 정보 밀집 영역에 점진적으로 초점을 맞춰 거친 단계에서 미세한 단계로 정보를 획득할 수 있습니다.
효율적인 학습: 업계 선도적인 GRPO 알고리즘을 도입하고, 로컬에 배포된 검색 엔진을 통해 실제 응용 시나리오를 시뮬레이션하여 검색 엔진 호출 비용을 제로로 만들고, 모델 학습을 더욱 효율적으로 만듭니다.
VRAG-RL의 응용 시나리오
복잡한 차트 분석: 재무 보고서 및 과학 차트에서 핵심 데이터 추출.
디자인 시안 파싱: 디자인 시안의 레이아웃과 요소 이해 및 추론.
문서 검색: 이미지, 표가 포함된 문서 지식 베이스에서 정보 효율적으로 검색.
멀티모달 질의응답: 텍스트와 이미지를 결합한 다중 홉 추론으로 복잡한 질문에 답변.
프로젝트 링크
GitHub 저장소:https://github.com/Alibaba-NLP/VRAG
HuggingFace 모델 라이브러리:https://huggingface.co/collections/autumncc/vrag-rl
arXiv 기술 논문:https://arxiv.org/pdf/2505.22019









