
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Alibaba, QwenLong-L1-32B 출시: 장문 컨텍스트 추론용 LLM
小编 ·

Alibaba, QwenLong-L1-32B 출시: 장문 컨텍스트 추론용 LLM
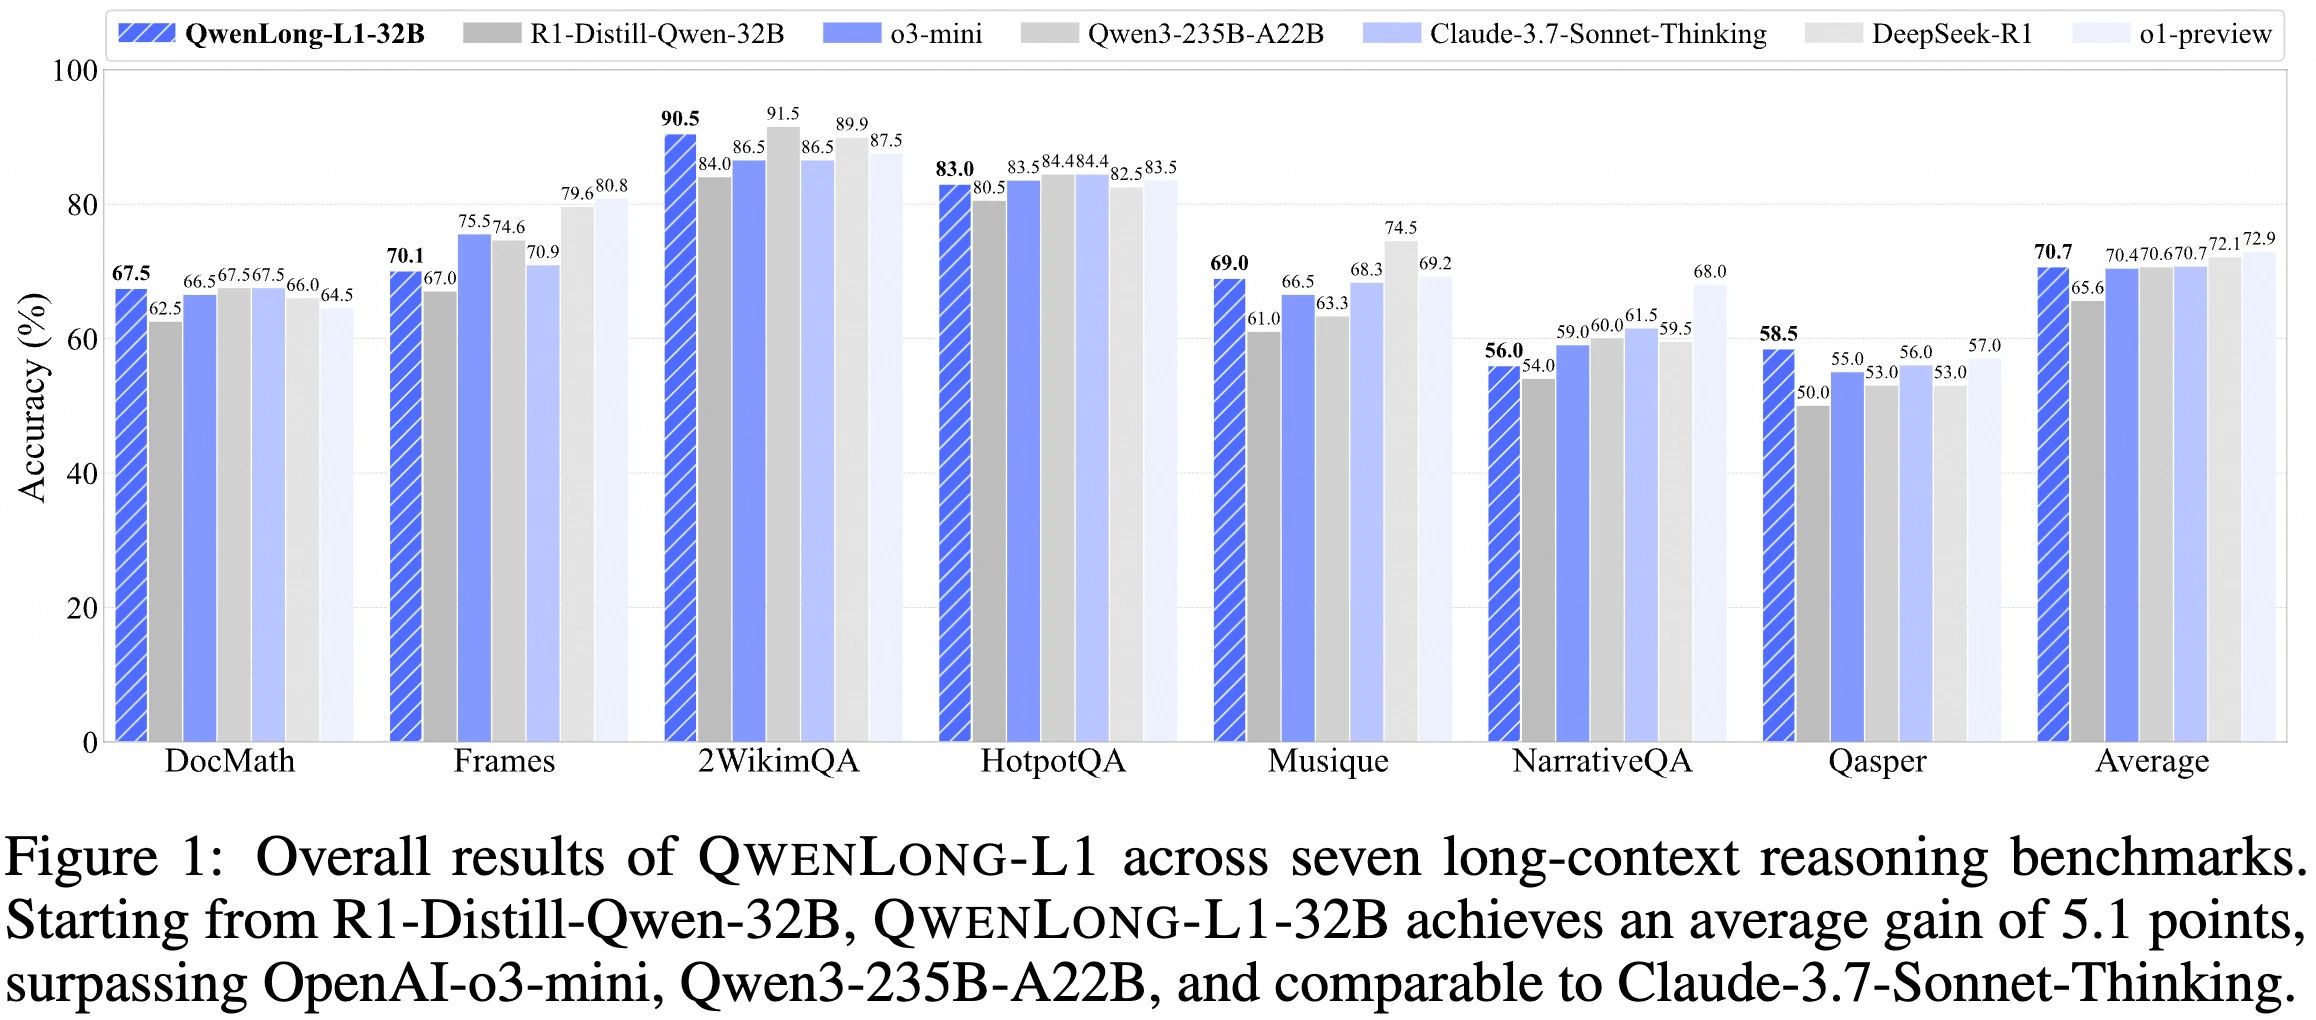
2025년 5월 26일, 알리바바 팀은 QwenLong-L1-32B를 출시했습니다. 이는 강화 학습 기반으로 학습된 최초의 장문 맥락 대형 추론 모델이며, 1,600개의 수학, 논리, 다중 도약 추론 유형의 문서 질의응답 문제를 포함하는 DocQA-RL-1.6K 데이터셋도 함께 공개했습니다. 해당 프레임워크는 사전 워밍업 지도 미세 조정, 커리큘럼 기반 단계별 강화 학습, 난이도 인식 회고 샘플링 메커니즘을 통해 장문 맥락 추론 강화 학습에서 발생하는 낮은 학습 효율과 불안정한 최적화 과정 문제를 해결하였으며, 7개의 장문 맥락 DocQA 벤치마크 테스트에서 Openai-o3-mini 및 Qwen3-235B-A22B보다 우수한 성능을 보이고 Claude-3.7-Sonnet-Thinking과 동등한 수준을 달성했습니다.
모델 프레임워크
핵심 개념: 강화 학습(RL)을 통해 단문 맥락 대규모 추론 모델(LRMs)을 장문 맥락 시나리오에 적응시키는 것입니다.
주요 구성 요소:
사전 워밍업 지도 미세 조정(SFT) 단계: 안정적인 초기 정책을 수립합니다.
커리큘럼 기반 단계별 강화 학습 기법: 정책 진화를 안정화합니다.
난이도 인식 회고 샘플링 전략: 정책 탐색을 촉진합니다.
학습 데이터
DocQA-RL-1.6K라는 전용 강화 학습 학습 데이터셋이 사용되었으며, 여기에는 수학, 논리, 다중 도약 추론 영역을 다루는 1,600개의 문서 질의응답 문제가 포함되어 있습니다.
성능
7개의 장문 맥락 문서 질의응답 벤치마크 테스트에서 QwenLong-L1-32B는 OpenAI-o3-mini 및 Qwen3-235B-A22B와 같은 플래그십 LRM들을 능가하는 성능을 보였으며, Claude-3.7-Sonnet-Thinking과 동등한 수준에 도달하여 현재 최첨단 LRM들 중에서도 선도적인 성능을 보여주었습니다.
실험 설계
수학, 논리, 다중 도약 추론 영역을 다루는 1,600개의 문서 질의응답 문제를 포함하는 전용 RL 학습 데이터셋 DocQA-RL-1.6K를 구축했습니다.
수학 추론 부분에는 DocMath 데이터셋의 600개 문제가 사용되었으며, 이 중 75%는 학습용, 25%는 평가용으로 사용되었습니다.
논리 추론 부분은 DeepSeek-R1을 통해 합성된 600개의 객관식 문제로 구성되었으며, 법률, 금융, 보험, 생산 분야의 실제 문서를 다룹니다.
다중 도약 추론 부분은 MultiHopRAG와 Musique에서 각각 200개의 예제를 샘플링하여, 문서 간 추론을 강조합니다.
2WikiMultihopQA, HotpotQA, Musique, NarrativeQA, Qasper, Frames, DocMath 등 7개의 장문 맥락 DocQA 벤치마크 테스트에서 평가되었습니다.
결과 및 분석
QwenLong-L1-32B는 7개의 장문 맥락 DocQA 벤치마크 테스트에서优异的한 성능을 보이며 OpenAI-o3-mini 및 Qwen3-235B-A22B와 같은 플래그십 LRM 모델들을 능가했고, Claude-3.7-Sonnet-Thinking과 동등한 성능을 달성했습니다.
수학 추론 벤치마크 DocMath에서 QwenLong-L1-32B의 완전일치 및 LLM 판단 정확률은 85.3%에 달했습니다.
다중 도약 추론 벤치마크 HotpotQA에서 모델의 성능은 87.6%에 도달하여 기존 모델을显著히 능가했습니다.
프로젝트 링크
Github:https://github.com/Tongyi-Zhiwen/QwenLong-L1
Huggingface:https://huggingface.co/Tongyi-Zhiwen/QwenLong-L1-32B
Modelscope:https://www.modelscope.cn/models/iic/QwenLong-L1-32B









