
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
ParseStudio: PDF 파싱을 간소화하는 Python 라이브러리
小编 ·

ParseStudio: PDF 파싱을 간소화하는 Python 라이브러리
ParseStudio란 무엇인가요?
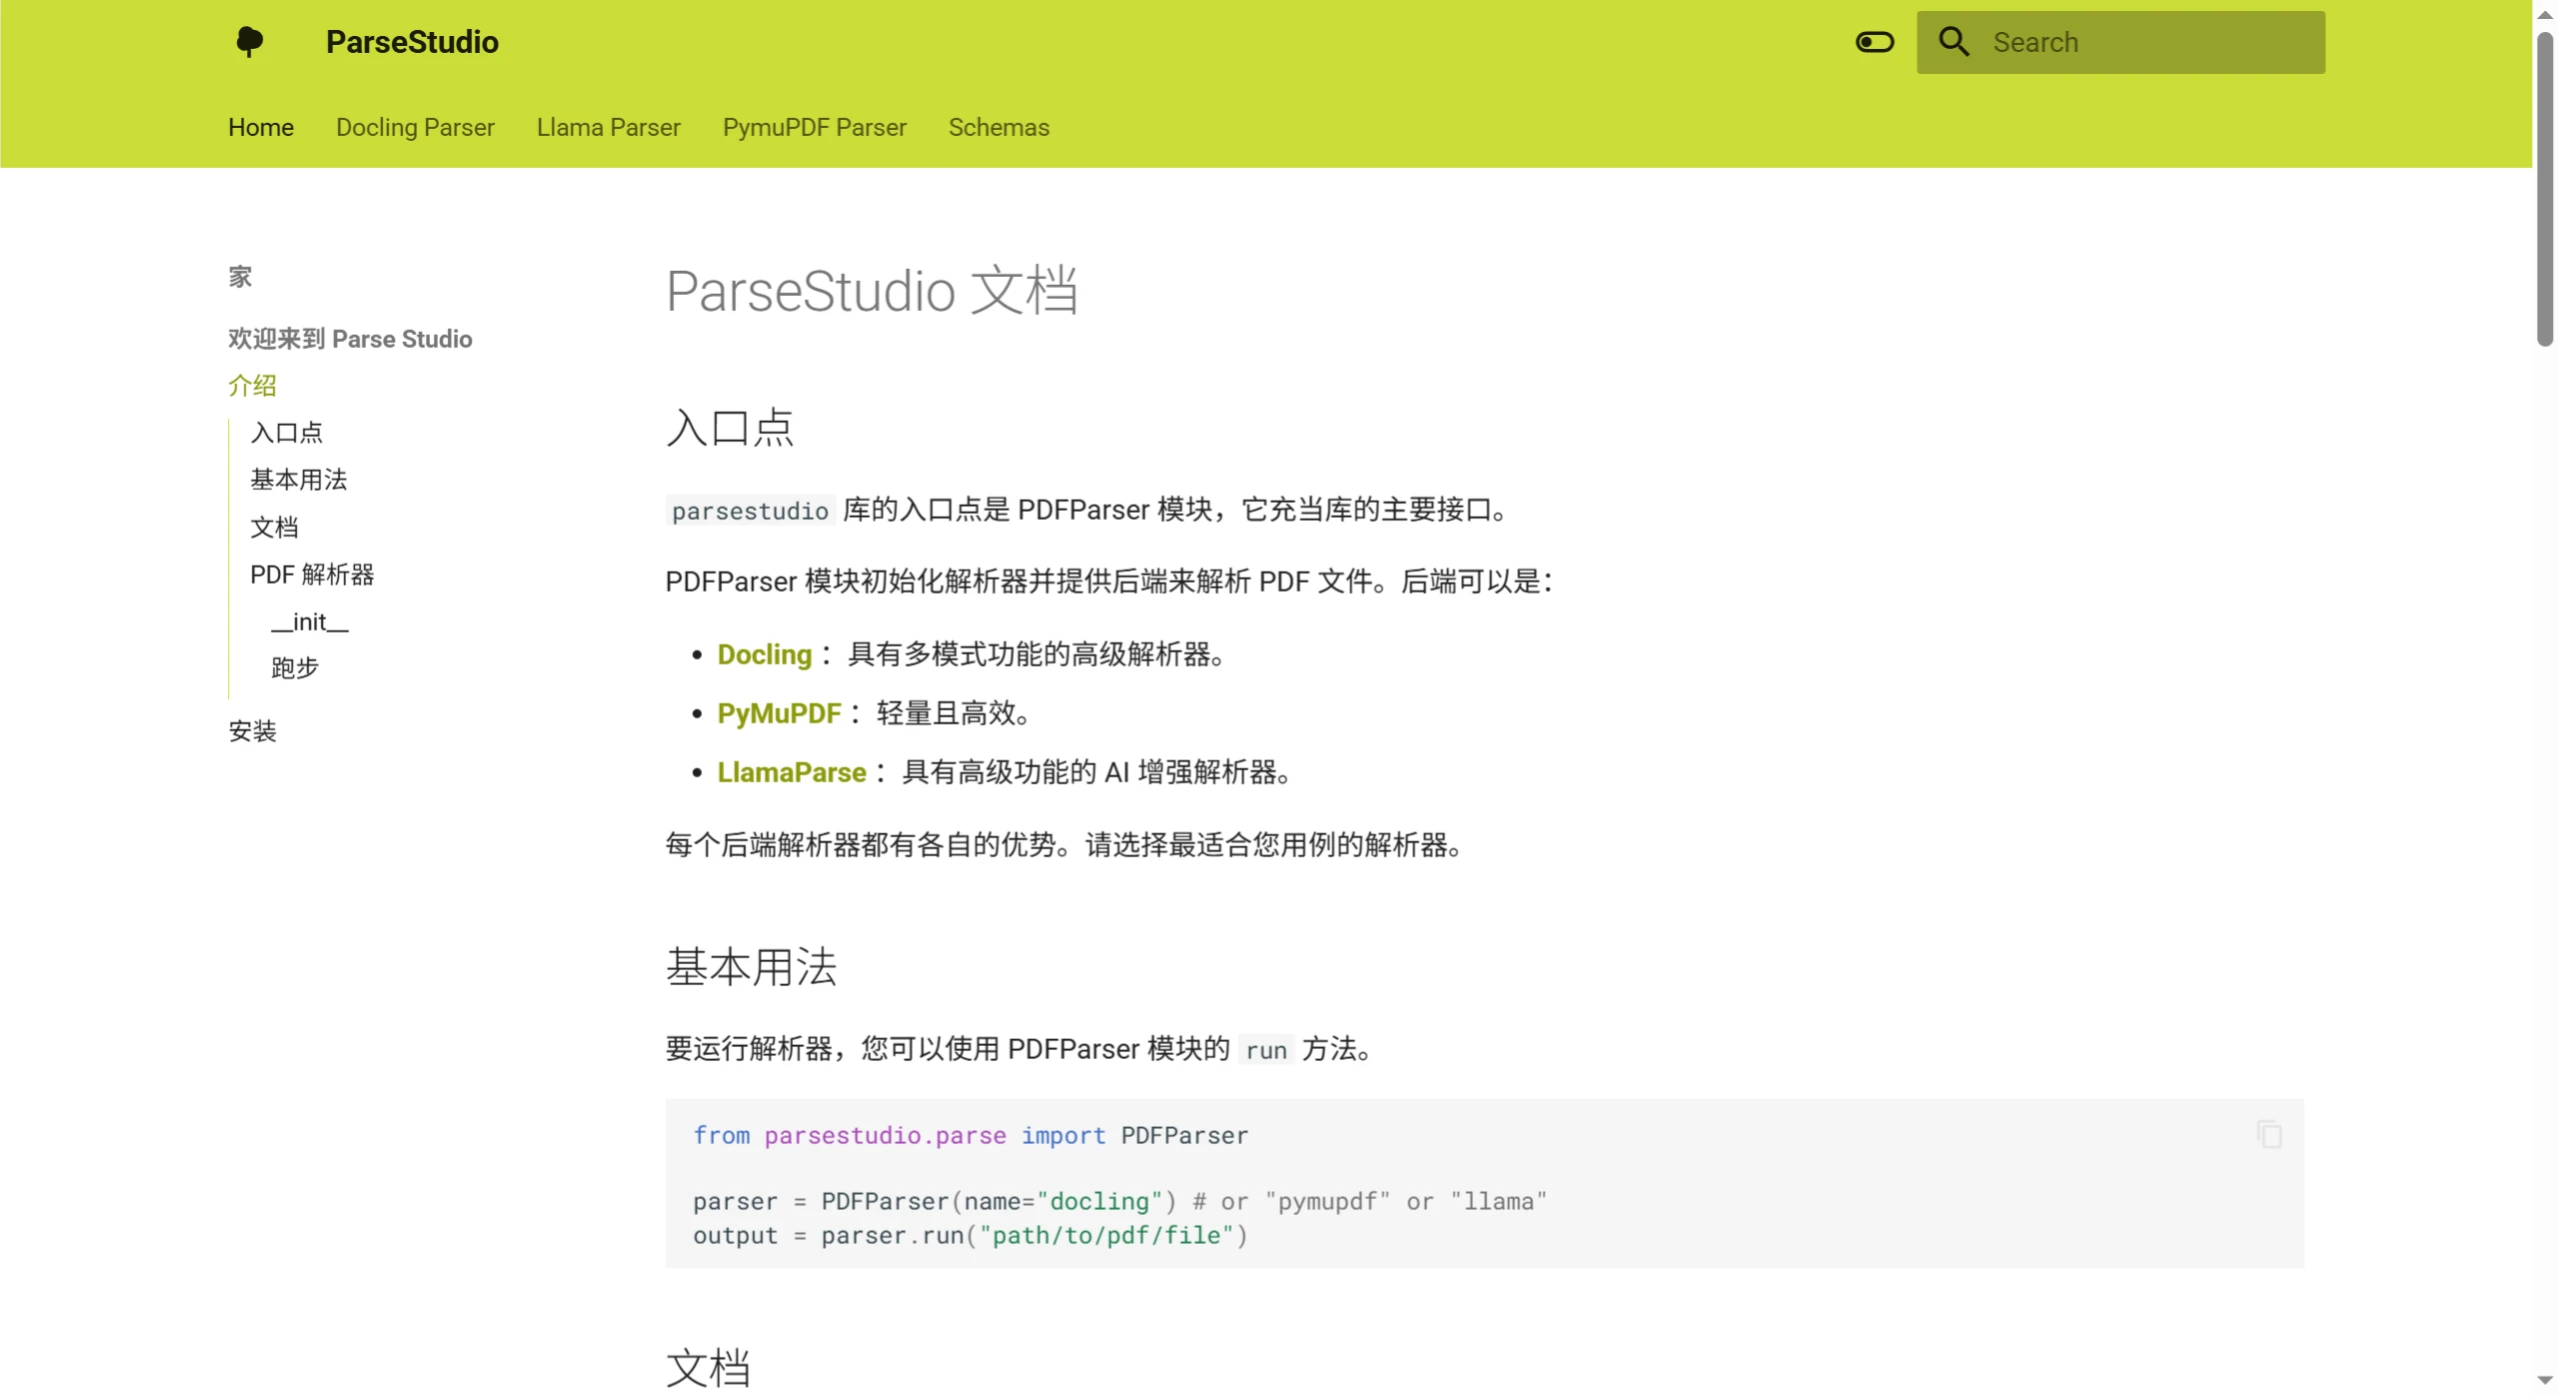
PDF 문서를 처리할 때 텍스트, 표, 이미지를 추출하는 작업은 종종 번거롭고, 라이브러리마다 사용법이 달라 코드가 중복되고 관리하기 어려워집니다. ParseStudio는 이런 문제를 해결하는 Python 라이브러리로, 여러 파서를 하나의 통합된 인터페이스로 묶어 단 몇 줄의 코드만으로 PDF 문서를 파싱할 수 있도록 합니다. 이 라이브러리는 Docling, PyMuPDF, Llama Parse라는 세 가지 엔진을 통합하여 텍스트, 표, 이미지 추출 작업을 유연하게 처리합니다. ParseStudio의 주요 특징으로는 모듈식 설계, 여러 유형의 콘텐츠를 동시에 추출 가능, 간결한 API 설계, 표를 자동으로 Markdown 형식으로 변환, 이미지 추출 시 메타데이터 포함, 여러 PDF 파일의 일괄 처리 지원 등이 있습니다. 어느 정도 Python 기반이 있는 개발자에게 ParseStudio는 실용적인 도구입니다.
ParseStudio의 주요 특징
모듈식 설계: Docling, PyMuPDF, Llama Parse 등 다양한 파싱 백엔드 중에서 선택하여 다양한 요구 사항을 충족할 수 있습니다.
멀티모달 파싱: 텍스트, 표, 이미지를 끊김 없이 추출할 수 있습니다.
통일된 구문: 통일된 인터페이스를 제공하여 다양한 백엔드와의 상호작용을 단순화합니다.
확장성: 추가 매개변수를 통해 파싱 동작을 쉽게 조정할 수 있습니다.
사용자 친화적: 백엔드별 복잡성을 추상화하여 사용자가 콘텐츠 추출에 집중할 수 있도록 합니다.
ParseStudio 설치 방법
pip을 사용한 설치:
pip install parsestudio
소스 코드로부터 설치:
git clone https://github.com/chatclimate-ai/ParseStudio.git
cd ParseStudio
pip install .
ParseStudio 빠른 시작
파서 가져오기 및 초기화:
from parsestudio.parse import PDFParser
# 필요한 파서 백엔드로 초기화
parser = PDFParser(parser="docling")  # 옵션: "docling", "pymupdf", "llama"
PDF 파일 파싱:
outputs = parser.run(["path/to/file.pdf"], modalities=["text", "tables", "images"])
# 텍스트 콘텐츠 접근
print(outputs[0].text)
# 표 접근
for table in outputs[0].tables:
print(table.markdown)
# 이미지 접근
for image in outputs[0].images:
image.image.show()
metadata = image.metadata
print(metadata)
지원되는 파서
Docling: 복잡한 문서의 세부 레이아웃 분석에 적합하며, OCR과 정밀한 표 추출을 지원합니다.
PyMuPDF: 경량이며 효율적이어서 빠른 처리에 적합합니다.
LlamaParse: 클라우드 기반이며 AI로 강화된 추출 기능을 제공하여 고급 기능이 필요한 시나리오에 적합합니다.
Github:https://github.com/chatclimate-ai/ParseStudio









