
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
AniSora: bilibili가 오픈 소스로 공개한 애니메이션 영상 생성 모델
小编 ·

AniSora: bilibili가 오픈 소스로 공개한 애니메이션 영상 생성 모델
AniSora란 무엇인가요?
AniSora는 빌리빌리(Bilibili)가 2025년 5월 12일에 오픈소스로 공개한 AI 애니메이션 비디오 생성 시스템입니다. 다양한 스타일의 애니메이션 비디오를 손쉽게 생성할 수 있으며, 예를 들어 일본 애니메이션 클립, 중국 국산 애니메이션, 만화 원작改编, VTuber 콘텐츠, 애니메이션 PV, 그리고 귀축(鬼畜) 비디오 등을 만들 수 있습니다. 이 시스템은 캐릭터 이미지와 동작의 부드러움을 유지하는 데 있어 뛰어난 성능을 보여주며, 현재 가장 진보된 애니메이션 비디오 생성 모델이라 할 수 있습니다.
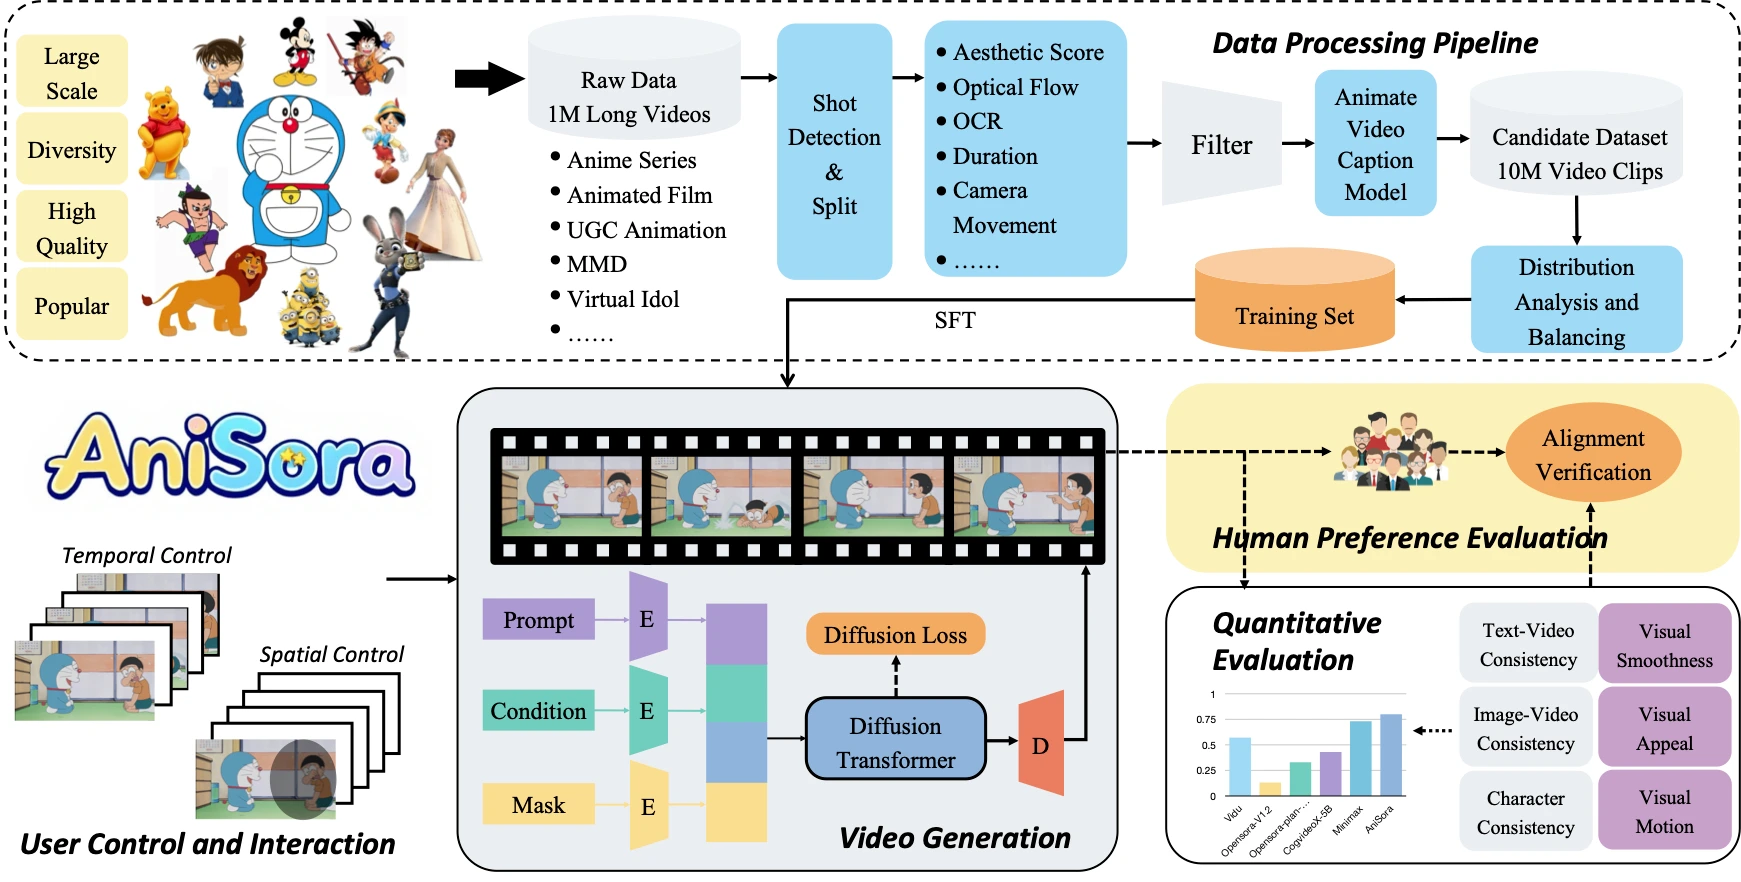
AniSora 기능
이미지 투 비디오 생성: 단일 이미지를 기반으로连贯한 애니메이션 비디오를 생성하여, 정적 화면을 동적 장면으로 확장하는 데 적합합니다.
프레임 보간: 키프레임 보간을 지원하며, 중간 프레임을 생성하여 부드러운 전환을 구현함으로써 애니메이션 제작 시 수작업 부담을 줄여줍니다.
부분 이미지 가이드: 사용자가 특정 영역을 지정하여 애니메이션을 생성할 수 있도록 지원합니다.
시공간 제어: 시간과 공간의 제어 능력을 결합하여, 첫 프레임, 마지막 프레임, 다중 프레임 가이드 등 다양한 방식을 지원함으로써 정밀한 애니메이션 제작을 실현합니다.
AniSora 모델 특징
맞춤형 최적화: 자연 영상에 비해 애니메이션 영상은 스타일 면에서 표현력과 추상성이 더 뛰어나며, 전통적인 생성 모델로는 캐릭터의 표정, 동작 리듬, 과장된 카메라 워크를 정확하게 재현하기 어려운 경우가 많습니다. AniSora는 이러한 특성에 맞춘 최적화를 진행하여, 창의적 표현을 훼손하지 않으면서 비디오 생성 효율을 높이는 것을 목표로 합니다.
다양한 스타일 지원: 시리즈물, 중국 오리지널 애니메이션, 만화 원작改编, VTuber 콘텐츠, 애니메이션 PV, 심지어 귀축(鬼畜) 창작까지 다양한 스타일의 비디오 클립을 원클릭으로 생성할 수 있습니다.
낮은 진입 장벽의 창작: 실제 제작 니즈가 있는 개인이나 스튜디오에게 AniSora는 매우 매력적인 창작 도구입니다.
AniSora 핵심 모듈
데이터 처리 파이프라인: 1,000만 개 이상의 고품질 텍스트-비디오 데이터 쌍을 전처리하여, 학습을 위한 견고한 기반을 마련했습니다.
제어 가능한 생성 모델: 시공간 마스크 모듈을 도입하여 이미지 투 비디오, 키프레임 보간, 부분 이미지 가이드 등의 기능을 지원하며, 다양한 창작 니즈에 적응할 수 있습니다.
평가 체계: 948개의 다양한 애니메이션 클립으로 구성된 평가 데이터셋을 구축하고, 이중 맹검 인원 평가와 VBench 채점 시스템을 결합하여 인물 일관성, 동작 연결 등 여러 차원에서 점수를 매깁니다.
AniSora 기술 원리
확산 모델(Diffusion Model): 확산 모델 아키텍처를 기반으로, 점진적으로 노이즈를 제거하여 고품질의 비디오 콘텐츠를 생성합니다.
시공간 마스크 모듈(Spatiotemporal Mask Module): 생성 과정에서 특정 시공간 영역을 제어할 수 있도록 지원합니다. 예를 들어, 어떤 프레임이나 어떤 영역에 애니메이션을 생성할지 마스크로 지정함으로써 부분 가이드 및 키프레임 보간 등의 기능을 실현합니다.
3D 인과 변분 오토인코더(3D Causal VAE): 비디오의 시공간 특징을 인코딩 및 디코딩하는 데 사용되며, 비디오를 저차원 잠재 공간으로 압축하여 계산 복잡도를 낮추는 동시에 핵심적인 시공간 정보를 보존합니다.
Transformer 아키텍처: Transformer의 강력한 모델링 능력을 결합하여, 어텐션 메커니즘을 기반으로 비디오 내 복잡한 시공간 의존 관계를 포착합니다. 이를 통해 모델은 장거리 시퀀스 데이터를 처리하고 보다连贯한 비디오 콘텐츠를 생성할 수 있습니다.
지도 학습 미세 조정(Supervised Fine-Tuning): 사전 학습的基础上, 대량의 애니메이션 비디오 데이터를 사용하여 지도 학습 미세 조정을 진행하며, 약한 학습에서 강한 학습으로의 훈련 전략, 다중 작업 학습 등 다양한 전략을 통해 모델의 일반화 능력과 생성 품질을 향상시킵니다.
데이터 처리 파이프라인: 장면 감지, 광학 흐름 분석, 미학 평가 등의 기술을 기반으로, 대량의 원시 애니메이션 비디오에서 고품질의 학습 데이터를 선별하여, 학습 데이터의 품질과 다양성을 보장합니다.
오픈소스 주소
https://github.com/bilibili/Index-anisora/tree/main
https://huggingface.co/IndexTeam/Index-anisora
https://www.modelscope.cn/organization/bilibili-index









