
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
Insert Anything: 얼굴 교체, 의상 변경 등을 지원하는 오픈소스 이미지 편집 프레임워크
小编 ·

Insert Anything: 얼굴 교체, 의상 변경 등을 지원하는 오픈소스 이미지 편집 프레임워크
Insert Anything 소개
Insert Anything은 저장대학교, 하버드대학교, 난양이공대학교가 공동으로 제안한 통합 이미지 삽입 프레임워크로, 참조 이미지의 객체를 대상 장면에 자연스럽게 통합할 수 있으며, 예술 창작, 사실적인 얼굴 스왑, 영화 장면 구성, 가상 의류 착용, 액세서리 커스터마이징, 디지털 소품 교체 등 다양한 실제 응용 시나리오를 지원합니다.
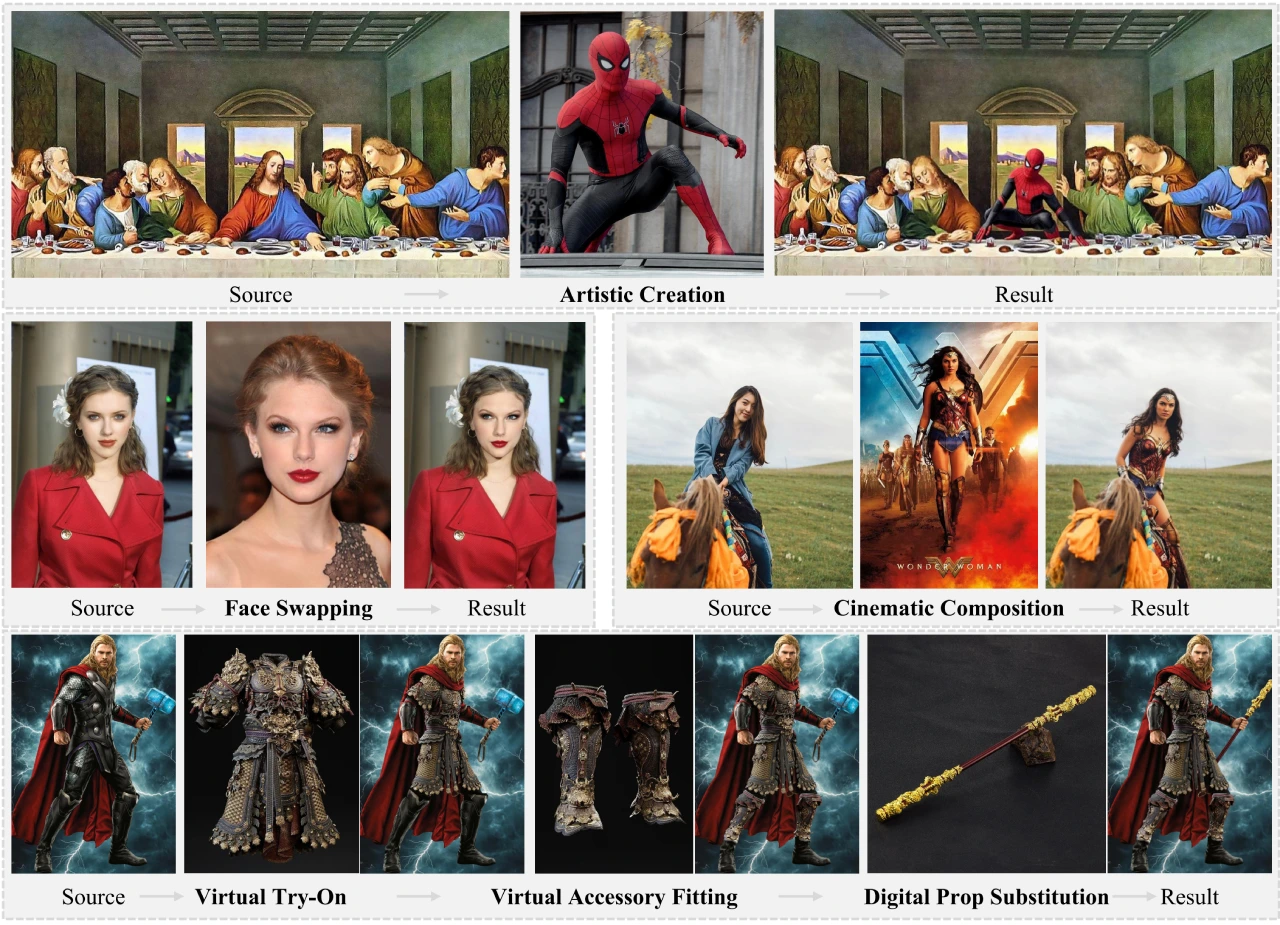
Insert Anything 기술 원리
1. AnyInsertion 데이터셋
규모와 내용: 이 프레임워크는 12만 개의 프롬프트-이미지 쌍을 포함하는 AnyInsertion 데이터셋을 기반으로 하며, 인물, 사물, 의류 삽입 등 다양한 작업을 포괄합니다.
다중 제어 모드: 데이터셋은 마스크 프롬프트(58K 쌍)와 텍스트 프롬프트(101K 쌍)라는 두 가지 제어 모드를 지원하여 모델에 풍부한 학습 샘플을 제공합니다.
2. Diffusion Transformer (DiT)
멀티모달 어텐션 메커니즘: Insert Anything은 DiT의 멀티모달 어텐션 메커니즘을 활용하여 마스크 및 텍스트 기반 편집을 지원합니다. 이 메커니즘은 이미지 분기와 텍스트 분기가 각각 시각적 입력과 텍스트 설명을 처리한 다음 멀티모달 어텐션을 통해 이러한 정보를 융합합니다.
이미지 분기: 참조 이미지, 소스 이미지, 마스크를 처리하여 시각적 특징을 추출하고 노이즈와 연결합니다.
텍스트 분기: 텍스트 설명을 인코딩하여 의미론적 안내를 제공합니다.
3. 컨텍스트 편집 메커니즘
이联화 및 삼联화 프롬프트 전략:
마스크 프롬프트 이联화: 왼쪽은 참조 이미지, 오른쪽은 마스크가 포함된 대상 이미지입니다.
텍스트 프롬프트 삼联화: 왼쪽은 참조 이미지, 가운데는 소스 이미지, 오른쪽은 텍스트로 생성된 결과입니다.
기능: 이 메커니즘은 참조 이미지를 컨텍스트 정보로 취급하여 암묵적 상호작용을 통해 삽입된 요소가 대상 장면과 시각적으로 일관성을 유지하면서 고유한 특징을 보존하도록 합니다.
장점
범용성: 단일 모델이 여러 삽입 작업을 처리할 수 있어 각 작업마다 별도의 모델을 학습할 필요가 없습니다.
유연성: 마스크와 텍스트라는 두 가지 제어 모드를 지원하여 다양한 사용자의 편집 요구를 충족합니다.
시각적 일관성: 컨텍스트 편집 메커니즘을 통해 삽입된 요소가 대상 장면과 자연스럽게 융합되도록 보장합니다.
Insert Anything 응용 시나리오
예술 창작: 예술 요소를 다양한 배경에 자연스럽게 삽입합니다.
상업 광고: 제품 이미지를 광고 장면에 삽입합니다.
대중문화 창작: 대중문화 요소를 관련 장면에 삽입합니다.
프로젝트 링크
프로젝트 홈페이지:https://song-wensong.github.io/insert-anything/
논문:https://arxiv.org/abs/2504.15009
Github:https://github.com/song-wensong/insert-anything









