
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
RealtimeVoiceChat: 실시간 음성 응답을 제공하는 AI 음성 채팅 앱
小编 ·

RealtimeVoiceChat: 실시간 음성 응답을 제공하는 AI 음성 채팅 앱
RealtimeVoiceChat란 무엇인가요?
RealtimeVoiceChat은 음성으로 지능형 시스템과 대화하고 실시간으로 음성 답변을 받을 수 있게 해주는 오픈소스 프로젝트입니다. 네트워크를 통해 오디오 조각을 전송하고, 음성을 텍스트로 변환한 뒤 지능형 시스템이 처리하고, 다시 텍스트를 음성으로 변환합니다. 이 프로젝트는 다양한 지능형 시스템을 지원하며(기본값은 Ollama, Openai도 사용 가능), 음성 스타일을 유연하게 선택할 수 있습니다. 클라이언트-서버 아키텍처를 채택하여 낮은 지연 시간을 최적화했고, 대화 턴을 지능적으로 감지하여 더 자연스러운 대화를 가능하게 합니다. Docker를 사용하여 배포하는 것을 권장하며, CUDA-enabled NVIDIA GPU가 있으면 성능이 더 향상됩니다.
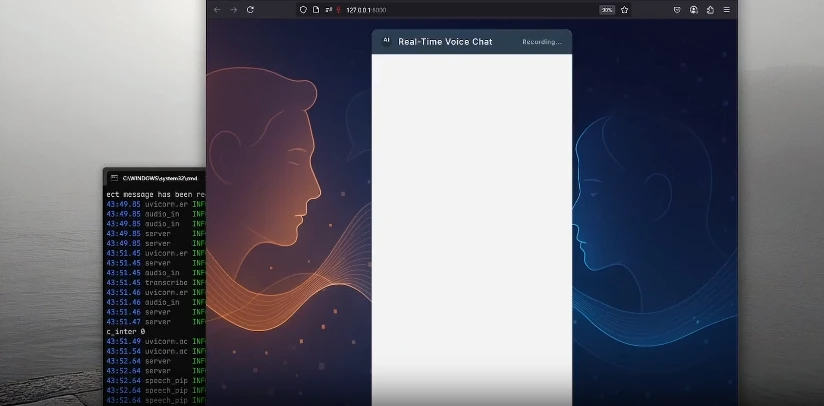
RealtimeVoiceChat 핵심 기능
스트리밍 음성 인터랙션: 사용자 음성이 브라우저에서 캡처되고, WebSockets를 통해 Python 백엔드로 전송되어 실시간으로 텍스트로 전사된 후 LLM에서 처리되고, 텍스트 응답이 다시 음성 스트림으로 변환되어 사용자에게 전송됩니다.
저지연 설계: 오디오 청크 스트리밍을 통해 아키텍처를 최적화하여 대화의 원활한 흐름을 보장합니다.
지능형 턴 감지: 동적 무음 감지를 통해 대화 흐름에 따라 자동으로 발화 권한을 전환합니다.
유연한 AI 백엔드: 다양한 LLM 백엔드를 지원합니다(기본값은 Ollama, OpenAI도 지원).
맞춤형 음성: 다양한 텍스트 음성 변환 엔진(예: Kokoro, Coqui, Orpheus)을 선택할 수 있습니다.
간단한 웹 인터페이스: Vanilla JS와 Web Audio API로 구축된 간단한 사용자 인터페이스.
Docker 기반 배포: 의존성 관리를 용이하게 하기 위해 Docker Compose를 사용한 배포를 권장합니다.
RealtimeVoiceChat 특징
실시간 인터랙션: 사용자는 음성으로 AI와 대화할 수 있으며, AI도 음성 형태로 실시간으로 응답합니다.
다중 컴포넌트 협업: 프로젝트는 프런트엔드의 오디오 처리 및 UI 인터랙션, 그리고 백엔드의 음성 전사, 텍스트 처리 및 음성 합성 기능을 포함합니다.
설정 가능성: 다양한 TTS 엔진과 LLM 모델을 지원하며, 환경 변수를 통해 구성할 수 있습니다.
기술 스택
백엔드: Python 3.x, FastAPI
프런트엔드: HTML, CSS, JavaScript(Vanilla JS, Web Audio API, AudioWorklets)
통신: WebSockets
컨테이너화: Docker, Docker Compose
핵심 AI/ML 라이브러리: RealtimeSTT(음성-텍스트 변환), RealtimeTTS(텍스트-음성 변환), transformers(턴 감지, 토큰화), torch/torchaudio(머신러닝 프레임워크), ollama/openai(LLM 클라이언트)
오디오 처리: numpy, scipy
설치 및 배포
Docker 설치(권장)
프로젝트를 클론하고 디렉터리로 이동합니다.
Docker 이미지를 빌드합니다(기본 이미지를 다운로드하고, Python/ML 의존성을 설치하며, 기본 STT 모델을 미리 다운로드합니다).
서비스를 시작합니다(App과 Ollama).
필요한 Ollama 모델을 가져옵니다(pull).
브라우저를 통해 http://localhost:8000 에 접속하여 음성 채팅을 시작합니다.
수동 설치
Python 가상 환경을 생성하고 활성화합니다.
PyTorch를 설치합니다(하드웨어 구성에 따라).
나머지 의존성을 설치합니다(requirements.txt).
FastAPI 서버를 시작합니다.
브라우저를 통해 http://localhost:8000 에 접속하여 음성 채팅을 시작합니다.
구성 및 맞춤 설정
TTS 엔진 및 음성: server.py 및 audio_module.py에서 구성합니다.
LLM 백엔드 및 모델: server.py 및 llm_module.py에서 구성합니다.
STT 설정: transcribe.py에서 구성합니다.
턴 감지 민감도: turndetect.py에서 구성합니다.
SSL/HTTPS: server.py에서 구성합니다.
프로젝트 주소
GitHub 저장소:https://github.com/KoljaB/RealtimeVoiceChat









