
 대본 기획 도우미▸
 AI 앱
 AI 뉴스
ACE-Step: 새로운 오픈소스 음악 생성 기반 모델
小编 ·

ACE-Step: 새로운 오픈소스 음악 생성 기반 모델
ACE-Step란 무엇인가요?
ACE-Step은 ACE Studio와 StepFun이 공동 개발한 새로운 유형의 오픈소스 음악 생성 기반 모델로, 확산 기반 생성 기술, Sana의 심층 압축 자동 인코더, 경량 선형 변환기를 통합하여 기존 음악 생성 방법이 생성 속도, 음악의 일관성, 제어성 측면에서 가진 한계를 극복했습니다. 이 모델은 A100 GPU에서 20초 이내에 최대 4분 길이의 음악을 합성할 수 있으며, LLM 기반 베이스라인보다 15배 빠르고, 멜로디, 화성, 리듬 지표에서 더 뛰어난 음악 일관성과 가사 정렬을 실현했습니다. 또한 음성 클로닝, 가사 편집 등 고급 제어 메커니즘을 지원하며, 모델이 출력의 일관성 부족, 특정 스타일에서의 낮은 성능 등의 한계를 가지고 있다는 점도 명시되어 있습니다.
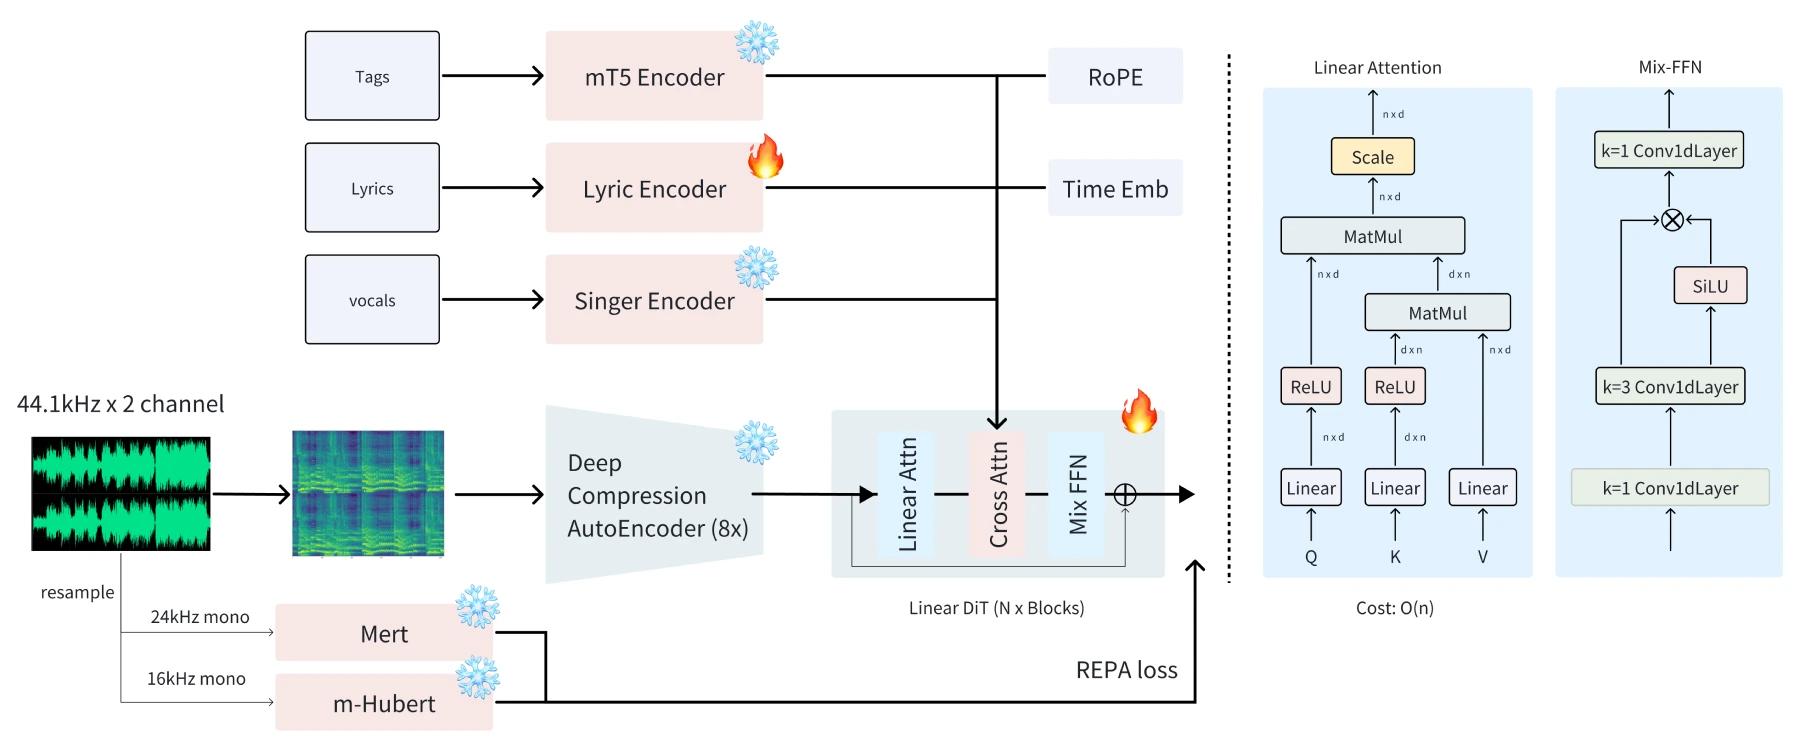
ACE-Step 핵심 아키텍처
ACE-Step은 확산 모델, 심층 압축 자동 인코더, 경량 선형 변환기를 통합하고, 학습 과정에서 MERT와 m-hubert를 활용한 의미 표현 정렬(REPA)을 통해 빠른 수렴을 달성합니다. 이러한 아키텍처 설계를 통해 생성 속도, 음악의 일관성, 제어성 사이의 균형을 이룰 수 있게 되었습니다.
ACE-Step의 장점
생성 속도: ACE-Step은 NVIDIA A100 GPU에서 단 20초 만에 최대 4분 길이의 음악을 생성할 수 있으며, 대규모 언어 모델(LLM) 기반 베이스라인 방법보다 15배 빠릅니다.
음악 일관성: 이 모델은 멜로디, 화성, 리듬 지표에서 우수한 음악 일관성과 가사 정렬 능력을 보여줍니다.
디테일 보존: ACE-Step은 미세한 음향학적 디테일을 보존하며, 음성 클로닝, 가사 편집, 리믹스, 트랙 생성과 같은 고급 제어 메커니즘을 지원합니다.
ACE-Step 기능 특징
다양한 스타일: 주요 음악 스타일을 지원하며, 짧은 태그, 설명 텍스트, 적용 시나리오 설명과 같은 다양한 설명 형식을 처리할 수 있고, 실험적 입력 테스트에서도 좋은 성능을 보이며, 여러 악기의 기악 곡도 생성할 수 있습니다.
다국어 지원: 19개 언어를 지원하지만, 데이터 불균형의 영향을 받아 일부 언어는 성능이 다소 부족하며, 성능이 비교적 좋은 상위 10개 언어에는 영어, 중국어, 러시아어 등이 포함됩니다.
강력한 제어성:
Variations Generation: 학습이 필요 없는 추론 시 최적화 기술을 활용하여, 초기 노이즈와 새로 추가되는 가우시안 노이즈의 혼합 비율을 조절함으로써 원곡과 유사도가 다른 변형 곡을 생성합니다.
Repaint: 대상 오디오 입력에 노이즈를 추가하고 ODE 과정에 마스킹 제약 조건을 적용하여 특정 부분을 수정할 수 있으며, 변형 생성 기술과 결합하여 부분적인 스타일, 가사 또는 보컬 변화를 구현할 수도 있습니다.
Edit: flow-edit 기술을 활용하여 멜로디, 보컬 음색, 배경 음악을 변경하지 않고도 가사를 수정할 수 있지만, 한 번에 소량의 가사만 수정할 수 있습니다.
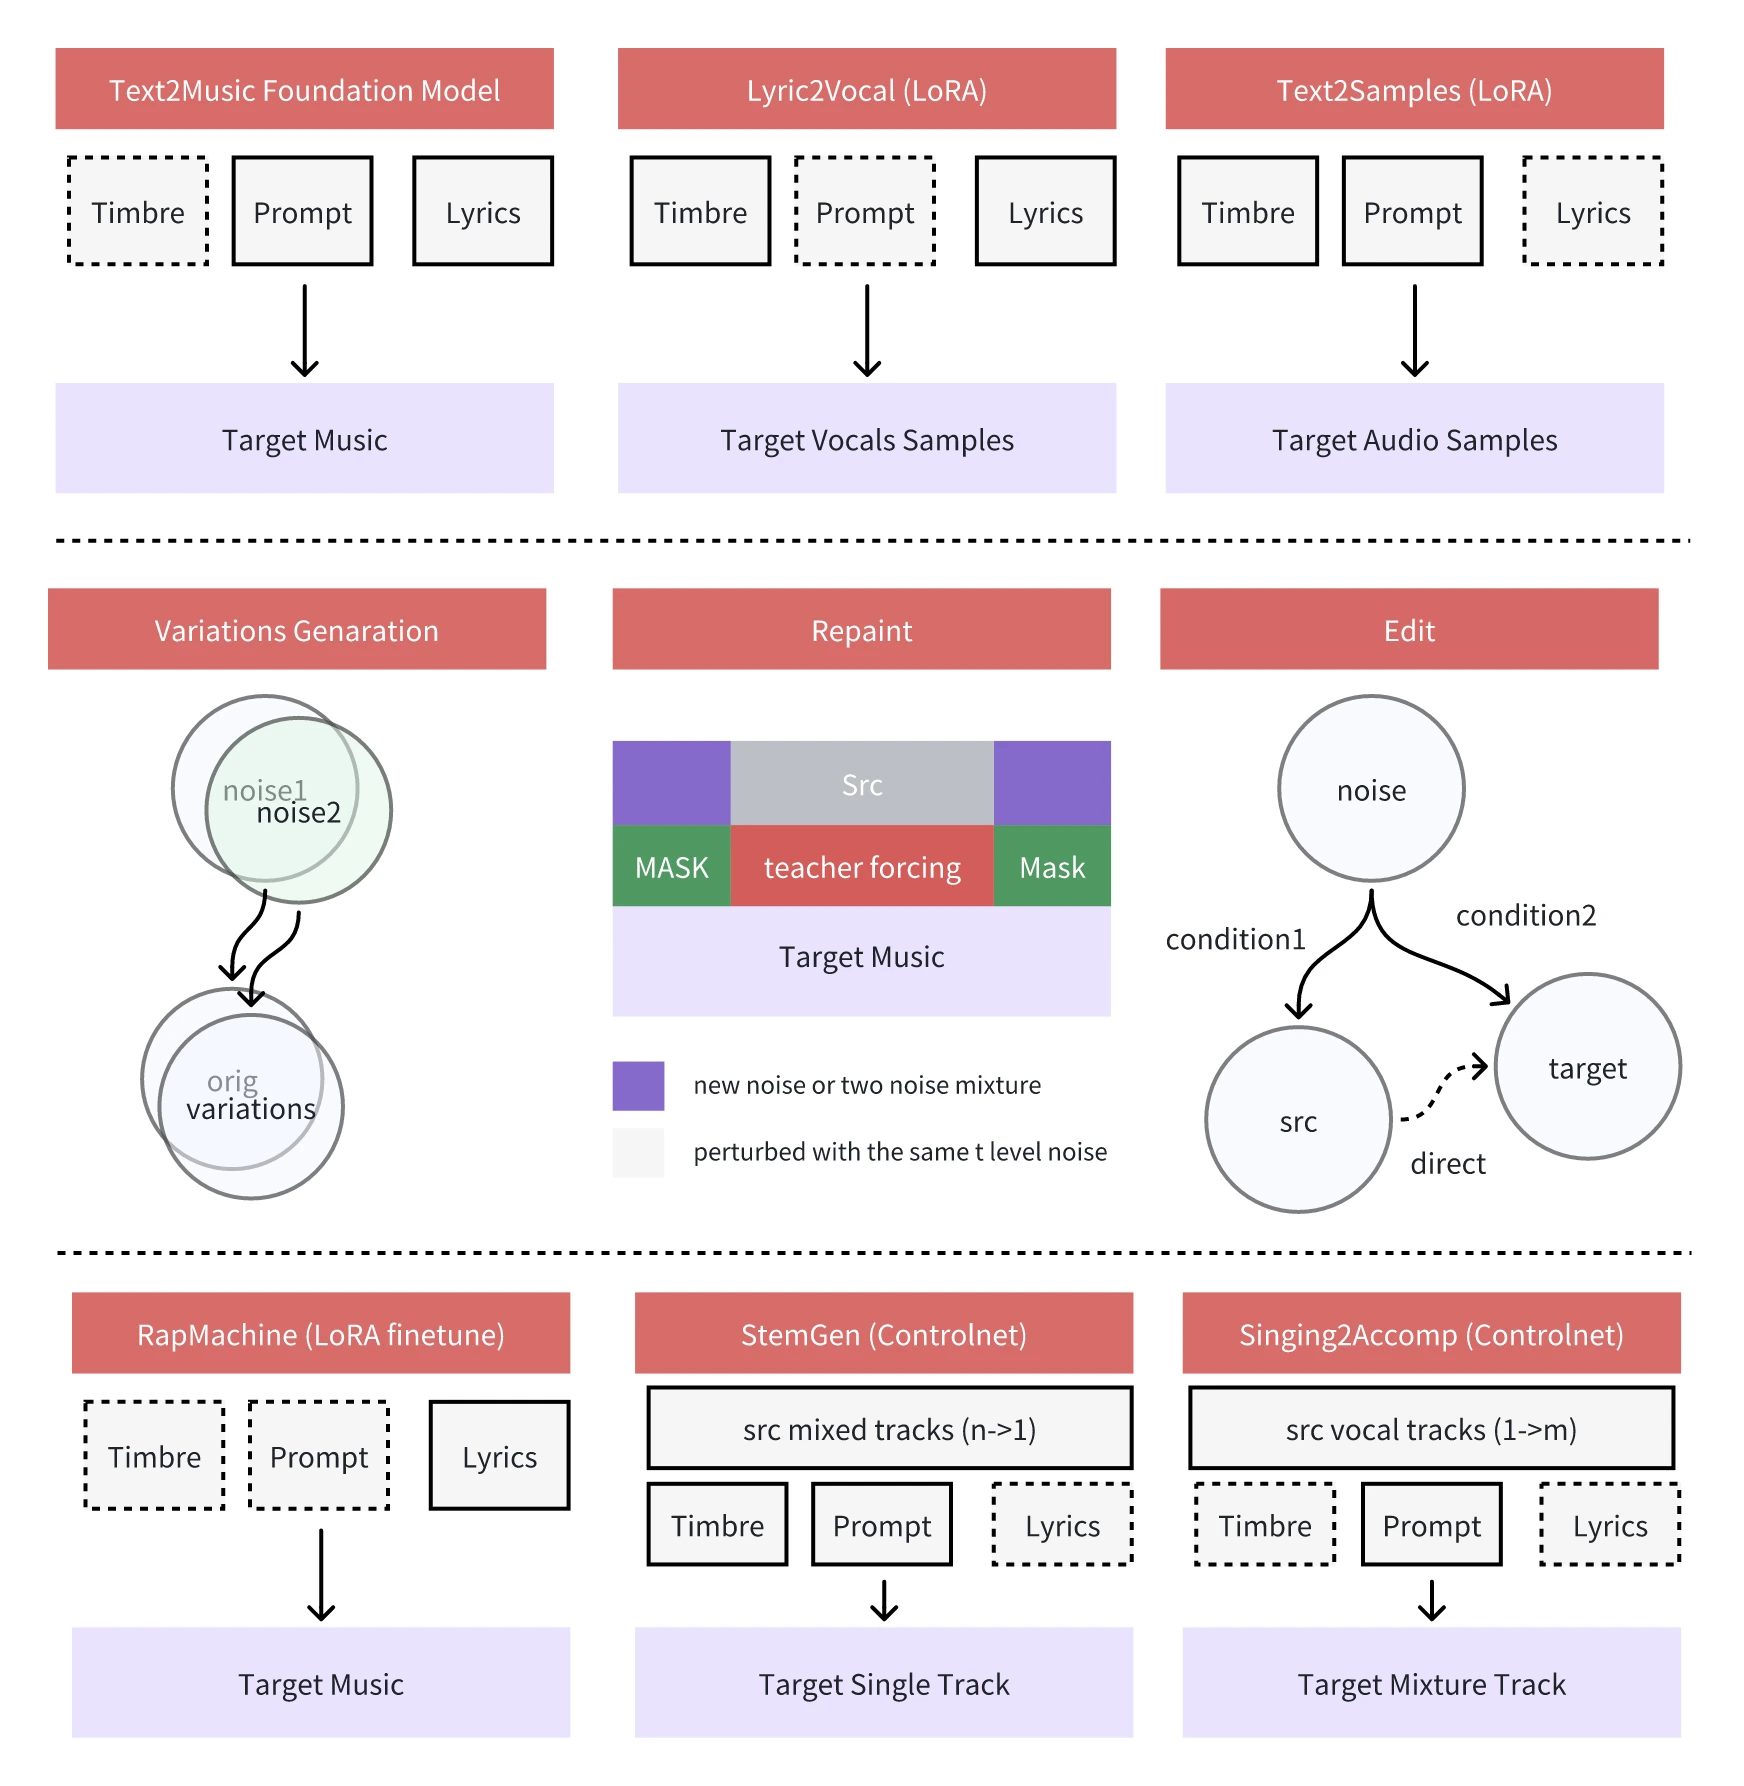
ACE-Step 적용 시나리오
Lyric2Vocal (LoRA): 순수 보컬 데이터를 기반으로 한 LoRA 미세 조정을 통해 가사에서 직접 보컬 샘플을 생성하여, 보컬 데모, 작곡 보조 등에 사용됩니다.
Text2Samples (LoRA): 순수 악기 및 샘플 데이터를 기반으로 한 LoRA 미세 조정을 통해 텍스트 설명에 따라 개념적 음악 제작 샘플을 생성하여, 악기 루프, 음향 효과 등을 만드는 데 사용됩니다.
ACE-Step의 한계
출력의 일관성 부족: 랜덤 시드와 입력 길이에 민감하여 결과가 안정적이지 않습니다.
스타일별 불균일한 성능: 특정 스타일(예: 중국어 랩)에서 성능이 다소 부족합니다.
연속성 문제: 리페인팅 또는 확장 작업 시 전환이 자연스럽지 않습니다.
보컬 품질 개선 필요: 합성된 보컬이 다소 거칠고 디테일이 부족합니다.
제어의 세분성 부족: 더 정밀한 음악 매개변수 제어가 필요합니다.
다국어 가사 최적화: 다국어 가사에 대한 지원, 정확성 및 자연스러움 향상이 필요합니다.
ACE-Step 자주 묻는 질문
ACE-Step이 다른 음악 생성 모델과 비교했을 때 가장 큰 장점은 무엇인가요?
답변: ACE-Step의 가장 큰 장점은 기존 모델이 안고 있던 생성 속도, 음악 일관성, 제어성 사이의 트레이드오프 문제를 해결했다는 점입니다. 이 모델은 A100 GPU에서 20초 이내에 최대 4분 길이의 음악을 합성할 수 있으며, LLM 기반 베이스라인 모델보다 15배 빠르고, 동시에 멜로디, 화성, 리듬 지표에서 더 뛰어난 음악 일관성과 가사 정렬을 실현합니다. 또한 음성 클로닝, 가사 편집 등 강력한 제어 기능을 갖추고 있어, 이러한 기능들을 다른 모델이 동시에 구현하기는 어렵습니다.
ACE-Step의 다국어 지원 측면에서 어떤 문제가 있나요?
답변: ACE-Step은 19개 언어를 지원하지만, 데이터 불균형의 영향을 받아 자주 사용되지 않는 언어는 성능이 다소 부족합니다. 다국어 가사를 처리할 때 정확성과 자연스러움이 개선될 여지가 있으며, 다양한 언어에서의 전반적인 성능 향상을 위해 다국어 가사 지원에 대한 추가 최적화가 필요합니다.
ACE-Step의 적용 시나리오에서 Lyric2Vocal과 Text2Samples는 각각 어떤 창작 단계에 적합한가요?
답변: Lyric2Vocal은 순수 보컬 데이터를 기반으로 한 LoRA 미세 조정으로, 곡 창작 과정의 보컬 데모 단계에 적합하여 창작자가 가사演唱 효과를 빠르게 테스트하는 데 도움을 주며, 가이드 트랙 제작, 곡 창작 보조, 보컬 편곡 실험에도 활용할 수 있습니다. Text2Samples는 순수 악기 및 샘플 데이터를 기반으로 한 LoRA 미세 조정으로, 음악 제작 초기 단계에서 악기 루프, 음향 효과 및 다양한 음악 요소를 신속하게 생성하는 데 적합하며, 개념적 샘플을 제공하여 음악 제작의 창작 효율을 높여줍니다.
관련 링크
https://ace-step.github.io/









